wikipedia-2001-2019
收藏资源简介:
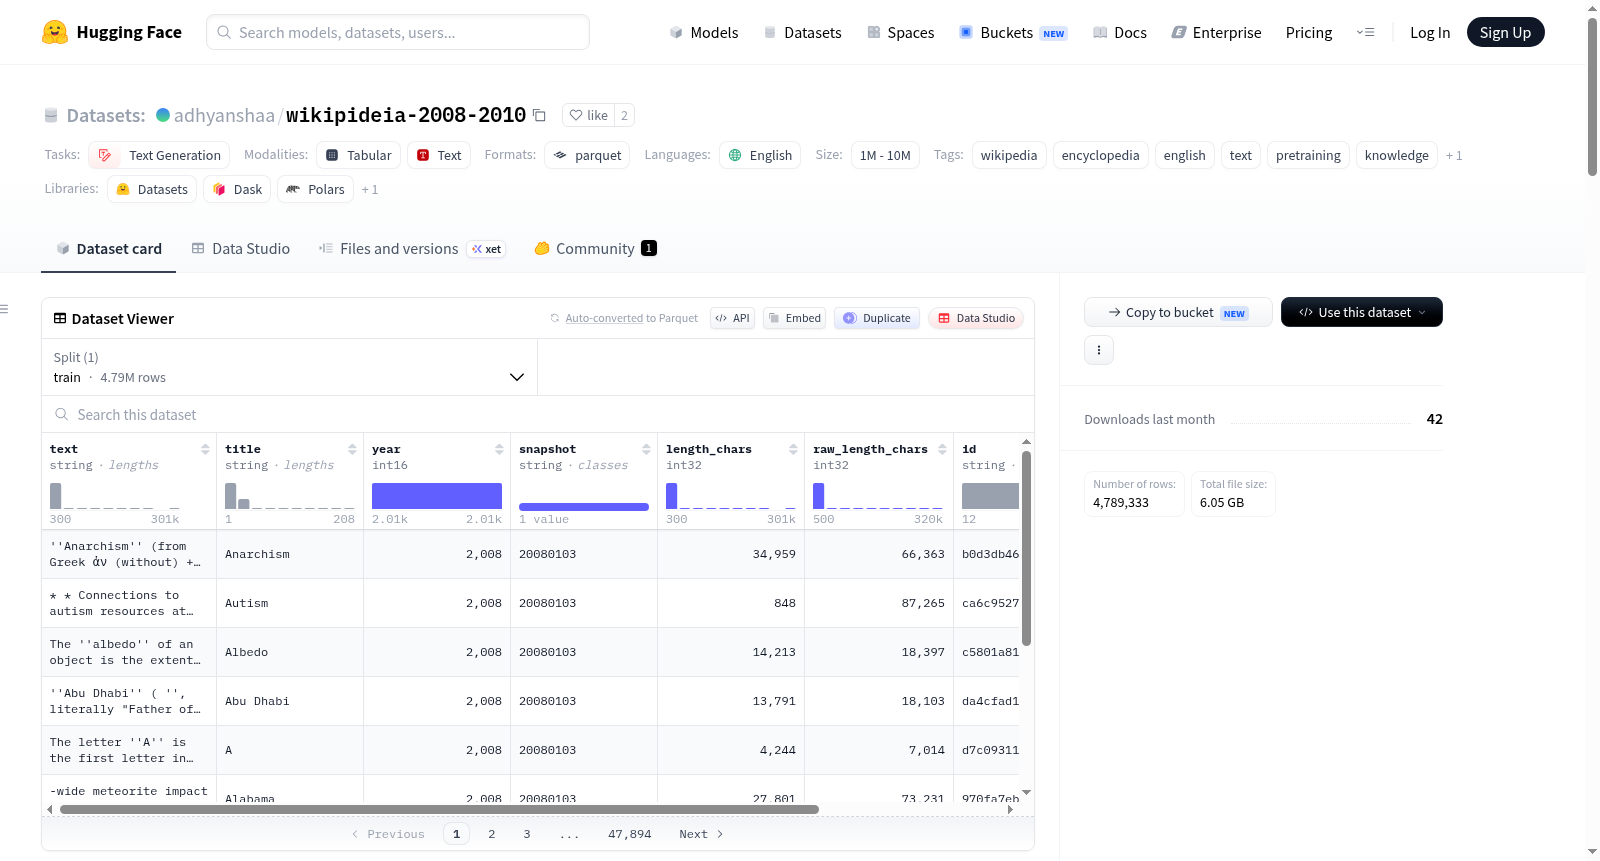
Wikipedia 2008 & 2010数据集是一个精心整理的英语文本数据集,基于维基百科2008年和2010年两个快照时期的文章,共收录约479万篇文章,旨在为大规模语言模型预训练提供高效、干净的知识语料。数据集分为两个分片:wiki_2008包含1,903,473篇文章(压缩后2.43 GB),wiki_2010包含2,885,860篇文章(压缩后3.63 GB),总计压缩大小约6.05 GB。数据以Parquet格式存储,采用zstd压缩,相比原始JSONL格式节省约60%存储空间,支持快速列式读取和流式处理。每个样本包含清理后的文章正文内容、文章标题、快照年份、转储标识符、清理后的字符数、清理前的原始字符数、唯一的十六进制文章标识符以及数据转换时间戳。该数据集适用于文本生成模型的预训练,并为研究维基百科知识随时间的演化(时间分析)提供资源。原始数据来源于维基百科XML转储文件,经过提取、去除Wiki标记和保留元数据等处理,遵循CC BY-SA 4.0许可证,使用时需注明来源并归属维基百科和维基媒体基金会。
数据集概述:Wikipedia 2008 & 2010
该数据集是一个精选的维基百科文章集合,包含 479 万篇文章,涵盖 2008 年和 2010 年的快照版本。数据经过清洗和压缩,适用于大规模语言模型的预训练,同时也为时间序列分析、知识演化研究和基础模型训练提供了宝贵的资源。
数据集统计
| 数据划分 | 文章数量 | 压缩后大小 | 原始 JSONL 大小 |
|---|---|---|---|
wiki_2008 |
1,903,473 | 2.43 GB | 5.70 GB |
wiki_2010 |
2,885,860 | 3.63 GB | 8.65 GB |
| 总计 | 4,789,333 | 6.05 GB | 14.35 GB |
格式与模式
- 存储格式:Parquet 文件,采用 zstd 压缩,相比原始 JSONL 节省约 60% 的空间,同时支持快速列式读取和流式传输。
- 数据模式:包含以下字段:
text:清洗后的文章正文内容title:文章标题year:快照年份(2008 或 2010)snapshot:具体的数据转储标识符length_chars:清洗后的字符数raw_length_chars:剥离之前的原始字符数id:唯一的十六进制文章标识符processed_at:转换时的 ISO 时间戳
使用方法
用户可以直接从 Hugging Face 流式加载数据集,无需下载完整的 6GB 数据。示例代码如下:
python from datasets import load_dataset
流式加载 2008 年文章
ds_2008 = load_dataset("adhyanshaa/wikipideia-2008-2010", split="wiki_2008", streaming=True)
或加载 2010 年数据划分
ds_2010 = load_dataset("adhyanshaa/wikipideia-2008-2010", split="wiki_2010", streaming=True)
for article in ds_2008: print(article["title"], len(article["text"])) break
数据来源与处理
- 来源:原始数据来自维基百科的 XML 转储文件(2008 年和 2010 年快照)。
- 处理流程:提取文章内容,剥离 Wiki 标记,保留元数据。转换流程使用流式 PyArrow,并采用原子写入和行数验证,确保从 JSONL 到 Parquet 的转换过程中数据零丢失。
许可证
该数据集采用 CC BY-SA 4.0 许可证发布,以保持与原始维基百科内容许可证的一致。在用于模型训练或重新分发时,需要注明维基百科和维基媒体基金会的来源。