
遇见数据集

overthelex/indian-court-decisions

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

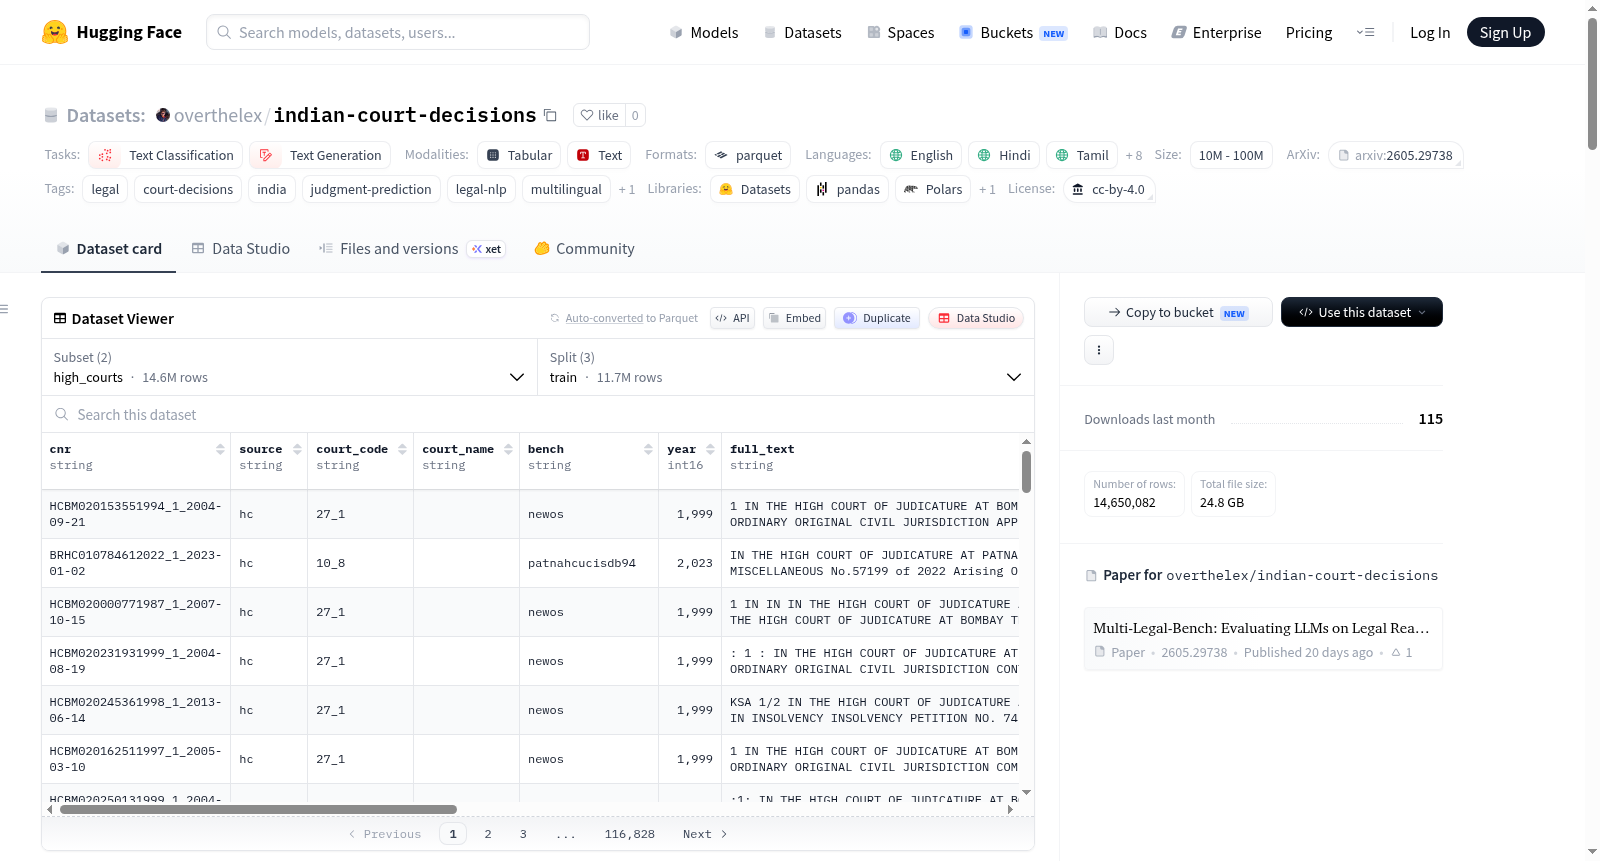
Indian Court Decisions 是一个大规模印度法院判决数据集,包含完整文本、元数据和结果标签,覆盖印度最高法院和25个高等法院的判决(时间范围为1950年至2026年)。该数据集是最大的公开法律NLP数据集之一,拥有超过1460万条法院判决记录,提取了全文内容。它涵盖了75年来的印度法理学,涉及所有主要法院,包括高等法院和最高法院的具体配置(例如,高等法院配置有11,682,776条训练记录,最高法院配置有40,044条训练记录)。数据集支持多种语言,主要为英语,但也包括印地语、泰米尔语、泰卢固语、卡纳达语、马拉地语、孟加拉语、马拉雅拉姆语、古吉拉特语、奥里亚语和旁遮普语等印度语言。字段包括案例编号、法院代码、法院名称、法官、全文文本、文本长度、标题、当事人信息、判决日期、处置性质和标准化结果标签等。结果标签涵盖多种类别,如驳回、处置、允许、部分允许、撤回、关闭、保释批准、保释拒绝、撤销、转移、和解、命令和其他。数据集可用于判决预测、法律文本分类、时间分析、跨司法管辖区比较、法律语言建模和信息检索等应用。数据来源于AWS开放数据注册表,由Dattam Labs提供,原始数据收集自eCourts和印度最高法院。

Indian Court Decisions is a large-scale dataset of Indian court decisions with full text, metadata, and outcome labels covering the Supreme Court of India and 25 High Courts (1950–2026). It is one of the largest publicly available legal NLP datasets, containing over 14.6 million court decisions with extracted full text. The dataset covers 75 years of Indian jurisprudence across all major courts, including specific configurations for High Courts (e.g., 11,682,776 training records) and Supreme Court (e.g., 40,044 training records). It supports multiple languages, primarily English, but also includes Hindi, Tamil, Telugu, Kannada, Marathi, Bengali, Malayalam, Gujarati, Odia, and Punjabi. Fields include case number, court code, court name, judge, full text, text length, title, petitioner, respondent, decision date, disposal nature, and normalized outcome labels. Outcome labels cover categories such as dismissed, disposed, allowed, partly allowed, withdrawn, closed, bail granted, bail rejected, quashed, transferred, settled, ordered, and other. The dataset is useful for judgment prediction, legal text classification, temporal analysis, cross-jurisdictional comparison, legal language modeling, and information retrieval. Data is sourced from the AWS Open Data Registry by Dattam Labs, with original data collected from eCourts and the Supreme Court of India.
提供机构:
overthelex
搜集汇总
数据集介绍
overthelex/indian-court-decisions 数据集图片
构建方式
Indian Court Decisions 数据集由 Dattam Labs 从 eCourts 门户及印度最高法院官方网站系统采集而来,收录了自1950年至2026年间印度最高法院与25个高等法院的判决文书。数据经过提取、清洗与结构化处理,保留包含至少1000字符的完整判决文本,并标注了案件编号、法院名称、审判年份、法官组成、当事人信息及案件类型等元数据。判决结果被归一化为11个标准标签(如驳回、允许、部分允许、保释获准等),以支持下游分类任务。数据集基于案件编号的MD5哈希值按80/10/10比例划分为训练、验证与测试集,确保划分的确定性与可复现性,无需在内存中对逾千万条记录进行随机打乱。
特点
该数据集是目前公开可获取的规模最大的法律自然语言处理数据集之一,包含超过1460万条判决记录,覆盖印度主要司法管辖区。除英语外,还包含印地语、泰米尔语、泰卢固语等10种印度语言撰写的判决,展现出显著的多语言特性。元数据字段丰富,提供法庭名称、审判年份、法官姓名、案件类型等关键信息,并引入归一化后的判决结果标签,便于进行结果预测、文本分类等任务。判决文本长度充足,最低字数门槛确保内容完整性。数据集还涵盖75年的时间跨度,为法律推理演化与跨司法管辖区比较分析提供了宝贵资源。
使用方法
该数据集通过 Hugging Face Datasets 库加载,提供 `high_courts` 和 `supreme_court` 两个配置,分别对应高等法院与最高法院的数据子集,用户可按需选择。数据集可直接用于文本分类、文本生成等任务,尤适用于判决结果预测、案件类型识别、法律语言模型预训练与微调。研究人员亦可利用时间与法院字段进行时序分析与跨地区对比研究。数据以 Parquet 格式存储,支持高效读取与批量处理。引用时需注明原始论文《Multi-Legal-Bench: Evaluating LLMs on Legal Reasoning Across Jurisdictions, Languages, and Legal Traditions》并遵循 CC-BY-4.0 许可证。
背景与挑战
背景概述
印度司法体系承载着世界上最庞大的案件积压量之一,亟需借助自然语言处理技术实现智能化裁判辅助。2026年,由Volodymyr Ovcharov等研究者构建的Indian Court Decisions数据集应运而生,该数据集收录了自1950年至2026年间印度最高法院及25个高等法院超过1460万份判决书,涵盖文本、元数据及裁判结果标签,成为法律NLP领域公开可用的最大规模语料库。依托于eCourts平台与AWS开放数据注册表,该数据集为跨法域推理、裁判预测及多语言法律文本分析提供了坚实基础,推动了法律人工智能在印度乃至全球司法场景中的发展。作为Multi-Legal-Bench基准的核心组件,它深刻影响了法律大语言模型的评估范式,促进了法律推理能力的标准化研究。
当前挑战
该数据集面临的挑战涵盖法律知识表征与数据工程两大层面。在领域问题方面,法律文本存在高度结构化与冗长性,裁判结果预测需精准建模事实、法条与法官自由裁量权间的复杂关系;同时,多语言判决(含10种印度语言)的融合处理以及跨25个高等法院的司法同义现象,对模型泛化能力构成严峻考验。在构建过程中,原始数据源自非结构化法庭记录,面临文本噪音、判决书格式不统一及元数据缺失等难题;此外,超过1460万份样本的确定性划分(基于CNR标识符的哈希分割)需平衡类分布不均与多样性,而标签归一化(如将disposed、allowed等原始类别映射为标准化结果)亦需法律专家介入以确保分类准确性。
常用场景
经典使用场景
Indian Court Decisions数据集最经典的应用场景集中在法律自然语言处理领域,尤其适用于判决预测任务。研究者可利用案件的完整事实文本,结合标准化的结果标签(如允许、驳回、部分允许等),构建能够预测司法裁决走向的深度学习模型。该数据集涵盖印度最高法院及25个高等法院1950年至2026年间逾1460万份判决,规模宏大、时间跨度长,为训练高精度判决预测系统提供了无与伦比的语料基础。此外,其多语言特性(涵盖英语及十种印度本土语言)使其成为跨语言法律文本分类、判例检索以及司法推理建模的理想基准,在推动法律人工智能迈向实用化方面扮演了关键角色。
解决学术问题
该数据集的提出有效回答了法律NLP研究中长期存在的数据稀缺与领域单一化难题。此前,公开可用的法律判决数据集多限于单一法域或极少量样本,难以支撑对复杂司法现象的统计学推断与深度模型训练。Indian Court Decisions凭借其跨75年、覆盖多种法院层级和案件类型的庞大体量,使得学者得以系统性地探究司法推理的时间演变、地区差异以及结果倾向性。它解决了诸如“判决结果是否受法院层级影响”“不同时期的裁判风格如何变化”等深层次法理学问题,并为大规模预训练法律语言模型提供了高质量数据,显著推动了法律文本自动理解与生成领域的学术进展。
衍生相关工作
基于Indian Court Decisions数据集,学术界已衍生出一系列具有影响力的研究工作。Multi-Legal-Bench(Ovcharov, 2026)是该数据集的奠基性应用,通过设计跨法域、跨语言的法律推理评测集,系统评估了大语言模型在多国法律体系下的表现。后续工作聚焦于法律语言模型的域内预训练与微调,如利用该数据集的完整文本对LLaMA、BERT等架构进行法律领域适配,显著提升了模型在法律问答、判决摘要生成等任务上的效果。此外,该数据集还催生了针对印度司法系统判决一致性的量化分析研究,以及将判决预测与可解释AI结合的前沿探索,为构建透明、可信的司法AI奠定了实验基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

