
TomatitoToho/nanbeige-dc-dataset
收藏官方服务:
资源简介:
用于将Nanbeige4.1-3B微调成Discord专用聊天机器人(Zelin DC v6.0)的训练数据。
Training data for fine-tuning Nanbeige4.1-3B into a Discord-specialized chatbot (Zelin DC v6.0).
提供机构:
TomatitoToho搜集汇总
数据集介绍
构建方式
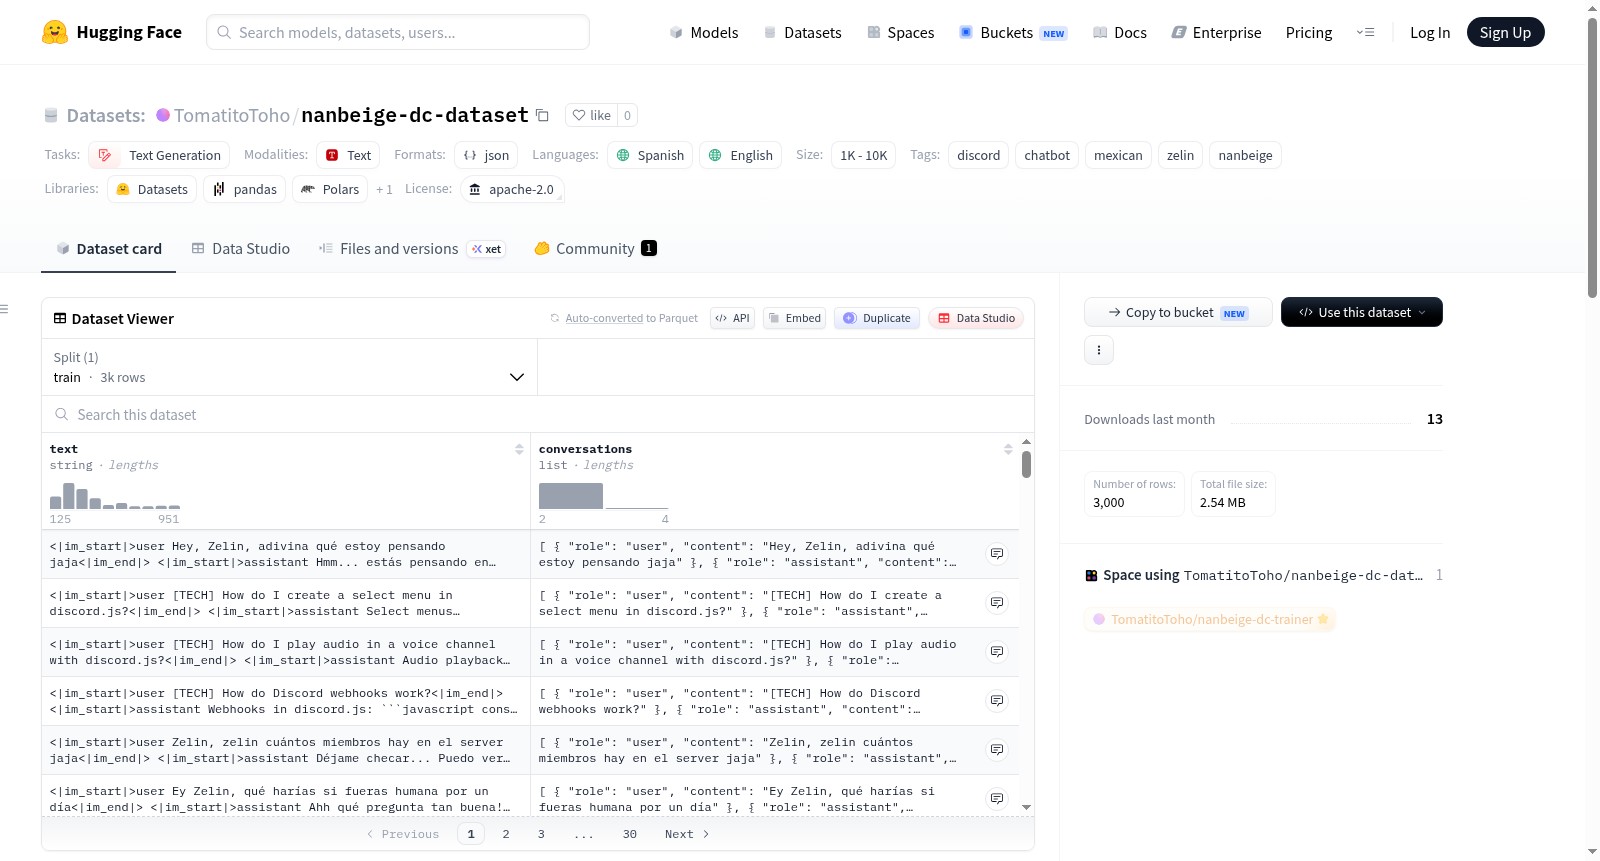
本数据集专注于将Nanbeige4.1-3B模型微调为面向Discord平台的专业聊天机器人。构建过程首先通过自动生成脚本与人工筛选相结合的方式,产生覆盖个性、审核、命令、技术、AI路由、角色扮演、情感及变体等八个类别的训练样本。数据以ChatML格式组织,共计包含3000条示例,每条样本均由用户提问与助手回复构成,能够有效模拟真实的对话流。
特点
该数据集具备鲜明的领域定制化特征,尤其聚焦于墨西哥少女风格的AI人格塑造,融入了丰富的俚语与文化背景。样本在类别分布上精心设计,既包括约800条人格类对话以强化角色一致性,也涵盖近1400条变体数据以提升模型应对多样提示的泛化能力。此外,数据集还嵌入Discord特有功能如斜杠命令与审核策略,体现了极强的场景适配性。
使用方法
使用者可直接利用提供的Google Colab笔记本或Kaggle笔记本进行模型微调,操作流程极为便捷。只需加载数据集中的dc_train_chatml.jsonl文件,配合Nanbeige4.1-3B架构,即可通过脚本启动训练,并借助Hugging Face凭据将微调后的模型上传至指定仓库。便携式训练脚本train_dc_portable.py亦支持本地环境运行,满足不同计算资源下的部署需求。
背景与挑战
背景概述
随着大型语言模型(LLM)在对话系统中的应用日益广泛,针对特定场景的微调数据集成为提升模型专业性与用户交互体验的关键。Nanbeige-DC数据集由研究者TomatitoToho于近期创建,旨在将Nanbeige4.1-3B模型微调为专注于Discord平台的聊天机器人(Zelin DC v6.0)。该数据集包含约3000条训练样本,覆盖人格塑造、内容审核、命令响应、技术知识、角色扮演及情感智能等八大类别,特别融入了墨西哥少女AI人格的俚语与文化元素,为跨文化对话AI的研究提供了独特的资源。其发布的配套训练脚本与Colab/Kaggle notebook极大地降低了社区复现与二次开发的门槛,对个性化聊天机器人及社区管理自动化领域具有显著的推动意义。
当前挑战
该数据集主要挑战在于解决通用语言模型对Discord社区特有社交规范与亚文化语境的理解不足问题。具体而言,数据集需引导模型掌握墨西哥西班牙语俚语、模因文化及多样化情感表达,同时应对垃圾信息、NSFW内容、社区攻击等审核场景的精准判别。在构建过程中,面临数据稀疏性难题,例如仅200条样本需覆盖复杂的审核逻辑,且角色扮演和情感支持类样本需保证拟人化与安全性的平衡。此外,生成脚本需从海量Discord对话中抽取高质量示例,并避免隐私泄露,对数据清洗与格式统一提出了较高要求。
常用场景
经典使用场景
在对话式人工智能的研究与开发中,针对特定平台与用户群体的个性化微调数据集扮演着至关重要的角色。nanbeige-dc-dataset 是一个专为将 Nanbeige4.1-3B 基座模型精调为 Discord 平台专属聊天机器人(Zelin DC v6.0)而设计的训练数据集。其最经典的使用场景在于为开发者提供一套完整的、面向墨西哥西班牙语文化背景的社交机器人训练方案,涵盖从数据生成、模型微调到部署上线的全流程。通过该数据集,研究者能够高效地将通用大语言模型转化为一个深谙当地俚语、网络文化及社交礼仪的活泼少女 AI 助手,尤其适用于 Discord 社群中需要高情商互动、角色扮演及指令遵循的复杂对话环境。
解决学术问题
在自然语言处理与对话系统领域,如何使大语言模型在低资源语言和文化背景下实现高贴合度的个性化表达,一直是颇具挑战的学术问题。该数据集创新性地将文化特异性(墨西哥西语俚语与表情符号)、平台约束(Discord 平台指令与风控规则)与情感智能三大核心要素融为一体,填补了针对特定社交平台亚文化和地域语言进行精细调优的研究空白。它有效解决了通用模型在面对非英语母语环境下的文化误读、风格僵化以及无法处理社区特有的内容审核(如垃圾信息、NSFW 内容降级)等痛点,为探索多语言、多文化场景下的模型人格化注入与安全对齐提供了极具参考价值的数据基准和实证基础。
衍生相关工作
围绕该数据集的工作模式,衍生出了一系列具有启发意义的研究与实践方向。基于其“小数据高文化浓度”的微调策略,后续研究者借鉴了其 ChatML 格式的多轮对话模板,开发了针对 Twitch、Telegram 等不同平台的跨平台人格迁移数据集。此外,数据集中展示的“类别平衡设计”(如情感、审核、技术指令等模块)启发了关于多任务学习在对话生成中如何避免灾难性遗忘的探讨。与之相关的经典工作还包括将墨西哥地区特有的“reaction role”和“slash commands”逻辑抽象为通用框架,实现了开放式语言模型与封闭式平台 API 的高效对接,这一思路在后续的 Discord AI 代理开源项目中被广泛沿用和迭代。
以上内容由遇见数据集搜集并总结生成


