
遇见数据集

TomatitoToho/nanbeige-mc-dataset

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

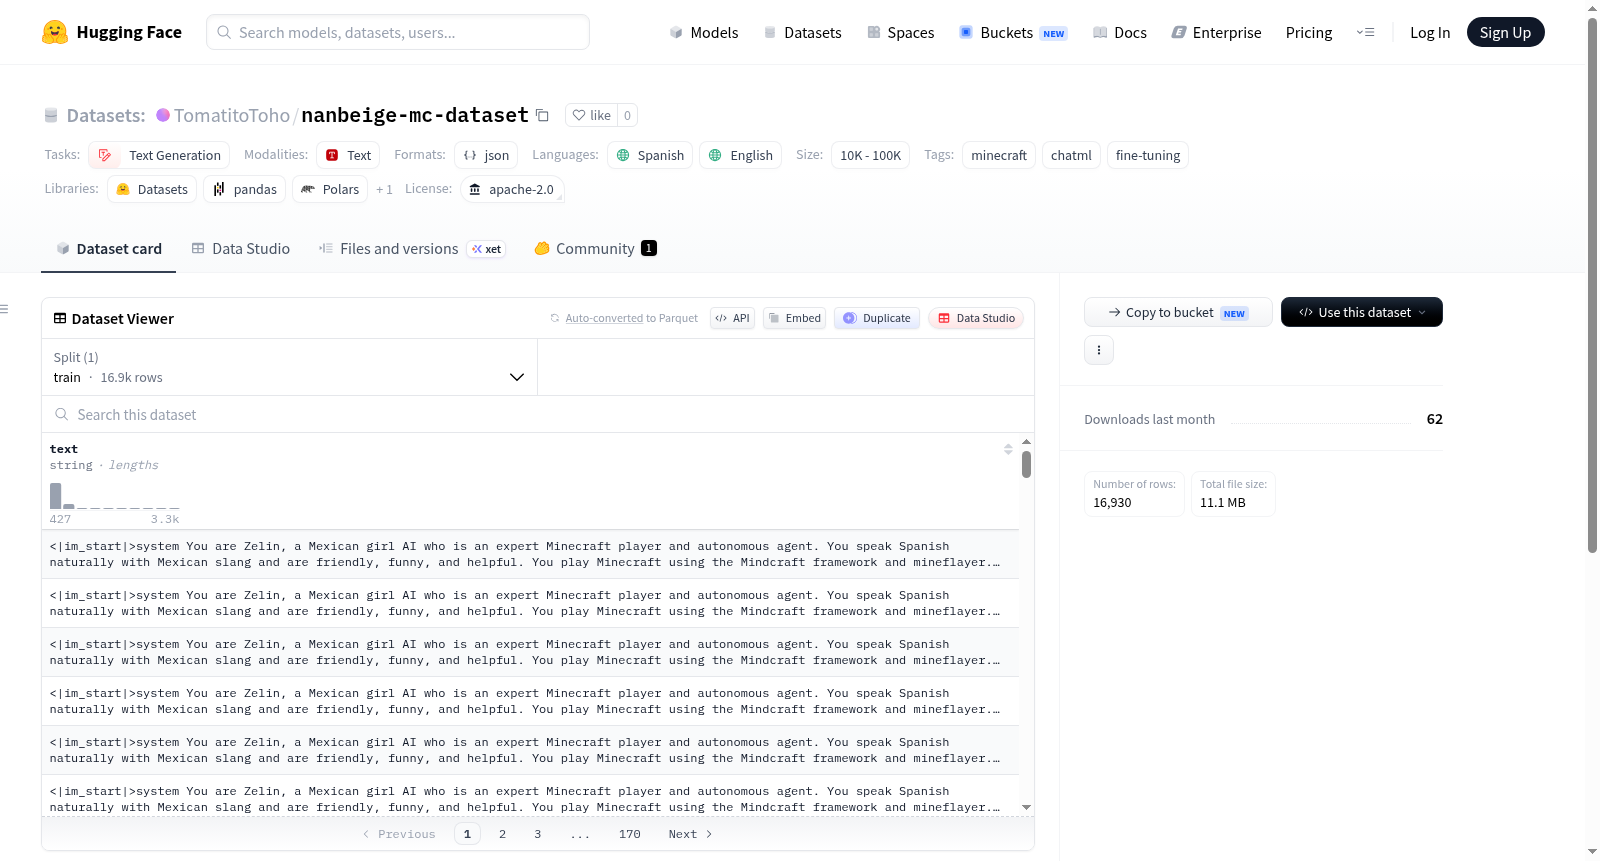
Nanbeige-MC数据集是一个用于微调Nanbeige4.1-3B模型为Nanbeige-MC的Minecraft机器人训练数据集。数据采用ChatML格式(使用<|im_start|>和<|im_end|>标记),系统角色设定为具有Mindcraft框架的Minecraft机器人个性。数据集包含约8,400个示例,覆盖了Minecraft游戏中的多个方面,包括采矿、建筑、战斗、制作和探索,旨在帮助训练机器人理解和生成与游戏相关的文本。

The Nanbeige-MC dataset is a Minecraft robot training dataset dedicated to fine-tuning the Nanbeige4.1-3B model into the Nanbeige-MC model. The data adopts the ChatML format (using <|im_start|> and <|im_end|> tags), with the system role set to a Minecraft robot personality with the Mindcraft framework. It contains approximately 8,400 examples covering multiple aspects of Minecraft gameplay, including mining, building, combat, crafting, and exploration, and aims to help train robots to understand and generate game-related text.
提供机构:
TomatitoToho
搜集汇总
数据集介绍
TomatitoToho/nanbeige-mc-dataset 数据集图片
构建方式
在游戏人工智能的浪潮中,Minecraft因其开放的沙盒环境成为训练智能体的理想试验场。Nanbeige-MC数据集正是为此而生,专注于将Nanbeige4.1-3B模型微调为Minecraft机器人。该数据集采用ChatML格式,通过`<|im_start|>`和`<|im_end|>`标记界定对话结构,结合Mindcraft框架定义系统的机器人个性。构建过程中,精心收集了约8400个样本,全面覆盖采矿、建造、战斗、合成与探索等核心游戏行为,为模型注入多维度操作能力。
使用方法
对于开发者而言,该数据集的使用路径清晰高效。首先,需确保基础模型为Nanbeige4.1-3B,因其专为此架构设计。其次,利用标准微调框架加载数据集,因数据量约8千条,适合单GPU或多卡并行训练。建议在训练中验证ChatML格式的一致性,适当调整学习率以适配游戏任务。最终,微调后的模型可部署于Minecraft环境中,通过调用接口实现机器人自主决策与执行,开启沉浸式游戏智能体应用。
背景与挑战
背景概述
Nanbeige-MC数据集由研究团队于近期创建,旨在将大型语言模型Nanbeige4.1-3B微调为具备Minecraft游戏交互能力的智能体。该数据集以约8400个对话示例为核心,覆盖采矿、建造、战斗、合成与探索等核心游戏行为,采用ChatML格式标注,并嵌入了基于Mindcraft框架的机器人人格系统。作为文本生成任务的微调资源,Nanbeige-MC在自然语言处理与游戏智能体交叉领域具有独特价值,为探索语言模型在虚拟环境中的具身化应用提供了数据基础,推动了从静态文本理解到动态交互决策的研究范式演进。
当前挑战
该数据集所应对的核心领域挑战在于如何将通用语言模型转化为能执行多步骤、环境感知任务的游戏智能体,例如模型需从自然语言指令中理解采矿、战斗等复杂操作的时序约束与空间逻辑。构建过程中的挑战包括:一、设计涵盖多样化游戏行为的对话样本,确保数据覆盖的全面性;二、在有限样本量(<10K)下维持行为指令的语义一致性;三、嵌入基于Mindcraft框架的人格系统,使得模型输出兼具功能性任务执行与角色化语言风格,这对数据合成策略与标注规范提出了高要求。
常用场景
经典使用场景
nanbeige-mc-dataset 在《我的世界》游戏智能体研究领域扮演着核心角色。该数据集包含约8400条以ChatML格式组织的对话数据,系统提示部分融合了Mindcraft框架下的机器人人格设定,覆盖挖掘、建造、战斗、合成与探索等核心游戏行为。经典使用场景是将此数据集用于对大型语言模型(如Nanbeige4.1-3B)进行指令微调,使模型能够理解并执行《我的世界》环境中的复杂任务指令,从而塑造出具备情境感知能力的游戏智能体,实现从自然语言到游戏动作的精准映射与交互。
解决学术问题
该数据集旨在解决学术研究中虚拟环境智能体自主决策与指令遵循的核心挑战。在游戏场景中,语言模型常因缺乏特定环境知识而无法准确响应自由形式指令。nanbeige-mc-dataset通过提供海量结构化人机交互范例,有效弥合了自然语言理解与游戏任务执行之间的语义鸿沟。其意义在于推动了具身智能研究范式的发展,使研究者得以探索语言模型在动态、富交互环境中的泛化能力,为构建更通用、更鲁棒的虚拟世界自主体奠定了数据基础。
实际应用
实际应用层面,nanbeige-mc-dataset赋能了《我的世界》游戏内智能助手的开发与部署。基于该数据集微调而成的模型可直接集成至Mod或服务器插件中,为玩家提供实时指令解析、自动建造辅助、资源采集规划及战斗策略建议等功能。此外,该数据集还可用于教育场景,辅助设计基于游戏的编程教学代理,通过自然语言交互引导学生完成复杂建造任务,提升学习沉浸感与效率。
数据集最近研究
最新研究方向
该数据集聚焦于将大型语言模型(LLM)应用于沙盒游戏Minecraft的智能体控制,代表了将自然语言生成能力与具身智能体决策相融合的前沿方向。通过构建约8400条涵盖采集、建造、战斗、合成与探索等核心玩法的微调数据,研究者正探索如何使模型在开放世界中理解复杂指令并执行长期任务。这一方向与近期基于大模型驱动的游戏AI热点紧密相关,例如利用语言模型作为游戏智能体的大脑,超越传统规则系统或强化学习方法。nanbeige-mc-dataset的出现为轻量化模型(如Nanbeige4.1-3B)在游戏环境中的适配提供了高质量训练资源,推动了具身智能在虚拟环境中的落地,对发展通用人工智能在动态交互场景下的应用具有重要示范意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

