
rebase_thinkprm_gpt-oss-20b_rg_cognition_ns8_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu
收藏数据链接:
官方服务:
资源简介:
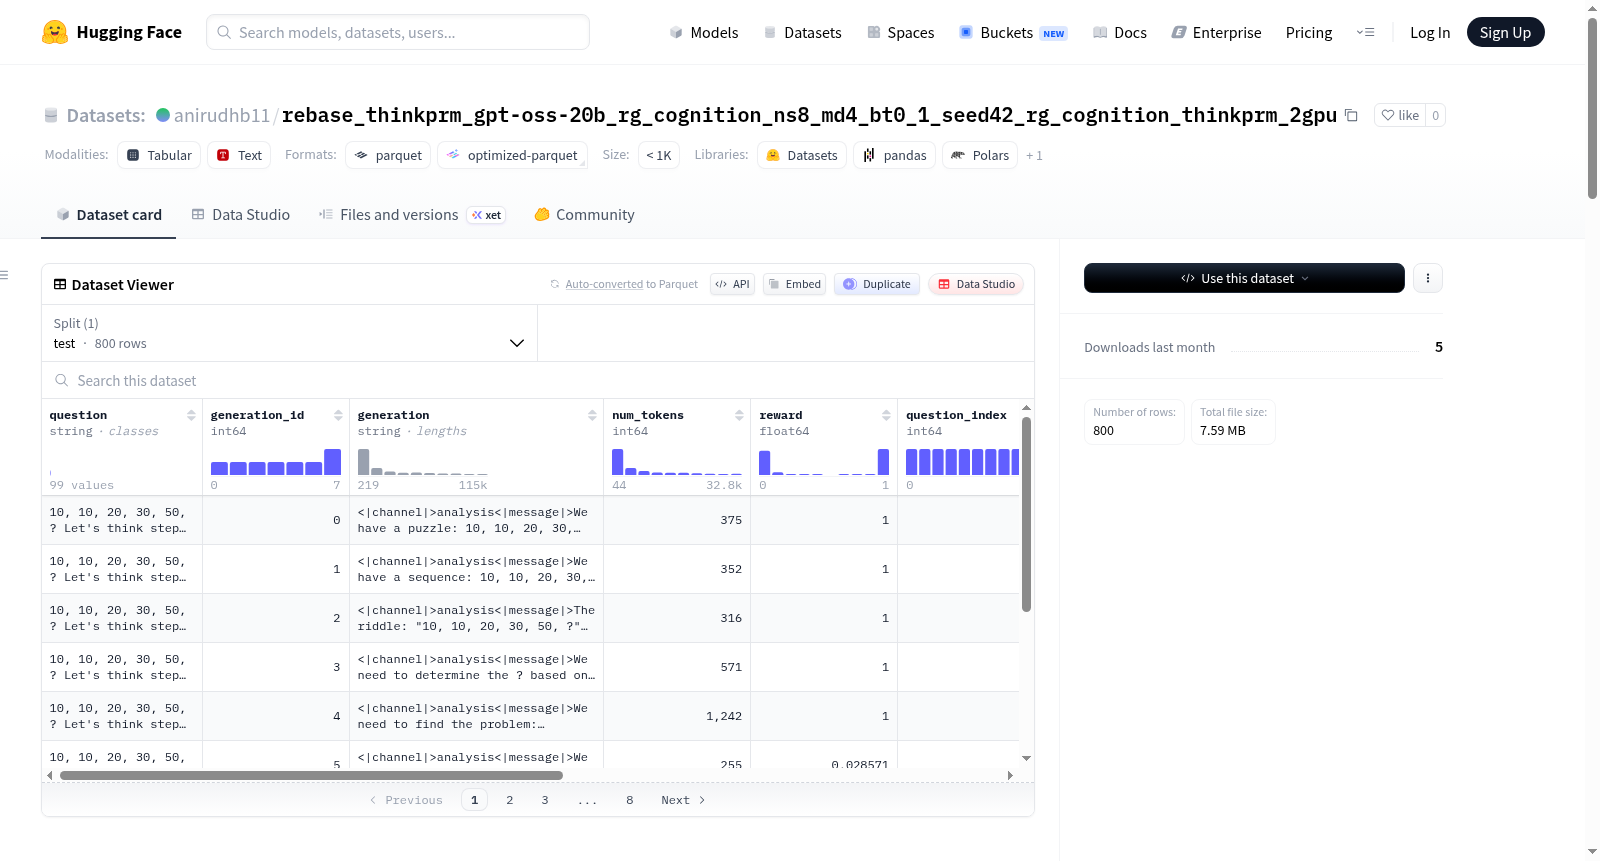
该数据集包含800个测试样本,每个样本包含多个特征字段:问题文本(question)、生成ID(generation_id)、生成内容(generation)、token数量(num_tokens)、奖励值(reward)、问题索引(question_index)、目标文本(target)、任务类型(task)、价值函数预测(vf_prediction)和难度等级(level)。数据集总大小为20MB,下载大小为7.5MB。从聚合指标来看,该数据集可能用于评估文本生成模型的性能,包含多种评估指标如不同样本量下的通过率(pass@1到pass@8)、唯一答案数量、响应token统计等。指标显示模型在不同配置下的表现,包括平均响应token为6463.56,总生成token达517150。
创建时间:
2026-05-07
原始信息汇总
根据您提供的数据集详情页面README文件内容,以下是为您整理的数据集概述:
数据集名称
anirudhb11/rebase_thinkprm_gpt-oss-20b_rg_cognition_ns8_md4_bt0_1_seed42_rg_cognition_thinkprm_2gpu
数据特征
数据集包含以下10个特征字段:
- question:字符串类型,问题文本
- generation_id:整型,生成ID
- generation:字符串类型,生成的回答
- num_tokens:整型,生成的token数量
- reward:浮点型,奖励值
- question_index:整型,问题索引
- target:字符串类型,目标答案
- task:字符串类型,任务名称
- vf_prediction:浮点型,价值函数预测值
- level:整型,层级标识
数据规模与划分
- 数据集总大小:20,197,221 bytes
- 下载大小:7,574,045 bytes
- 只有一个划分:test(测试集),包含 800 个样本
数据配置
- 配置名称:default
- 数据文件路径:
data/test-*(通配符匹配多个文件)
聚合指标(来自10个分片)
以下为加权平均后的关键性能指标:
| 指标类别 | 关键指标 | 数值 |
|---|---|---|
| 生成性能 | 平均响应Tokens | 6463.56 |
| 生成阶段耗时 | 764.79秒 | |
| 总耗时 | 932.02秒 | |
| 正确率 | Pass@1 | 0.47125 |
| Pass@2 | 0.55036 | |
| Pass@4 | 0.58914 | |
| Pass@8 | 0.62 | |
| 多数投票 | Maj@1 | 0.49273 |
| Maj@2 | 0.47608 | |
| Maj@4 | 0.53438 | |
| Maj@8 | 0.54327 | |
| 加权多数投票 | w_maj@1 | 0.49273 |
| w_maj@2 | 0.47813 | |
| w_maj@4 | 0.52615 | |
| w_maj@8 | 0.55895 | |
| 最佳加权 | w_best@1 | 0.49572 |
| w_best@2 | 0.49369 | |
| w_best@4 | 0.49873 | |
| w_best@8 | 0.49876 | |
| 唯一答案数 | num_unique_answers@1 | 0.921 |
| num_unique_answers@2 | 1.36 | |
| num_unique_answers@4 | 2.007 | |
| num_unique_answers@8 | 3.13 | |
| Token统计 | 总生成输出Tokens | 517,150 |
| 策略输出Tokens总计 | 517,150 | |
| Token计数 | 29,950 | |
| 评分时间 | ThinkPRM评分时间(层级1) | 122.95秒 |
| ThinkPRM评分时间(层级2) | 104.46秒 | |
| ThinkPRM评分时间(层级3) | 98.76秒 | |
| ThinkPRM评分时间(层级4) | 87.78秒 |
数据集用途
该数据集来源于强化学习训练过程,主要用于评估推理模型(Reasoning with Cognition)的性能。数据包含问题、生成回答、奖励信号、价值函数预测等信息,可用于分析模型在多个采样次数(Pass@k)和多数投票(Maj@k)等评估指标下的表现。
搜集汇总
数据集介绍
构建方式
该数据集基于ThinkPRM框架构建,采用GPT-OSS-20B模型作为策略模型,在数学推理任务中通过多阶段搜索生成推理轨迹。每条样本包括问题、生成结果、奖励值、价值函数预测及任务类型等字段,共包含800条测试样本。数据集的构建过程首先由策略模型输出搜索轨迹,随后利用过程奖励模型对每个搜索阶段进行评分,最终通过加权投票与多数投票等策略聚合生成最终答案。
特点
数据集的核心特点在于其丰富的元信息与多维度评估指标。每条数据不仅包含模型的原始输出轨迹,还记录了推理过程中的总生成token数、各搜索阶段的策略输出token数与评判输出token数,以及不同采样策略下的正确率(pass@k、maj@k等)。这些特征使得研究人员能够深入分析模型在数学推理中的行为模式、搜索效率与答案多样性,为改进推理策略提供了宝贵的数据支撑。
使用方法
数据集以JSON格式存储,可通过HuggingFace Datasets库直接加载使用。用户可利用'question'字段作为输入,'generation'字段获取模型输出,并结合'reward'与'vf_prediction'字段进行奖励建模或价值函数训练。此外,通过'level'字段可区分不同难度的推理任务,适用于评估模型在分层数学问题上的表现,或作为强化学习与偏好对齐研究的基准数据。
背景与挑战
背景概述
该数据集由研究团队基于强化学习与过程奖励模型(Process Reward Model, PRM)的理念构建,旨在提升大语言模型在数学推理等复杂认知任务中的性能。数据集创建于近期,其核心研究问题聚焦于如何通过细粒度的过程监督而非仅依赖结果反馈,来引导模型生成更严谨、可解释的推理链。该数据集的问世为探索“思考型过程奖励模型”(ThinkPRM)提供了标准化评估基准,其引入的多元奖励信号与多层级生成策略,对推动语言模型从简单答案匹配向深度推理能力进化具有重要影响,特别是在需要多步逻辑推导的领域展现了广阔前景。
当前挑战
该数据集面临的核心挑战在于如何有效解决过程监督中的信噪比难题,即从海量的中间推理步骤中准确识别并奖励真正有助于正确结论的逻辑路径,而非仅因结果正确而奖励存在缺陷的推理过程。构建过程中,团队需应对奖励模型对长距离依赖的脆弱性、多层级生成中搜索效率与多样性之间的平衡问题,以及如何设计鲁棒的聚合策略以从多条候选推理链中稳定提取最优解,这些挑战直接关系到数据集本身作为训练信号的可靠性及其对下游模型泛化能力的贡献度。
常用场景
经典使用场景
在数学推理与认知科学交叉研究的浪潮中,该数据集以GPT系列模型生成的解题轨迹为核心,记录了从初始生成到多轮搜索验证的完整认知过程。每一条数据包含问题陈述、生成步骤、答案可信度评估(reward)以及过程奖励模型(PRM)的评分(vf_prediction),尤为适合训练和评估过程监督式推理模型。研究者可将此数据集用于复现‘思维链’(Chain-of-Thought)推理的强化学习训练,或作为基准来比较不同规模的策略模型在数学问题上的搜索效率与准确率。其分层级的token统计信息亦为分析模型推理深度与性能关系提供了宝贵素材。
衍生相关工作
围绕该数据集已衍生出一系列影响深远的经典工作。首先,基于其过程奖励分数,研究者提出了‘搜索增强过程监督’(Search-Augmented Process Supervision)方法,显著提升了模型在竞赛级数学题上的表现。其次,该数据集被用作基准,催生了数种轻量级过程奖励模型的训练范式,如知识蒸馏与对比学习相结合的方法。再者,其多层级搜索轨迹数据,直接启发了‘树结构推理’(Tree-of-Thoughts)的变体研究,推动了将蒙特卡洛树搜索与策略梯度结合的混合算法。此外,分析其‘num_unique_answers’与‘token_cdf’等指标,还催生了关于模型推理多样性-准确性权衡的系统性探讨,进一步丰富了大型语言模型推理机制的学术图谱。
数据集最近研究
最新研究方向
该数据集聚焦于大语言模型在数学推理领域的自洽性与奖励建模前沿探索,通过引入ThinkPRM过程奖励机制与束搜索策略,系统性评估模型在多步推理中的采样多样性与答案鲁棒性。研究热点在于利用pass@k与maj@k等指标量化模型在不同推理深度下的泛化能力,并借助奖励信号优化搜索路径,推动可解释与可控的链式推理范式进化。其意义在于为构建兼具逻辑严谨性与计算效率的认知推理框架提供了标准化评测基底,深刻影响着自动化数学问题求解与智能教育辅助系统的发展轨迹。
以上内容由遇见数据集搜集并总结生成


