
RedirectQA
收藏资源简介:
RedirectQA是由奈良先端科学技术大学院大学和Future Corporation联合创建的实体问答数据集,旨在研究大语言模型通过不同实体表面形式访问相同事实知识的能力。该数据集包含30,560个表面实例,源自14,672个Wikidata事实三元组,通过维基百科重定向信息关联了实体的规范名称和多种变体形式。数据构建过程包括从Wikidata收集事实三元组、利用维基百科重定向注释实体表面形式,并使用关系特定模板生成问题。该数据集主要应用于评估大语言模型在实体不同表面形式下的非逐字记忆能力,揭示模型在事实访问中的表面形式依赖性。
RedirectQA is an entity question answering dataset jointly developed by Nara Institute of Science and Technology and Future Corporation, which aims to study the capability of large language models (LLMs) to access identical factual knowledge through diverse entity surface forms. This dataset comprises 30,560 surface-level instances derived from 14,672 Wikidata factual triples, and links the canonical names and various variant forms of entities via Wikipedia redirect information. The data construction workflow includes collecting factual triples from Wikidata, annotating entity surface forms using Wikipedia redirects, and generating questions with relation-specific templates. This dataset is mainly applied to evaluate the non-verbatim memory ability of large language models under different entity surface forms, and reveals the surface form dependence of models in factual knowledge access.
RedirectQA 数据集概述
基本信息
- 数据集名称:RedirectQA
- 许可证:CC BY-SA 4.0
- 语言:英语(en)
- 任务类型:问答(question-answering)
- 数据规模:10K < n < 100K
数据集描述
RedirectQA 是一个基于实体的事实性问答数据集,旨在分析大型语言模型如何通过同一实体的不同表面形式获取相同事实。该版本(v1.0.0)与论文 Revisiting Non-Verbatim Memorization in Large Language Models: The Role of Entity Surface Forms 中描述的数据集一致。
数据集规模
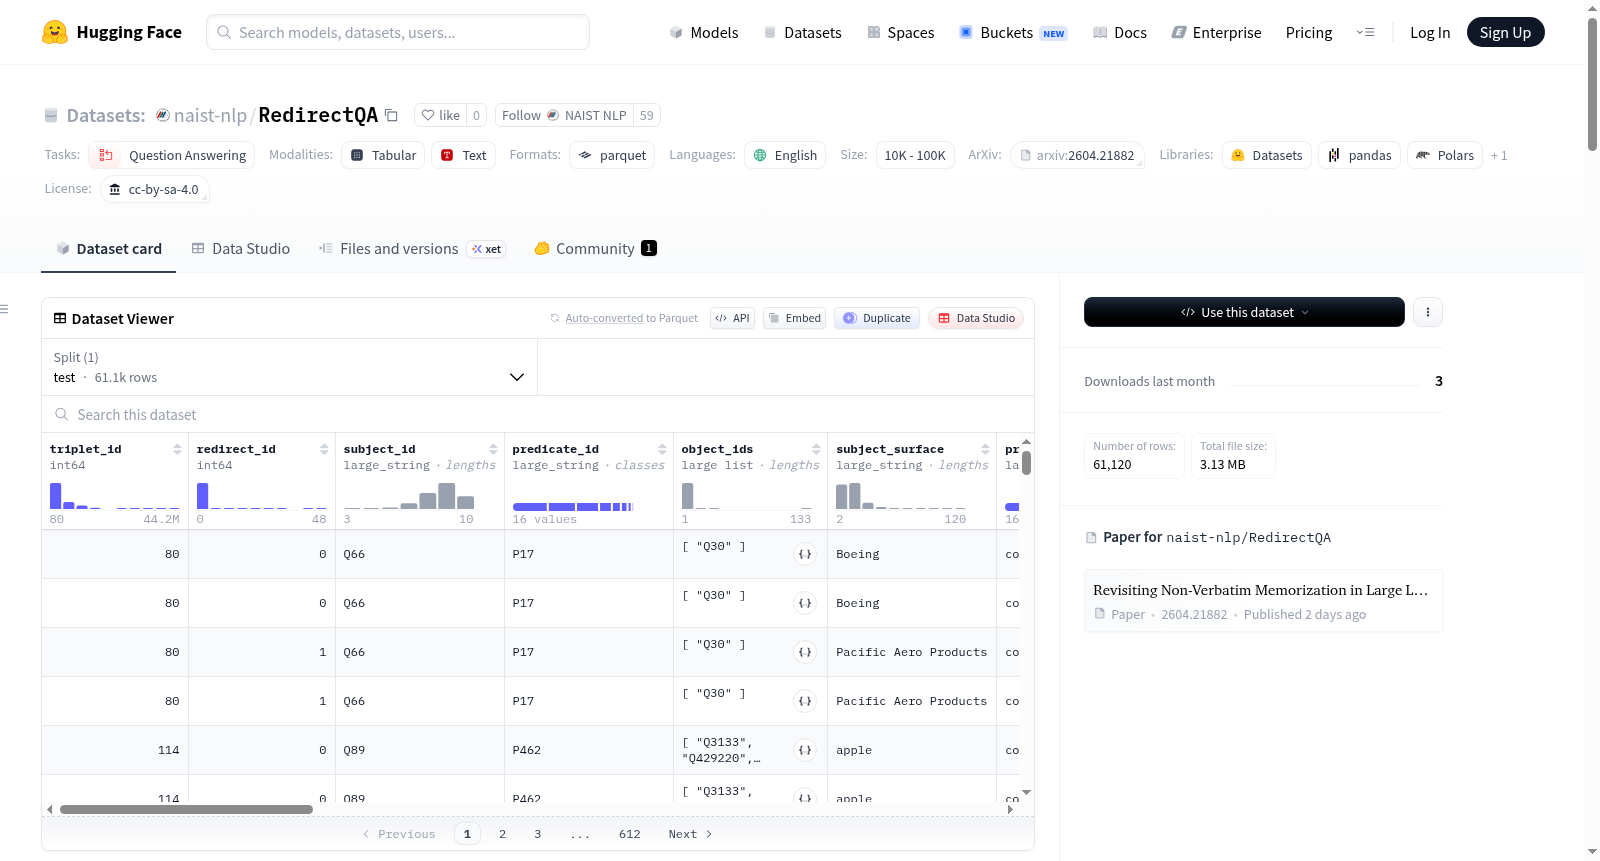
- 问题实现:61,120 个(test 分割)
- 主体-表面实例:30,560 个
- Wikidata 事实三元组:14,672 个
- 规范表面实例:14,672 个
- 重定向表面实例:15,888 个
- 关系类型:16 种
- 重定向类别:33 种
每个表面实例通过两个问题模板呈现:
- original:原始 PopQA 风格模板
- paraphrased:数据集构建过程中生成的释义模板
数据集结构
该版本提供一个配置:
- 配置名称:default
- 分割:test
- 文件路径:
data/test.parquet
在 data/test.parquet 中,每一行对应一个问题实现。由于每个表面实例出现在两个模板下,每个 (triplet_id, redirect_id) 对恰好出现两次:一次 template_type="original",一次 template_type="paraphrased"。
主要数据文件
data/test.parquet:61,120 行,每行一个问题实现
元数据文件
metadata/question_templates.json:每个谓词的两个公开问题模板metadata/redirect_category_to_type.csv:每个重定向类别到论文中使用的更高级别类型的映射
数据字段
| 字段 | 描述 |
|---|---|
triplet_id |
底层事实三元组的标识符 |
redirect_id |
三元组内的表面形式标识符;0 表示规范表面 |
subject_id |
主体实体的 Wikidata ID |
predicate_id |
Wikidata 属性 ID |
object_ids |
答案实体的 Wikidata ID |
subject_surface |
问题中使用的主体字符串 |
predicate_surface |
自然语言关系标签 |
object_surfaces |
规范答案表面形式 |
subject_aliases |
构建过程中收集的主体别名 |
object_aliases |
答案实体的别名列表 |
subject_wiki_title |
主体的规范英文 Wikipedia 标题 |
object_wiki_titles |
答案实体的规范英文 Wikipedia 标题 |
subject_pageviews |
主体的年度 Wikipedia 页面浏览量 |
object_pageviews |
答案实体的年度 Wikipedia 页面浏览量 |
subject_redirect_wiki_title |
当表面非规范时的重定向标题;规范行中为 null |
subject_surface_category |
重定向类别标签;规范行使用 ["__MAIN__"] |
possible_answers |
用于评估的可接受答案字符串 |
template_type |
问题模板类型:original 或 paraphrased |
question |
最终的自然语言问题 |
高级重定向类型
重定向类别分为以下更高级别的类型:
- Aliases_and_Abbreviations:别名和缩写
- Spelling_variants:拼写变体
- Typical_Errors:典型错误
规范行在 metadata/redirect_category_to_type.csv 中单独标记为 Canonical。
数据统计
- 表面实例:30,560 个,源自 14,672 个事实三元组
- 规范表面实例:14,672 个
- 重定向表面实例:15,888 个
- 问题实现:61,120 个(每个表面实例对应两个模板)
- 重定向表面实例细分:
- Aliases_and_Abbreviations:8,667 个
- Spelling_variants:4,928 个
- Typical_Errors:2,884 个
数据来源与许可说明
本数据集基于多个资源构建:
- 英文 Wikipedia 重定向和标题
- Wikidata 事实三元组
- Wikimedia 页面浏览统计
- PopQA 设置(用于关系选择和原始问题模板)
底层来源的许可证不同:
- Wikipedia 文本:CC BY-SA 4.0
- Wikidata 和页面浏览:CC0 1.0
- PopQA:MIT
加载数据集
python from datasets import load_dataset
dataset = load_dataset("naist-nlp/RedirectQA", split="test") print(dataset)
- 1Revisiting Non-Verbatim Memorization in Large Language Models: The Role of Entity Surface Forms奈良先端科学技术大学院大学; Future Corporation · 2026年


