FutureOmni
收藏资源简介:
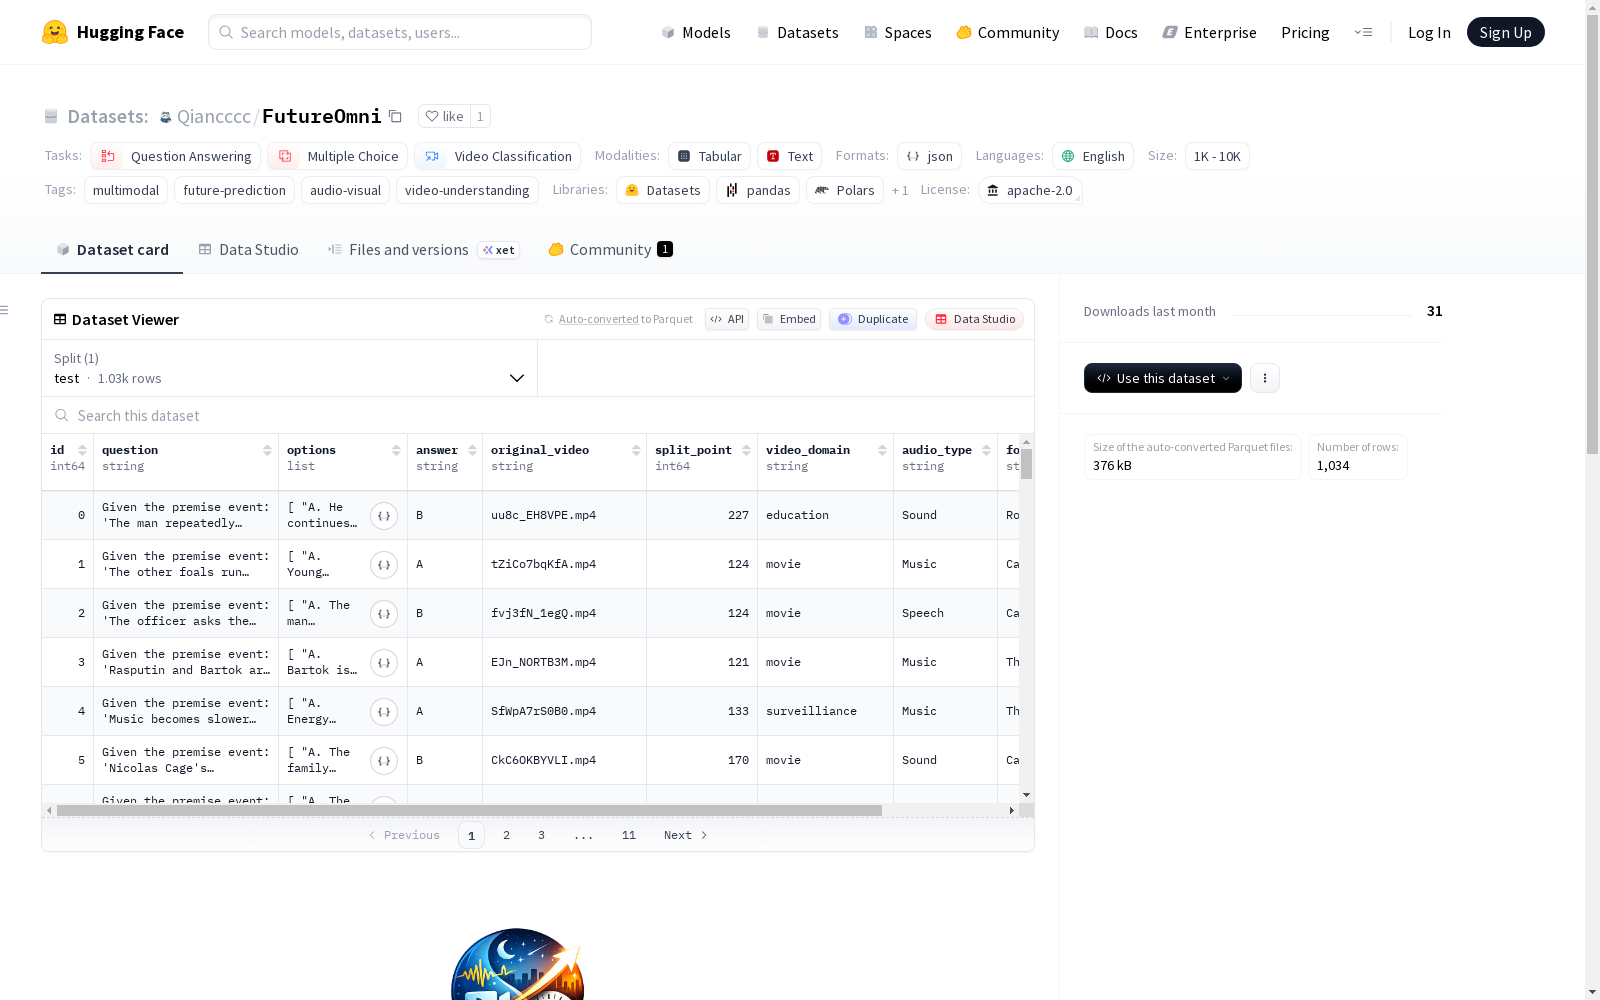
FutureOmni是第一个评估从音频-视觉环境进行全模态未来预测的基准测试。要成功完成这一任务,模型必须进行跨模态因果和时间推理,同时有效利用内部知识来预测未来事件。数据集包括:1. 评估集(基准测试):1,034个高质量多选题QA对,覆盖919个视频;2. 训练集(OFF策略):约7,700个指令调优样本,带有详细推理过程,以增强因果推理能力。
FutureOmni is the first benchmark for evaluating full-modal future prediction from audio-visual environments. To successfully complete this task, models must perform cross-modal causal and temporal reasoning while effectively leveraging internal knowledge to predict future events. The dataset includes: 1. Evaluation set (benchmark): 1,034 high-quality multiple-choice QA pairs covering 919 videos; 2. Off-policy training set: approximately 7,700 instruction-tuned samples with detailed reasoning processes to enhance causal reasoning capabilities.
FutureOmni 数据集概述
数据集基本信息
- 数据集名称: FutureOmni
- 托管地址: https://huggingface.co/datasets/Qiancccc/FutureOmni
- 许可证: apache-2.0
- 主要任务类别: 问答、多项选择、视频分类
- 语言: 英语
- 核心标签: 多模态、未来预测、视听、视频理解
- 数据规模: 1k<n<10k
数据集简介
FutureOmni 是首个用于评估多模态大语言模型从视听环境中进行全模态未来预测能力的基准。该数据集旨在探索模型基于视听线索预测未来事件的能力,这要求模型进行跨模态的因果与时间推理,并有效利用内部知识。
数据集构成
-
评估集(基准):
- 包含 1,034 个高质量的多项选择问答对。
- 基于 919 个视频构建。
-
训练集(OFF策略):
- 包含约 7,700 个指令调优样本。
- 每个样本均提供详细的推理依据,旨在增强模型的因果推理能力。
快速使用
可通过 datasets 库加载数据:
python
from datasets import load_dataset
加载基准评估集
dataset_test = load_dataset("Qiancccc/FutureOmni", split="test")
加载指令调优集
dataset_train = load_dataset("Qiancccc/FutureOmni", split="train")
相关资源
- 论文: LINK_TO_YOUR_ARXIV
- GitHub仓库: https://github.com/qq31415926/FutureOmni