
遇见数据集

nicholasKluge/model-library

收藏
Hugging Face2024-02-15 更新2024-03-04 收录
官方服务:

资源简介:

Model Library是一个用于评估现代机器学习系统风险的数据库项目。它包含了最新的、能力强大的AI系统,并详细记录了每个模型的名称、大小、研究领域、风险和限制等信息。数据集由AI Robotics Ethics Society (AIRES)维护,所有数据均通过手动收集和标注。

Model Library是一个用于评估现代机器学习系统风险的数据库项目。它包含了最新的、能力强大的AI系统,并详细记录了每个模型的名称、大小、研究领域、风险和限制等信息。数据集由AI Robotics Ethics Society (AIRES)维护,所有数据均通过手动收集和标注。

提供机构:
nicholasKluge
原始信息汇总

数据集概述

数据集描述

数据集摘要

Model Library 是一个项目,旨在映射与现代机器学习系统相关的风险。本数据库用于 Model Library

支持的任务和排行榜

该数据集作为机器学习模型的目录,所有模型均显示在 Model Library 中。

语言

英语。

数据集结构

数据实例

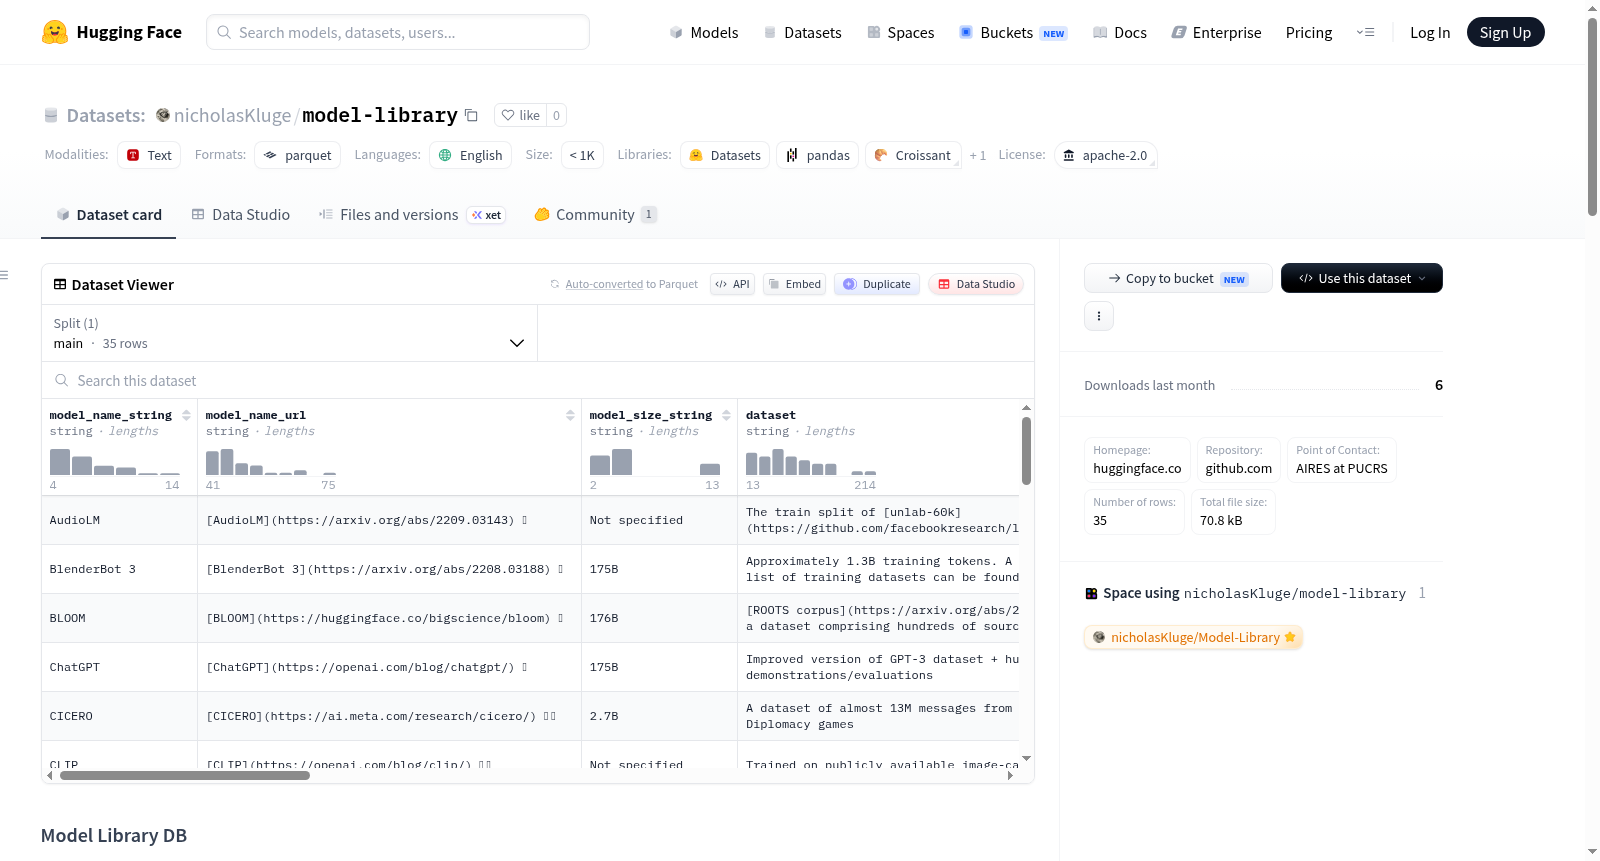
可用的特征包括:model_name_string, model_name_url, model_size_string, dataset, data_type, research_field, risks_and_limitations, risk_types, publication_date, organization_and_url, institution_type, country, license, paper_name_url, model_description, organization_info

数据字段

请参阅 数据实例

数据分割

"main" 分割是当前版本,显示在 Model Library 中。

数据集创建

策划理由

该数据集作为研究项目的一部分,用于记录与机器学习模型相关的风险。

源数据

初始数据收集和规范化

所有数据均为手动收集。

源语言生产者

更多信息请参阅 此处

注释

注释过程

更多信息请参阅 此处

注释者

AI Robotics Ethics Society (AIRES) 的成员。

个人和敏感信息

该数据集中不包含任何个人或敏感信息。

使用数据的注意事项

数据集的社会影响

无特别注意事项。

偏见的讨论

无特别注意事项。

其他已知限制

无特别注意事项。

附加信息

数据集策展人

AI Robotics Ethics Society (AIRES) 的成员。

许可信息

该数据集根据 Apache License, version 2.0 进行许可。

引用信息

latex @misc{correa24library, author = {Nicholas Kluge Corr{^e}a and Faizah Naqvi and Robayet Rossain}, title = {Model Library}, year = {2024}, howpublished = {url{https://github.com/Nkluge-correa/Model-Library}} }

贡献

如果您想添加模型,请阅读我们的文档并在 GitHub 上提交 PR。
搜集汇总
数据集介绍
nicholasKluge/model-library 数据集图片
构建方式
在人工智能伦理与风险研究日益受到重视的背景下,Model Library数据集应运而生,旨在系统性地梳理现代机器学习系统所蕴含的风险。该数据集由AI机器人伦理学会(AIRES)的成员通过人工方式精心收集与整理而成,所有数据均源于对前沿AI模型的审慎评估与文献调研。数据集的构建遵循了严谨的标准化流程,每条记录均包含模型名称、规模、训练数据、研究领域、风险类型、机构信息等十六个维度的结构化字段,最终以35个实例的规模汇聚成一个高度凝练的模型风险知识库。
使用方法
研究者可直接通过HuggingFace Datasets库加载该数据集,利用其结构化特性进行模型风险的趋势分析、跨机构比较或风险分类研究。数据集以单一‘main’分片存储,包含16个特征字段,用户可根据研究需求灵活筛选如‘research_field’或‘risk_types’等列进行定向挖掘。同时,数据集与GitHub仓库及HuggingFace Space上的可视化看板深度联动,支持通过提交PR的方式贡献新模型,从而构建一个动态更新的AI风险图谱。
背景与挑战
背景概述
在人工智能领域,随着机器学习模型在复杂性与应用范围上的迅猛扩张,对其潜在风险与局限性的系统性评估成为一项迫切的研究课题。由AIRES(AI Robotics Ethics Society)成员Nicholas Kluge Corrêa等人于2024年创建的Model Library数据集,旨在构建一个映射现代机器学习系统风险的知识库。该数据集聚焦于收录并分析前沿AI模型,涵盖模型名称、规模、研究领域、风险类型及发布机构等关键信息,为学界与工业界提供了一个审视AI系统安全性与伦理影响的标准化框架。其核心研究问题在于如何通过结构化数据,揭示不同模型在特定应用场景下的潜在危害,从而推动负责任的AI发展。该数据集依托于HuggingFace平台,通过开源协作模式吸引研究者参与,对AI风险管理与透明度提升具有重要影响力。
当前挑战
Model Library数据集面临的首要挑战在于其覆盖范围的局限性。当前数据集仅包含35个模型样本,远无法代表快速演进的AI模型生态系统,可能导致风险评估的偏差与不完整。其次,数据构建依赖人工手动收集与标注,过程耗时且易受主观判断影响,不同标注者对“风险”与“局限”的定义可能存在差异,威胁数据的一致性与客观性。此外,模型风险具有动态性,随着模型更新与应用场景变化,初始标注的风险类型可能过时,需持续维护与更新。最后,数据集缺乏对模型实际部署后风险的追踪机制,难以捕捉长期运行中涌现的未知问题,这限制了其在真实世界风险评估中的实用性。
常用场景
经典使用场景
在机器学习与人工智能治理交叉研究的领域中,Model Library数据集犹如一座精心编纂的模型风险档案库。其最经典的使用场景在于为研究者提供一个结构化的现代AI系统风险评估索引,涵盖从模型参数规模、训练数据类型到研究领域与潜在局限性的多维元信息。通过这一目录,学者能够系统性地追踪前沿模型在安全性、偏见性及伦理合规性方面的表现,从而在模型选型与对比分析中形成基于实证的决策支撑。
解决学术问题
该数据集精准回应了当前人工智能研究中一个迫切的方法论困境:即缺乏对快速迭代的机器学习模型进行统一、可复现的风险标注框架。它解决了学术领域中模型透明度不足与风险信息碎片化的问题,使得跨模型、跨机构的比较研究成为可能。其深远意义在于推动了负责任的AI研究范式——通过将模型风险类型化、结构化,为后续的算法审计、公平性评估及可解释性分析提供了标准化的数据基座,进而催化了从模型性能竞赛向模型治理生态的学术转向。
实际应用
在实际产业应用中,Model Library数据集可作为企业AI治理与合规部门的决策参考工具。当技术团队需要引入预训练模型时,该数据集能帮助快速筛查特定模型是否涉及已知的风险类别,如数据偏见或滥用可能性,从而在开发早期规避法律与伦理风险。此外,监管机构和第三方审计组织亦可借助此目录构建模型注册清单,实现对大语言模型、多模态系统等前沿技术的动态追踪,为制定行业标准与政策提供实证依据。
数据集最近研究
最新研究方向
在当前人工智能系统蓬勃发展但风险日益凸显的背景下,Model Library数据集聚焦于现代机器学习模型的风险映射与治理研究。该数据集系统收录了近年来最具代表性的前沿AI系统,详细标注了其模型规模、训练数据、研究领域及潜在风险类型,为学术界和产业界提供了一个结构化、可追溯的模型风险档案。前沿研究方向正围绕模型透明度、安全评估与责任归属展开,尤其是针对大型语言模型和生成式AI的偏见、滥用及伦理隐患进行量化分析。这一数据集不仅服务于AI审计与合规评估,还推动了负责任人工智能的标准化进程,其影响力体现在促进跨机构协作、提升模型发布前的风险评估意识,并为政策制定者提供了实证基础,成为AI治理领域不可或缺的参考资源。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

