
fosters/Antuan_de_Sent-Ekziupiery_Planieta_ludziei_output_backup
收藏数据链接:
官方服务:
资源简介:
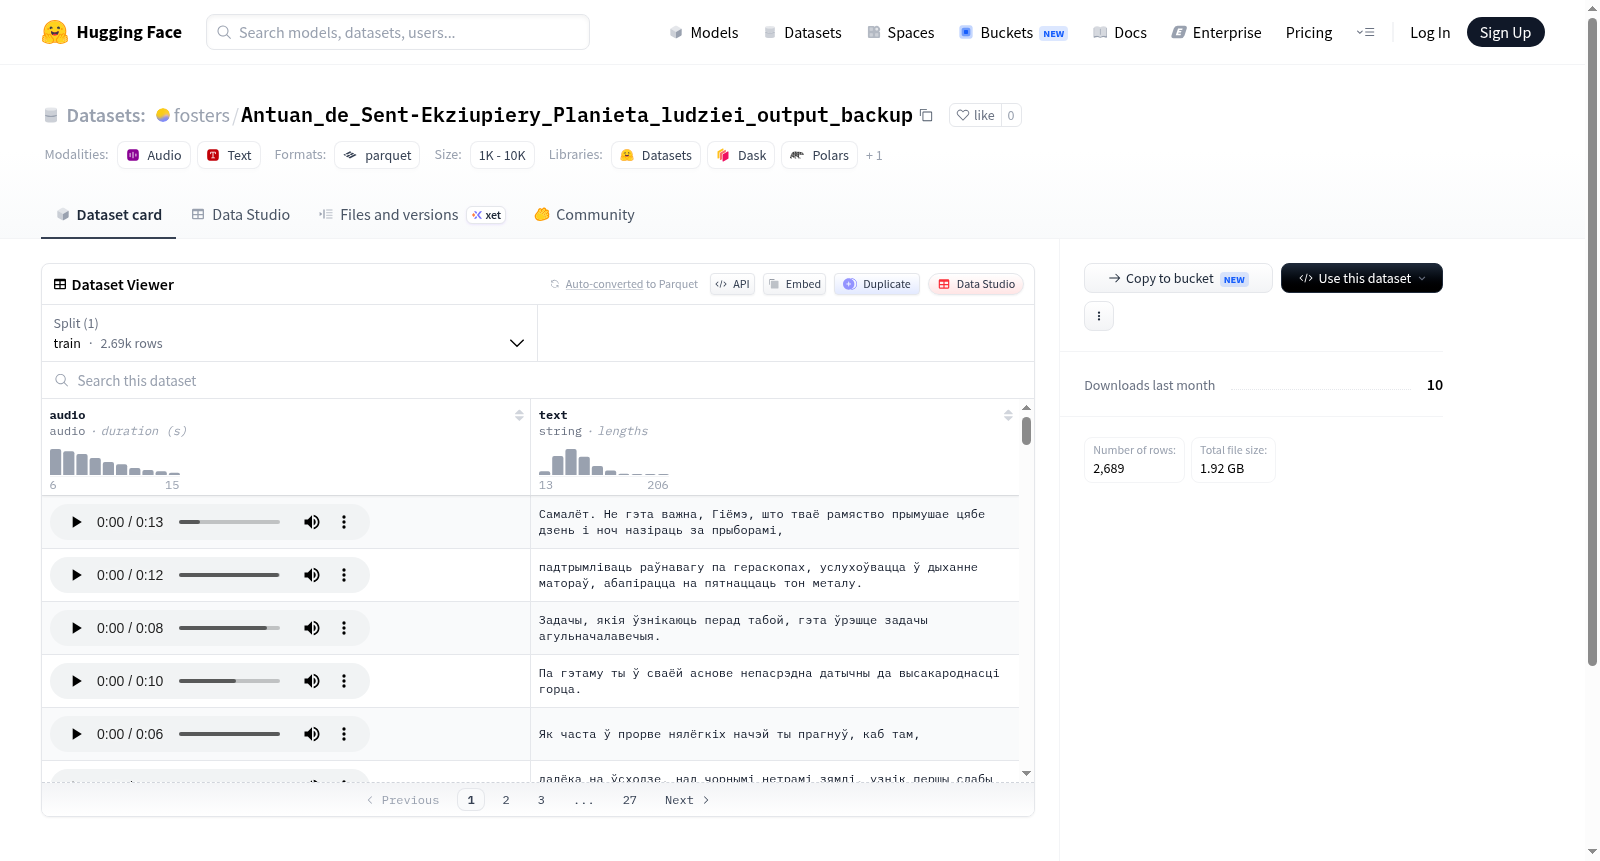
AudioSet Pipeline Output 是一个由AudioSetPipeline发布的数据集,基于分片结构导出,可能用于音频处理或机器学习任务,但具体内容未在README中详细说明。
AudioSet Pipeline Output is a shard-based dataset export published by AudioSetPipeline, potentially used for audio processing or machine learning tasks, but specific details are not provided in the README.
提供机构:
fosters搜集汇总
数据集介绍
构建方式
该数据集源自法国作家安托万·德·圣-埃克苏佩里的文学名著《人类的大地》,经过AudioSetPipeline流水线处理,以分片(shard)形式存储并导出。数据以Parquet格式保存,配置了默认的单一训练集(train)分区,文件路径按目录层级组织于default/train文件夹下。整个构建过程依托于AudioSetPipeline自动化流程,通过分片策略确保数据的高效存取与分发。
特点
数据集以经典文学作品为内容基底,兼具文学价值与结构化存储特性。采用Parquet列式存储格式,支持高效压缩与快速读取,适合大规模语料处理。单一训练集配置简化了数据加载流程,分片机制便于分布式计算环境下的并行处理。其命名中的“output_backup”暗示了该版本作为导出备份的用途,保证了数据来源的完整性与可追溯性。
使用方法
用户可通过HuggingFace Datasets库加载该数据集,调用`load_dataset`函数并指定数据集名称与配置名称'default'即可获取训练数据。由于数据以Parquet格式存储,推荐使用基于列式读取的DataFrame操作进行数据探索。在分布式处理场景中,可依据分片路径对数据子集进行分片加载,以优化内存使用。此外,该数据集适用于文本分析与自然语言处理任务,如文学语料特征提取或文本生成模型训练。
背景与挑战
背景概述
该数据集名为“Antuan_de_Sent-Ekziupiery_Planieta_ludziei_output_backup”,源自AudioSet Pipeline的自动化输出,由未知研究机构或个人于近期创建。其名称疑似引用法国作家圣埃克苏佩里的作品《小王子》中的主题,暗示数据集可能聚焦于语言、音频或文本中的叙事内容。作为AudioSet Pipeline的衍生成果,该数据集旨在处理并存储大规模音频或文本数据的结构化输出,服务于语音识别、自然语言处理或多模态学习等研究领域。尽管其具体研究问题未在描述中明确,但其分片式(Shard-based)导出格式(如Parquet文件)表明,数据集适合高效分布式存储与迭代式训练,对音频或文本领域的大规模模型开发具有潜在支撑价值。当前,该数据集在HuggingFace上的公开状态使其可能促进相关社区的实验复现与基准测试。
当前挑战
该数据集面临的挑战首先体现在领域层面:作为AudioSet Pipeline的产物,它需应对音频或文本分类、检索中的噪声干扰、样本不平衡及标注稀疏性问题,这些是制约模型泛化能力的关键瓶颈。构建过程中,分片式存储格式(如Parquet)虽提升访问效率,却增加了数据整合与跨分片一致性校验的复杂度;同时,数据集名称与来源的模糊性可能导致误用或可复现性下降。此外,缺乏元数据规范(如标注标准、采样策略)使得新用户难以精准评估其适用场景,进一步限制了数据集在跨任务迁移学习中的潜力。
常用场景
经典使用场景
该数据集以《小王子》作者圣埃克苏佩里的俄文作品《人类的大地》为语料基础,构建了高质量文本语料库。其经典使用场景聚焦于俄语自然语言处理任务,尤其适用于文学文本的语义分析、作者风格迁移研究以及低资源语言的预训练语言模型微调。研究人员常将其作为俄语文学语料基准,用于文本生成、情感分析及主题建模等任务,其独特的文学属性为分析复杂叙事结构和修辞手法提供了稀缺数据支持。
实际应用
在实际应用中,该数据集可被用于开发面向俄语文学爱好者的智能阅读辅助工具,如自动摘要生成、人物关系图谱构建及文学情感演化可视化。亦可支撑教育科技领域的俄语写作辅导系统,通过分析文本风格特征为学习者提供仿写建议。此外,其结构化格式便于集成至数字人文平台,支持学者对20世纪早期法语文学俄译本的跨媒介研究,为文学遗产的数字化保护与传播奠定数据基础。
衍生相关工作
基于该数据集,衍生出多项经典工作:包括使用俄语文学语料进行预训练的语言模型(如RuBERT的领域微调版本)、面向文学文本的命名实体识别系统、以及结合Transformer架构的作者身份验证方法。部分研究将其与法语原版《人类的大地》进行跨语言对齐,构建平行语料库,用于文学翻译中的风格忠实度评估。此外,该数据集还催生了针对俄语长文本的摘要生成模型及文学情感分析基准测试集,进一步拓展了计算叙事学的研究边界。
以上内容由遇见数据集搜集并总结生成


