
遇见数据集

nyralabs/disfluency_speech_german

收藏
Hugging Face2026-07-15 更新2026-07-22 收录
官方服务:

资源简介:

Nyra Disfluency Speech German 是一个德语语音数据集,专门用于评估逐字自动语音识别(verbatim ASR)模型,要求模型不仅能转录说话者的意图单词,还能准确转录填充词、中断、重复和声音事件等不流利内容。该数据集由Nyra研究人员Berns和Laurin内部录制,旨在模拟自然的德语不流利语音,类似于英语的AMAAI Lab DisfluencySpeech数据集。数据集包含202个话语,总计约0.95小时音频,分为测试集。每个样本包括id、音频、时长、分割、说话者、语言、逐字转录(verbatim_transcript)和意图转录(intended_transcript)。逐字转录遵循特定约定,如使用*标记中断(例如w*)、括号标签标记填充词(如[UH]和[UM])和声音事件(如[lipsmack]、[throatclearing]),而意图转录则清理了这些不流利内容,保留说话者的意图。数据集设计用于与Nyra Verbatim Speech Benchmark配合,以详细评估逐字ASR模型的性能,包括计算vWER和iWER等指标,以及分析填充词、声音、中断和重复的错误。统计显示,所有话语都至少包含一个标记事件或中断,填充词和中断频繁出现,使其成为评估不流利语音转录的核心资源。

`nyrahealth/disfluency_speech_german` is a German speech dataset for evaluating verbatim ASR: models that should transcribe not only the intended words, but also fillers, cutoffs, repetitions, and sound events. This dataset was recorded in-house by two Nyra researchers, Berns and Laurin, with the goal of producing natural disfluent German speech similar in spirit to the English AMAAI Lab DisfluencySpeech dataset. It is formatted for verbatim-transcription benchmarking with paired verbatim_transcript and intended_transcript. The dataset contains 202 utterances and about 0.95 hours of audio, with features including id, audio, duration_in_s, split, speaker, language, verbatim_transcript, and intended_transcript. It is used by the Nyra Verbatim Speech Benchmark for detailed evaluation of verbatim ASR, breaking errors down into fillers, sounds, cutoffs, repetitions, and intended-transcript failures. Statistics show every utterance contains at least one annotated event or cutoff, making it dense in disfluencies for core evaluation.
提供机构:
nyralabs
搜集汇总
数据集介绍
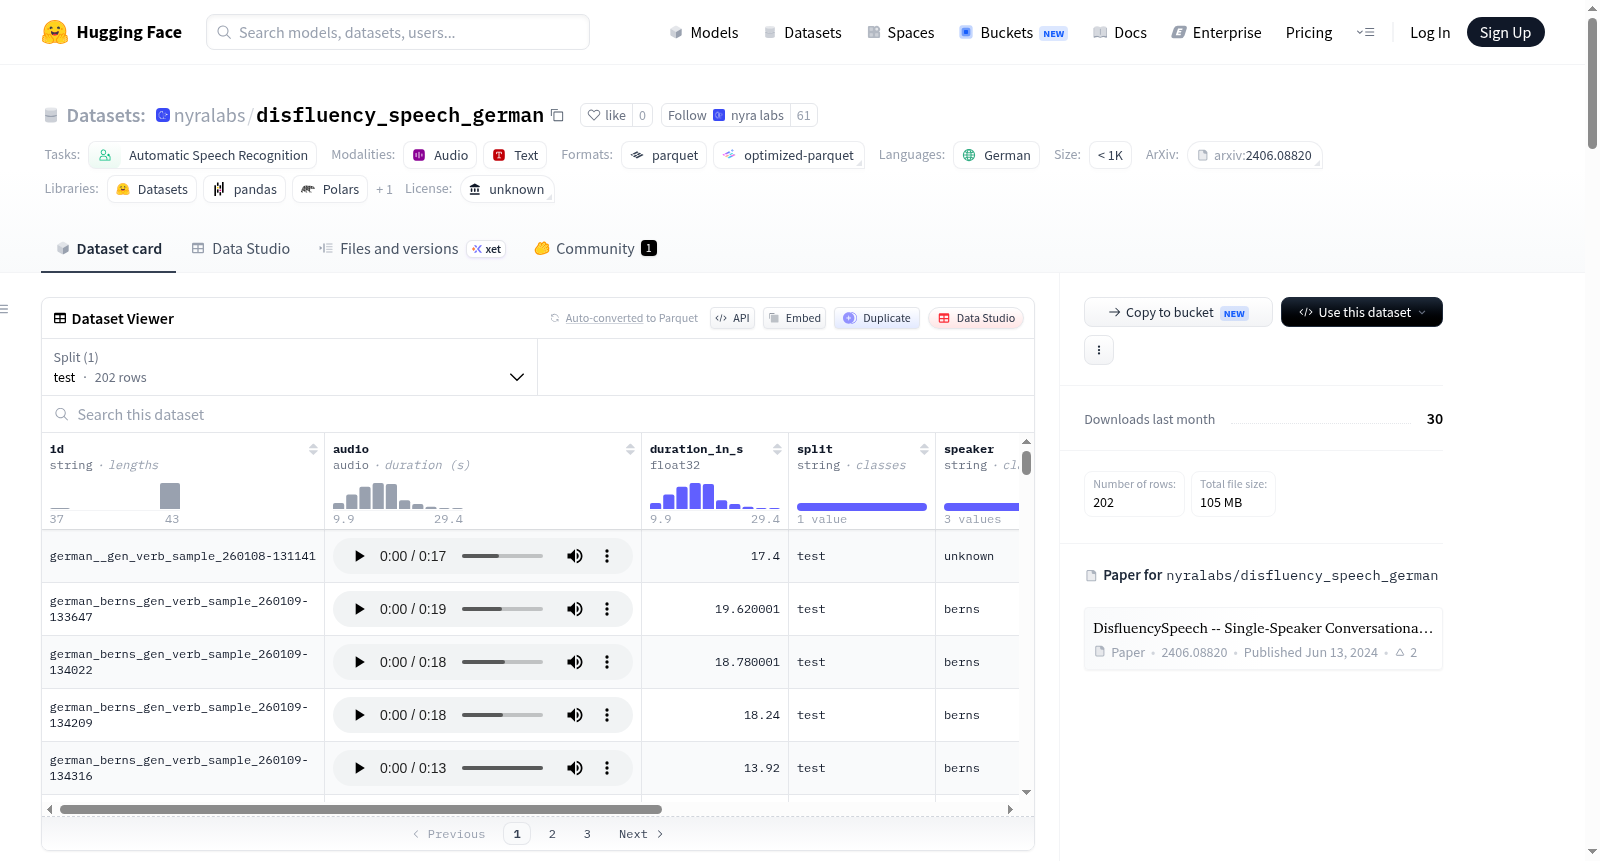
nyralabs/disfluency_speech_german 数据集图片
构建方式
该数据集由Nyra研究团队的Berns与Laurin两位成员在内部录制而成,旨在生成自然流畅的德语非流畅性语音。数据收集过程模拟真实对话中的语塞、重复、修正及非言语声音事件,共包含202段话语,音频总时长约0.95小时。每段语音均配有一对逐字转录与意图转录,前者忠实记录实际发音,后者则过滤掉非流畅成分,保留说话者本意。数据集以HuggingFace格式发布,划分为单个测试集,便于直接用于基准评估。
特点
该数据集的核心特色在于其高度集中且密集的非流畅性标注。所有202段话语均包含至少一个标注事件(如填充词、声音事件)或截断标记,其中填充词[UH]与[UM]出现频率极高,分别达348次与266次,截断标记共计394个。此外,数据集还涵盖多种声音事件,如清嗓、笑声、咂嘴等,丰富了评估维度。通过逐字与意图转录的配对,该数据集支持对自动语音识别模型在非流畅语音场景下的性能进行细致拆解,涵盖填充词、声音、截断、重复及意图转录错误等五大类别。
使用方法
该数据集专为Nyra Verbatim Speech Benchmark设计,用户可通过该基准工具自动获取黄金非流畅标签,并计算逐字词错误率与意图词错误率等核心指标。使用方法简单:加载数据集后,将逐字转录与意图转录输入基准框架,即可获得填充词、声音事件、截断及重复等各类错误的细粒度分析。开发者亦可参照HuggingFace上的数据集结构,直接使用`datasets`库加载`test`分片,并结合基准仓库中的转录约定文档进行自定义评估逻辑编写。
背景与挑战
背景概述
Nyra Disfluency Speech German 数据集由 Nyra 健康研究机构的 Berns 与 Laurin 于近期创建,旨在为德语口语的逐字转录评估提供高质量基准。该数据集聚焦于自动语音识别中一个极具挑战性的细分方向——即包含填充词、截断、重复及非言语声音事件的不流畅言语转录。作为英语 AMAAI Lab DisfluencySpeech 数据集的德语对照版本,它填补了非英语语言在逐字转录评测中的空白。数据集中包含 202 条话语与约 0.95 小时音频,每条话语均配有逐字转录与意图转录的配对标注,为细致评估不流畅言语的识别性能提供了标准化框架。该数据集的发布推动了多语言不流畅言语研究的发展,并成为 Nyra Verbatim Speech Benchmark 的核心组成部分,对语音识别领域在精细化错误分析方面的进步具有重要影响。
当前挑战
该数据集所解决的领域问题核心在于传统 ASR 系统在面对口语不流畅现象时的脆弱性。通用语音识别基准往往忽略填充词、截断和重复等结构,导致模型无法准确捕捉真实对话的复杂性。Nyra Disfluency Speech German 通过提供精确的逐字与意图转录对,使研究者能够系统性地评估和提升 ASR 模型在口语句子层面的鲁棒性。在构建过程中,挑战主要体现为:一是在短时间内录制自然且密度适中的不流畅德语对话,确保每位说话者的语流既真实又富含目标事件;二是建立一套与英语数据集一致但适应德语语言特性的标注规范,包括截断标记、填充词标签及事件类型定义;三是确保所有话语音频质量一致且事件分布可控,为后续基准测试提供可靠的数据基础。
常用场景
经典使用场景
在德语口语不流畅语音识别的研究领域,该数据集被广泛用于评估逐词转录(verbatim ASR)模型的性能。其核心设计在于提供成对的逐词转录文本与意图转录文本,使研究者能够精确量化模型在处理填充词、截断、重复及声音事件等口语不流畅现象时的表现。经典使用方式是将该数据集作为基准测试集,通过计算逐词词错误率(vWER)和意图词错误率(iWER)等指标,系统性地评估不同ASR系统对德语自然口语中各类不流畅现象的捕捉能力。
实际应用
在实际应用中,该数据集主要服务于医疗健康领域的人机交互系统,尤其是针对语音辅助技术中自然对话场景的优化。例如,Nyra Health公司利用该数据集开发的逐词语音基准测试,用于评估和提升虚拟健康助手对患者真实口语表达的转录准确性,包括捕捉犹豫、自我修正等不流畅特征。此外,该数据集还可用于改进德语语音助手、自动字幕生成系统以及对话式AI在非正式交流场景中的鲁棒性,确保系统能够理解并正确处理口语中的自然变异。
衍生相关工作
该数据集的发布催生了一系列相关研究工作,最直接的是Nyra Health团队构建的逐词语音基准测试(Nyra Verbatim Speech Benchmark),该基准通过自动化从逐词与意图转录对中推导不流畅标签,并定义了细粒度的事件评价指标。此外,该数据集作为英文AMAAI Lab DisfluencySpeech数据集的德语姊妹版,促进了跨语言不流畅语音分析的比较研究。未来,它可能推动德语口语语料库的扩展,以及基于该数据集的端到端逐词ASR模型、不流畅检测与移除等下游任务的研究工作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

