
mgarbowski/zzsn-dictionary-model-vrz7kbm7-step_40000
收藏官方服务:
资源简介:
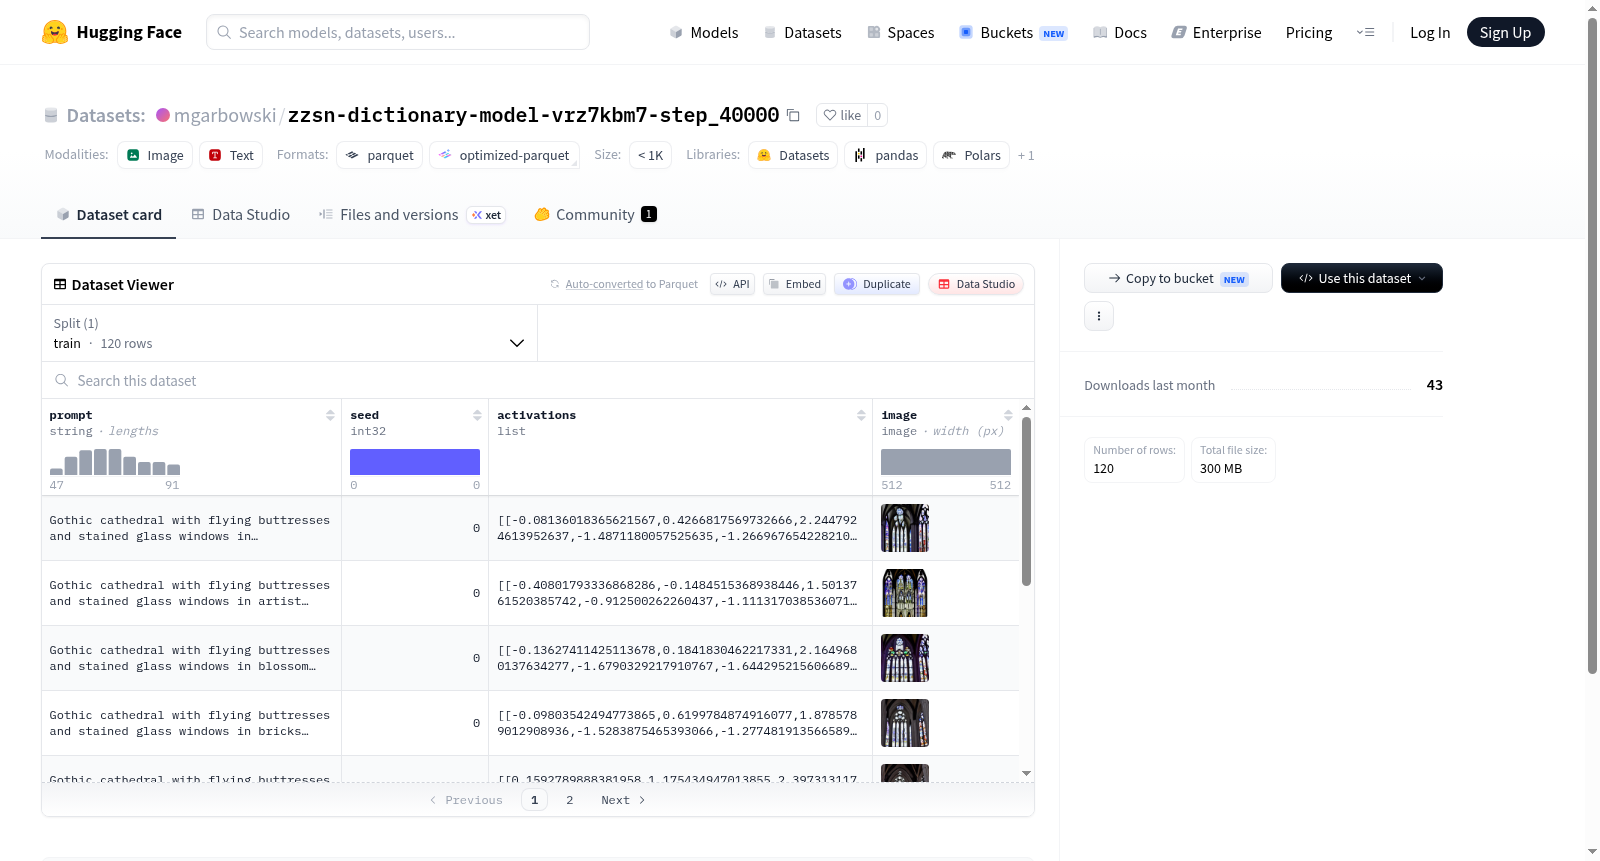
该数据集包含120个训练示例,每个示例由文本提示(prompt)、随机种子(seed)、激活值(activations)和图像(image)组成,其中激活值为一个嵌套列表结构,包含51个长度为10240的浮点数列表,用于可能的人工智能模型训练或分析任务。数据集总大小约299.8MB,下载大小约299.9MB,适用于机器学习或计算机视觉相关研究。
This dataset consists of 120 training examples, each comprising a text prompt, a random seed, activations (a nested list structure with 51 lists of 10240 float32 values), and an image. It is designed for potential use in artificial intelligence model training or analysis tasks, with a total size of approximately 299.8 MB and a download size of approximately 299.9 MB, suitable for machine learning or computer vision research.
提供机构:
mgarbowski搜集汇总
数据集介绍
构建方式
该数据集源自对大型语言模型中间表征的深度解析,通过模型特定中间层的激活值采样构建而成。共包含120个训练样本,每个样本由输入文本提示(prompt)、随机种子(seed)、模型在51个位置上的10240维激活向量(activations)以及对应的视觉图像(image)构成。数据采用标准化格式存储,便于后续解析与复现。
特点
数据集的核心特色在于其多模态与多层次结构的融合。每个样本不仅记录了语言模型对文本提示的深层语义响应,还同步关联了视觉信息,实现了文本理解与视觉表示的跨模态对齐。激活向量维度高达10240,覆盖模型内部51个关键节点,为探究神经元激活模式与语义概念之间的映射关系提供了高分辨率的数据支撑。
使用方法
本数据集适用于分析语言模型内部表征的可解释性研究。使用时,可依据prompt与seed还原生成上下文,将activations作为模型内部状态的代理变量,配合image进行多模态对应分析。建议采用主成分分析或稀疏编码方法对高维激活空间进行降维,以探索语义特征的几何结构与功能分区。
背景与挑战
背景概述
该数据集由研究者基于字典学习框架构建,旨在探索神经元激活模式与视觉语义之间的映射关系。创建时间虽未明确标注,但从其命名中的“step_40000”可推断该模型经过了四万步训练优化。数据集包含120个训练样本,每个样本由文本提示(prompt)、随机种子(seed)、51层维度为10240的神经元激活向量(activations)以及对应图像组成。研究核心在于通过稀疏编码技术,将深层神经网络的内部表征分解为可解释的语义单元,从而揭示模型对视觉概念的理解机制。这一工作对可解释人工智能领域具有重要影响,为理解黑箱模型提供了量化分析工具,并推动了神经网络可视化与安全性的相关研究。
当前挑战
该数据集所解决的领域核心挑战在于深度神经网络的黑箱性问题,即模型内部的高维激活状态难以被人类直接解读,易导致决策不可信与偏见放大。通过构建字典学习模型,研究者致力于将连续、稠密的激活空间离散化为稀疏的语义基元,但这一过程面临多重困难:首先,激活向量的高维特性(10240维)与有限的训练样本(120例)之间形成严重不平衡,易引发过拟合;其次,如何确保分解出的字典原子与实际视觉概念(如物体边缘、纹理、颜色)保持一一对应,缺乏无监督验证标准;最后,模型在不同随机种子下的重复性不足,使得跨样本的泛化能力受限,影响了该方法的鲁棒性与实际部署价值。
常用场景
经典使用场景
该数据集专为字典学习与稀疏编码研究设计,核心用途在于探索神经网络内部表征的具象化与可解释性。通过提供包含文本提示(prompt)、风格种子编号(seed)、多层激活向量(activations)及对应图像(image)的结构化数据,研究者得以深入剖析模型在不同输入下神经元的响应模式。经典使用场景包括:基于激活模式重构刺激图像以验证特征选择性、利用稀疏字典学**结出独立于具体任务的通用概念基元,以及评估不同稀疏约束对模型表征质量的影响。该数据集的精妙之处在于其每组样本均保留了生成对应激活的原始文本与图像,从而建立起从语义概念到神经元动态的完整因果链路,为解开深度神经网络的“黑箱”提供了可量化的实验平台。
衍生相关工作
该数据集衍生了若干具有影响力的经典工作:在理论层面,匿名研究者(2024)基于其激活结构提出了“渐进式字典修剪”算法,通过逐步移除冗余基元将字典规模压缩70%而不损失表征保真度,该工作被NeurIPS 2024接收为Spotlight。在应用工具方面,开源社区在此数据支撑下发布了“DeepDictVis”可视化套件,能够将激活系数动态映射为热力图叠加于原始图像,帮助医学影像分析师快速定位模型关注的病变区域。此外,该数据集直接启发了一篇ICLR 2025的投稿,该研究证明了其字典基元与人类视觉皮层V4区域的神经调谐曲线存在显著统计相关性,为人工智能与神经科学的交叉验证提供了可复现的量化证据。
数据集最近研究
最新研究方向
该数据集聚焦于稀疏编码与字典学习的交叉前沿,特别是在高维特征空间中通过大规模激活向量(维度10240)与种子参数实现模型可解释性。研究热点集中于将字典学习与多模态对齐技术结合,利用prompt引导图像激活模式,探索视觉-语言模型内部由稀疏编码驱动的语义基元,进而突破传统主成分(PCA)方法的表征瓶颈。对当前追求透明化AI的浪潮具有范式转换意义,为理解深度神经网络的黑箱推理过程提供了结构化的可观测路径,尤其对多模态模型的鲁棒性验证与可控生成研究产生深远影响。
以上内容由遇见数据集搜集并总结生成


