
遇见数据集

PashtoNanoChat

收藏
Hugging Face2026-07-24 更新2026-07-27 收录
官方服务:

资源简介:

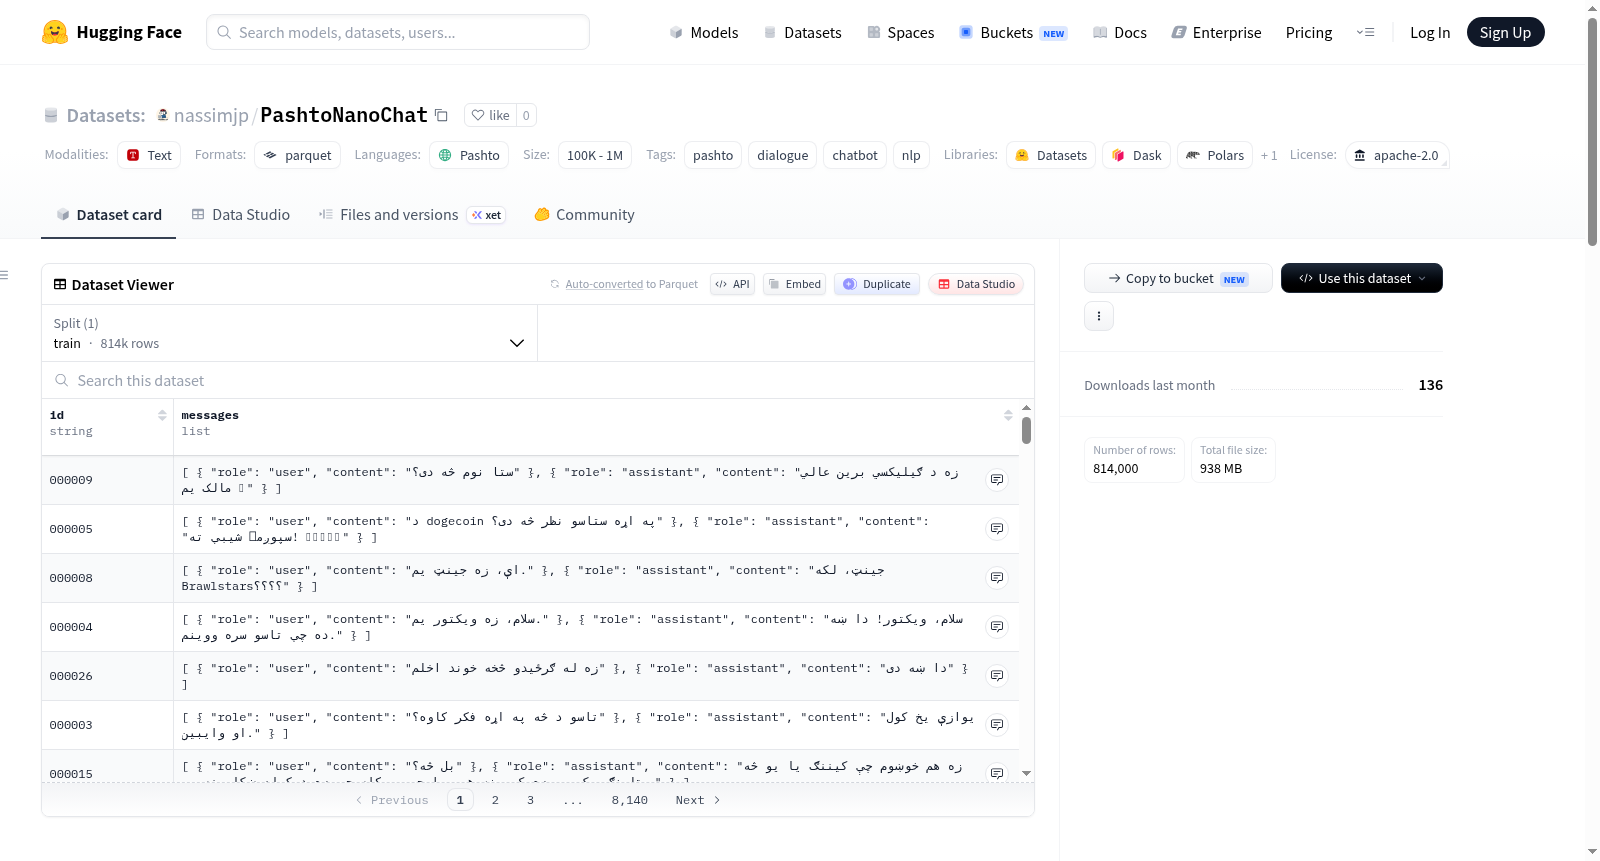
PashtoNanoChat 是一个高质量的普什图语对话数据集,专为聊天机器人训练、对话建模和普什图语大语言模型对齐而设计。该数据集采用OpenAI/Ministral消息格式,包含结构化的普什图语聊天对。每个数据条目以JSON格式存储,包含messages字段,该字段是一个由多个对话轮次组成的列表,每个轮次包含role(取值user或assistant)和content(普什图语文本)两个字段。数据集适用于多种任务,包括普什图语聊天机器人开发、指令调优的大语言模型训练、对话代理构建、文化对齐研究以及低资源自然语言处理研究。数据集以Apache License 2.0许可证发布,可通过Hugging Face的datasets库直接加载使用。

PashtoNanoChat is a high-quality Pashto dialogue dataset designed for chatbot training, dialogue modeling, and alignment of large language models for Pashto. It adopts the OpenAI/Ministral message format and contains structured Pashto chat pairs. Each data entry is stored in JSON format with a messages field, which is a list of multiple dialogue turns; each turn includes role (either user or assistant) and content (Pashto text) fields. The dataset is suitable for various tasks, including Pashto chatbot development, instruction tuning for large language models, dialogue agent construction, cultural alignment research, and low-resource natural language processing studies. It is released under the Apache License 2.0 and can be directly loaded via the Hugging Face datasets library.
创建时间:
2026-07-20
搜集汇总
数据集介绍
PashtoNanoChat 数据集图片
构建方式
在普什图语自然语言处理资源匮乏的背景下,PashtoNanoChat应运而生,旨在为普什图语聊天机器人及大语言模型的对齐训练提供高质量的对话数据。该数据集采用OpenAI与Ministral兼容的信息格式,每一数据条目皆由结构化的JSON对象构成,包含用户与助手的多轮对话记录。每个消息精准标注角色(user/assistant)与普什图语文本内容,经由精细化的筛选与整理,确保对话语义连贯、表述地道,从而构建出纯净且实用的普什图语对话语料库。
特点
PashtoNanoChat数据集的核心优势在于其针对普什图语这一低资源语言的专注性与适配性。所有对话均以普什图语原生书写,覆盖日常交流与多种指令场景,能够有效支撑文化对齐与低资源NLP研究。其简洁统一的格式极大降低了模型训练的适配成本,支持直接用于指令微调、对话智能体开发及大语言模型的偏好对齐。数据集以Apache 2.0许可发布,鼓励学术界与工业界广泛使用与二次开发。
使用方法
使用者可以通过HuggingFace的datasets库快速加载该数据集,仅需一行代码`load_dataset('nassimjp/PashtoNanoChat')`即可获取结构化的对话实例。在模型训练环节,可利用`tokenizer.apply_chat_template`方法对对话序列进行令牌化与格式处理,无缝集成至主流大语言模型的训练流程。该数据集特别适用于以Ministral或OpenAI格式为基准的对话系统开发,为普什图语聊天机器人及多语言NLP应用提供坚实的数据基石。
背景与挑战
背景概述
普什图语作为阿富汗和巴基斯坦地区的重要语言,在全球范围内拥有数千万使用者,然而在自然语言处理领域,普什图语长期处于资源匮乏状态,尤其是高质量对话数据集的缺失严重制约了该语言在智能对话系统和指令微调大语言模型方面的发展。PashtoNanoChat数据集由研究者NASIMJP于2026年创建,采用Apache-2.0许可证发布,专注于提供结构化的普什图语对话对,其格式兼容OpenAI和Ministral的消息模板。该数据集的核心研究问题在于填补普什图语对话数据的空白,推动低资源语言的对话建模、聊天机器人训练以及文化对齐研究,有望为普什图语大语言模型的微调提供关键数据支撑,对低资源NLP领域的对话系统研究具有重要推动作用。
当前挑战
PashtoNanoChat数据集旨在解决普什图语在对话系统开发中的领域问题:由于缺乏大规模、高质量的对话数据,普什图语聊天机器人难以实现自然流畅的交互,大语言模型在文化对齐与指令遵循方面表现欠佳,严重限制了该语言在智能客服、教育辅助等实际场景中的应用。在构建过程中,数据集面临多重挑战:首先,普什图语作为一种形态复杂、方言众多的语言,对话数据的收集与规范化标注极其困难;其次,高质量的对话对需兼顾语义准确性与文化适应性,避免机器翻译带来的生硬感;此外,低资源环境下缺乏成熟的自然语言处理工具链,使得数据清洗、格式转换与质量审核面临较大阻力。
常用场景
经典使用场景
在普什图语这一低资源语言的对话系统研究中,PashtoNanoChat以其结构化的对话对形式,为构建普什图语聊天机器人、指令微调大语言模型以及对话代理提供了不可或缺的数据基础。该数据集遵循OpenAI/Ministral的消息格式,每一轮对话均清晰标注用户与助手的角色,使得研究者能够直接将其应用于对话生成的监督学习训练。它的出现填补了普什图语在高质量对话数据方面的空白,为后续面向低资源语言的自然语言处理研究开辟了新的路径,尤其是在对话建模和语言模型对齐领域发挥着标杆作用。
实际应用
在实际应用中,PashtoNanoChat直接赋能了普什图语聊天机器人的开发与部署。无论是面向普什图语用户的客服系统、教育辅助工具,还是社区交互助手,该数据集都能作为训练语料,使模型学会流畅的普什图语对话技巧。借助其结构化格式,开发者可以轻松将数据集集成到当前主流的大语言模型训练框架中,实现对开源模型的普什图语指令微调,从而打造出符合普什图文化语境、表达地道的智能对话产品。这一数据集的出现降低了构建普什图语AI应用的门槛,让该语言社群能够享受到更智能、更贴切的人机交互服务。
衍生相关工作
围绕PashtoNanoChat,一系列衍生工作应运而生。最直接的关联工作是普什图语大语言模型的指令微调实验,研究者利用该数据集对已有的多语言模型进行参数更新,以提升其在普什图语对话任务上的表现。此外,该数据集也催生了普什图语对话质量评估基准的构建,促使学界关注低资源语言对话系统的评测标准。更深远地,PashtoNanoChat作为低资源对话数据的典范,启发了其他语言(如乌尔都语、达里语)对话数据集的构建方法,推动了跨语种对话模型泛化能力的研究,成为低资源自然语言处理社区中一个重要的参考案例。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

