unified-hausa-speech
收藏资源简介:
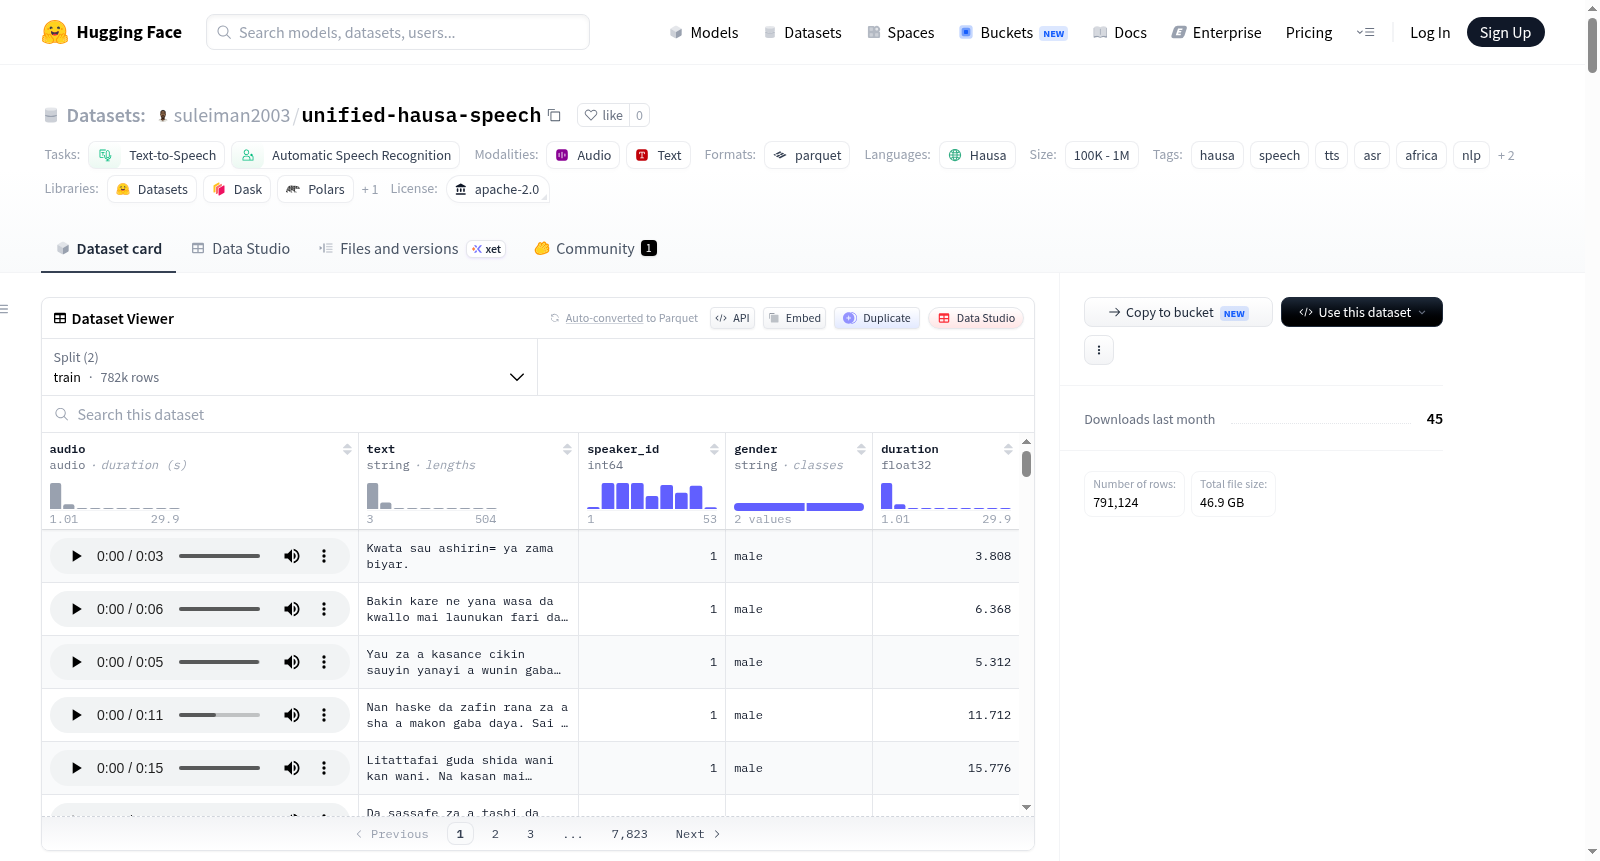
Unified Hausa Speech Dataset v5是一个大规模、经过清洗、去重和质量过滤的豪萨语语音数据集,由6个开源语音集合(WaxalNLP、NaijaVoices、BibleTTS、TWB Voice、AfricanVoices和Common Voice)统一编译而成。豪萨语(ISO 639-1: ha)是乍得语系语言,由西非和中非超过8000万人使用,主要分布在尼日利亚和尼日尔,并作为萨赫勒地区的贸易语言。尽管使用人口众多,但与全球语言相比,高质量的豪萨语语音数据仍然稀缺。该数据集通过整合、清洗和标准化多个现有豪萨语语音集合,创建了一个可直接用于训练的资源,旨在支持文本到语音(TTS)和自动语音识别(ASR)研究。数据集包含约791,124个音频片段,总时长约706.8小时,其中训练集782,297个片段(697.84小时),测试集8,827个片段(8.96小时)。共有2,110个独特说话人(训练集2,059个,测试集51个)。每个样本包含以下特征:音频(16 kHz单声道FLAC格式,经过静音修剪和响度标准化至-20 dBFS)、文本(NFC标准化的豪萨语转录)、说话人ID(整数,跨来源唯一)、性别(“male”、“female”或“other”)、时长(秒)。数据集按说话人ID排序,便于说话人自适应TTS和说话人嵌入提取。质量过滤包括剔除时长小于1秒或大于30秒、过度削波(>1%)等不合格片段,共拒绝14,592个片段。去重基于音频哈希和文本哈希跨来源进行。音频处理流程包括重采样至16kHz、降噪、静音修剪、响度标准化、质量检查和FLAC编码。该数据集适用于TTS、ASR、说话人自适应微调、说话人嵌入提取、说话人日记化评估等任务。已知限制包括性别元数据可能不准确、同一说话人可能在不同来源中出现多次、方言变体混合、录音条件差异大、转录文本未经独立验证、无强制对齐等。所有数据均来自公开许可的源数据集,说话人标识符已匿名化。
Unified Hausa Speech Dataset v5 is a large-scale, cleaned, deduplicated, and quality-filtered Hausa speech dataset compiled from six open-source speech collections (WaxalNLP, NaijaVoices, BibleTTS, TWB Voice, AfricanVoices, and Common Voice). Hausa (ISO 639-1: ha) is a Chadic language spoken by over 80 million people in West and Central Africa, primarily in Nigeria and Niger, and serves as a trade language in the Sahel region. Despite its large number of speakers, high-quality Hausa speech data remains scarce compared to global languages. This dataset integrates, cleans, and standardizes multiple existing Hausa speech collections to create a resource ready for training, aiming to support text-to-speech (TTS) and automatic speech recognition (ASR) research. The dataset contains approximately 791,124 audio clips with a total duration of about 706.8 hours, including 782,297 clips (697.84 hours) for training and 8,827 clips (8.96 hours) for testing. There are 2,110 unique speakers (2,059 in training, 51 in testing). Each sample includes: audio (16 kHz mono FLAC format, silence trimmed and loudness normalized to -20 dBFS), text (NFC-normalized Hausa transcription), speaker ID (integer, unique across sources), gender (male, female, or other), and duration (seconds). The dataset is sorted by speaker ID to facilitate speaker-adaptive TTS and speaker embedding extraction. Quality filtering removed clips shorter than 1 second or longer than 30 seconds, with excessive clipping (>1%), resulting in 14,592 rejected clips. Deduplication was performed based on audio hashes and text hashes across sources. Audio processing includes resampling to 16 kHz, noise reduction, silence trimming, loudness normalization, quality check, and FLAC encoding. The dataset is suitable for TTS, ASR, speaker-adaptive fine-tuning, speaker embedding extraction, and speaker diarization evaluation. Known limitations include potentially inaccurate gender metadata, possible reappearance of the same speaker across sources, mixed dialect variations, diverse recording conditions, unverified transcriptions, and lack of forced alignment. All data comes from publicly licensed source datasets, and speaker identifiers have been anonymized.
Unified Hausa Speech Dataset v5 数据集详情
数据集概述
Unified Hausa Speech Dataset v5 是一个大型、清理过、去重且经过质量过滤的豪萨语(Hausa)语音数据集,由 6 个开源语音集合整合而成。该数据集专为豪萨语的文本到语音(TTS) 和自动语音识别(ASR) 研究设计,旨在弥补豪萨语(全球使用者超过8000万)高质量语音数据稀缺的问题。
基本信息
| 属性 | 详情 |
|---|---|
| 语言 | 豪萨语(ha) |
| 许可证 | Apache 2.0 |
| 任务类别 | 文本到语音(TTS)、自动语音识别(ASR) |
| 数据规模 | 100K < n < 1M |
| 标签 | hausa, speech, tts, asr, africa, nlp, low-resource, multi-speaker |
关键特性
- 音频格式:16 kHz 单声道 FLAC,已进行静音剪裁,响度标准化至 −20 dBFS
- 文本:NFC 标准化处理的豪萨语转写文本
- 说话人:顺序整数 ID,在不同处理流水线运行间保持稳定
- 排序:同一说话人的所有音频片段连续排列,有利于说话人自适应 TTS 和说话人嵌入提取
- 去重:通过音频哈希和转写文本进行跨来源去重
- 质量过滤:对时长、削波和空音频进行了过滤
数据规模统计
| 指标 | 训练集 | 测试集 | 总计 |
|---|---|---|---|
| 音频片段总数 | 782,297 | 8,827 | 791,124 |
| 总时长 | 697.84 小时 | 8.96 小时 | 706.8 小时 |
| 唯一说话人数 | 2,059 | 51 | 2,110 |
| 平均片段时长 | 3.211 秒 | 3.654 秒 | — |
数据字段结构
| 字段 | 类型 | 描述 |
|---|---|---|
audio |
Audio(16 kHz) | 单声道 FLAC 音频,静音剪裁,响度标准化至 −20 dBFS |
text |
string | NFC 标准化豪萨语转写文本 |
speaker_id |
int64 | 唯一的顺序说话人标识符 |
gender |
string | "male"、"female" 或 "other" |
duration |
float32 | 音频片段时长(秒,处理后) |
数据划分
- 训练集:来自 WaxalNLP、NaijaVoices(3 批次)、BibleTTS 训练集、TWB Voice 训练集、AfricanVoices(6 批次)、Common Voice 训练集
- 测试集:来自 BibleTTS 测试集 + 开发集、TWB Voice 开发集 + 测试集、Common Voice 开发集 + 测试集(持出评估数据,不混入训练集)
数据来源
| 来源 | 仓库 | 保留片段数 | 输出划分 |
|---|---|---|---|
| WaxalNLP | google/WaxalNLP |
1,435 | 训练集 |
| NaijaVoices | naijavoices/naijavoices-dataset |
308,100 | 训练集 |
| BibleTTS | vpetukhov/bible_tts_hausa |
22,057 | 训练集 + 测试集 |
| TWB Voice | CLEAR-Global/TWB-Voice-1.0 |
7,032 | 训练集 + 测试集 |
| AfricanVoices | https://africanvoices.io | 30,237 | 训练集 |
| Common Voice | Mozilla Common Voice 26.0 | 3,219 | 训练集 + 测试集 |
时长分布(训练集)
| 时长范围 | 片段数 | 百分比 |
|---|---|---|
| < 2 秒 | 210,276 | 26.9% |
| 2 — 5 秒 | 473,249 | 60.5% |
| 5 — 10 秒 | 86,453 | 11.1% |
| 10 — 20 秒 | 11,367 | 1.5% |
| 20 — 30 秒 | 952 | 0.1% |
性别分布
按说话人数量:
| 性别 | 训练集说话人数 | 测试集说话人数 |
|---|---|---|
| 男性 | 1,111 | 18 |
| 女性 | 947 | 13 |
| 其他/未知 | 1 | 20 |
按音频片段数量:
| 性别 | 训练集片段数 | 测试集片段数 |
|---|---|---|
| 男性 | 412,849 | 3,115 |
| 女性 | 367,645 | 4,296 |
| 其他/未知 | 1,803 | 1,416 |
音频处理流水线
- 重采样至 16 kHz 单声道
- 通过谱门控进行降噪
- 基于能量检测的静音剪裁(25 dB 阈值)
- 响度标准化至 −20 dBFS
- 质量检查:时长边界、削波比率、空音频检测
- FLAC 编码(16-bit PCM)
质量过滤统计
| 过滤原因 | 拒绝片段数 |
|---|---|
| 无说话人 ID | 0 |
| 过短(< 1.0 秒) | 4,294 |
| 过长(> 30.0 秒) | 9,995 |
| 削波过多(> 1%) | 303 |
| 处理后为空 | 0 |
| 处理错误 | 0 |
| 总计拒绝 | 14,592 |
已知局限
- 性别元数据质量:许多来源将性别视为可选或自我报告字段
- 跨来源说话人重叠:同一物理说话人可能出现在多个来源数据集中,但未进行跨来源说话人关联
- 方言差异:豪萨语有多种方言变体,本数据集混合了方言变体
- 录音条件:音频质量因来源不同差异较大
- 转写准确性:转写文本直接取自各来源,未进行独立验证或纠正
- 无强制对齐:未在词级别验证音频-文本对齐
使用方式
可通过 Hugging Face datasets 库加载:
python from datasets import load_dataset
ds = load_dataset("suleiman2003/unified-hausa-speech") train = load_dataset("suleiman2003/unified-hausa-speech", split="train") test = load_dataset("suleiman2003/unified-hausa-speech", split="test")
也支持流式加载、按说话人/性别过滤,以及与 Transformers 库(如 Whisper)配合进行 ASR 微调。
许可证
Apache 2.0 — 需同时遵守各原始来源的附加许可条款。