
遇见数据集

WithinUsAI/The_Autonomy_From_WithIn_10k

收藏
Hugging Face2026-06-07 更新2026-06-14 收录
官方服务:

资源简介:

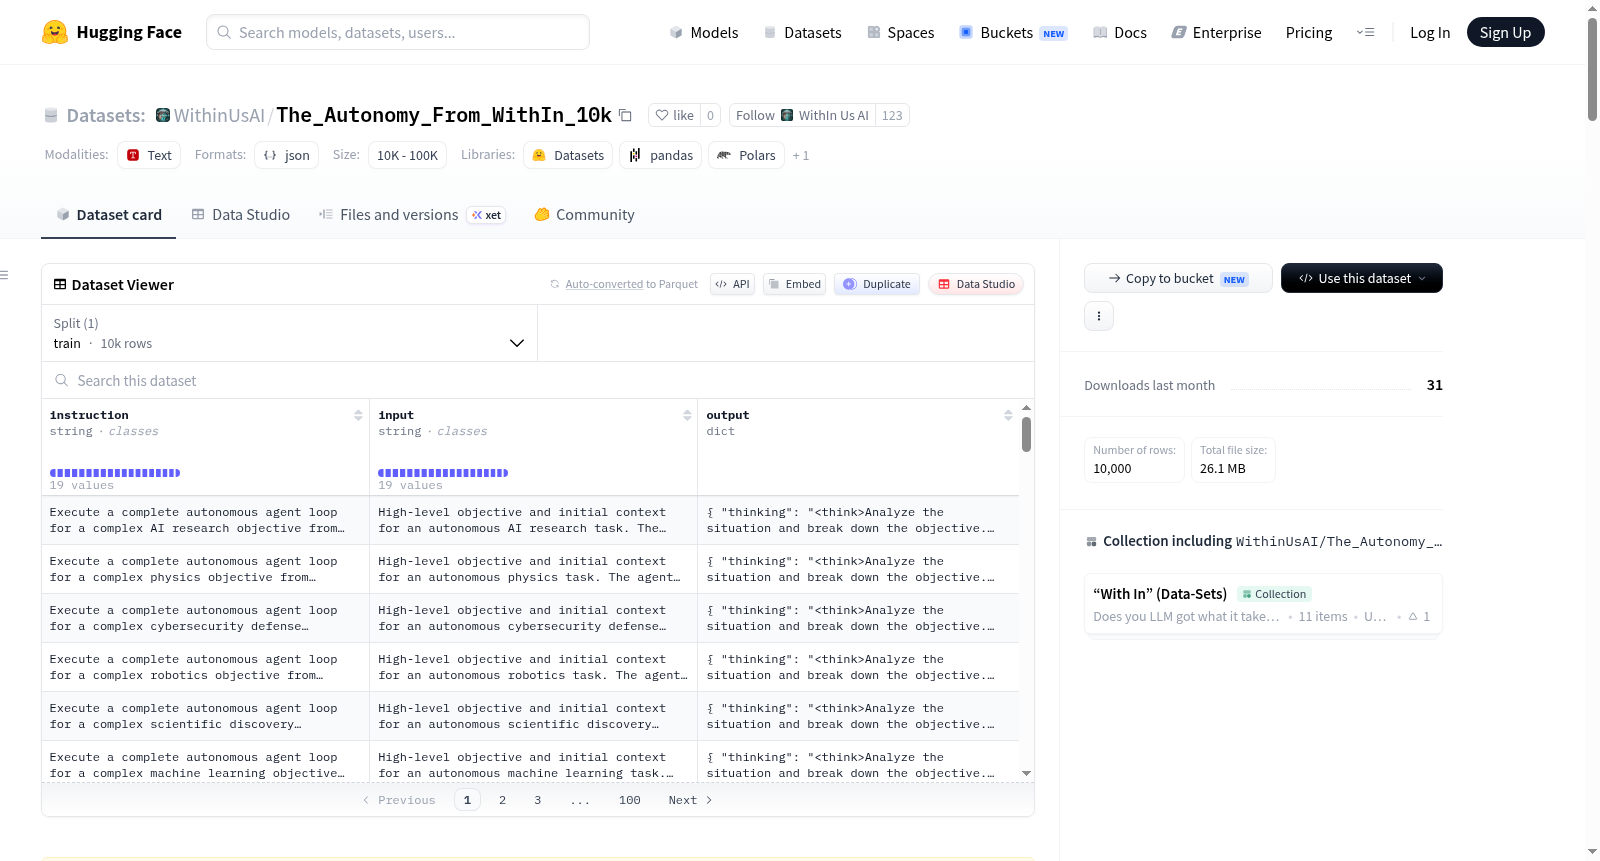
The_Autonomy_From_WithIn_10k 是一个前沿质量的数据集,旨在训练高级自主代理语言模型,涵盖完整的端到端自主代理循环,从目标分配、情境分析、规划、执行、验证、恢复(需要时)、记忆更新到验证成功完成。该数据集整合并融合了工具、技能、规划、验证、恢复、记忆、工作流、决策和研究等概念,形成现实、专业、完整轨迹的代理示例。每个示例都展示了在<thinking>标签内的专业调查、规划、执行、验证、适应和完成推理。

The_Autonomy_From_WithIn_10k is a frontier-quality dataset designed to train advanced autonomous agentic language models on complete end-to-end autonomous agent loops — from objective assignment through situation analysis, planning, execution, verification, recovery (when needed), memory updates, and verified successful completion. This dataset integrates and combines concepts from tools, skills, planning, verification, recovery, memory, workflows, decisions, and research into realistic, professional, full-trajectory agent examples. Every example demonstrates professional investigation, planning, execution, verification, adaptation, and completion reasoning inside <thinking> tags.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/The_Autonomy_From_WithIn_10k 数据集图片
构建方式
该数据集由WithinUsAI团队精心构建,包含10,000条独特的专业智能体轨迹样本,采用JSONL格式存储。每条样本均模拟了从目标设定到情景分析、规划、执行、验证、恢复、记忆更新直至最终完成的完整自主循环过程。构建过程中实施了严格的语义与结构去重策略,确保无重复或低质量内容,并通过逻辑连贯性、专业性及领域覆盖度等多维度验证,以保证样本真实反映前沿智能体的端到端行为模式。
特点
数据集的核心特色在于其完整集成了工具使用、技能调度、规划推理、验证反馈、异常恢复、记忆管理、工作流决策与研究探索等多元能力,形成高度真实的专业轨迹。每条样本均在<think>标签内展示完整的专业推理痕迹,涵盖情景评估、优先级排序、执行逻辑、验证机制与自我修正过程。这种集成式设计使得数据能够有效训练智能体模型掌握长程可靠性与可追溯推理能力,适应复杂现实场景下的自主任务。
使用方法
该数据集适用于对大规模语言模型进行监督微调,以增强其全自主智能体循环能力。训练时建议保留完整的<think>推理链用于思维链学习,使模型能够从高层次目标出发,自主驱动至验证完成。典型应用包括智能体开发、AI模型训练、ML流水线部署、云端运维、项目管理、网络安全防御等。通过模仿数据集中的结构化轨迹,模型可逐步掌握专业级的任务规划、执行验证与记忆更新机制。
背景与挑战
背景概述
The_Autonomy_From_WithIn_10k数据集由WithIn Us Ai于2026年创建,旨在训练前沿自主智能体语言模型。随着人工智能从被动响应向主动规划与执行演进,如何使模型掌握完整的端到端自主智能体循环——从目标指派、情境分析、计划制定、工具执行、验证、恢复、记忆更新到任务完成——成为核心研究问题。该数据集包含一万条独一无二的专业实例,覆盖软件工程、机器学习、云部署、网络安全及企业运营等多个领域,通过详细的思维链展示智能体的推理与决策过程。其发布对自主智能体领域具有里程碑意义,为训练具备长周期可靠性、自纠错能力及可审计轨迹的先进模型提供了关键资源,推动了通用自主智能体从理论走向实践。
当前挑战
该数据集旨在解决自主智能体领域面临的重大挑战:如何使语言模型可靠地执行复杂、多步骤的长期任务,并在遭遇挫折时自主恢复。传统数据集多聚焦于单轮问答或简单工具调用,缺乏对完整智能体循环的建模,导致模型难以应对真实场景中的不确定性与连续性。在构建过程中,主要挑战包括:确保一万条实例在语义、结构及行动序列上无重复,以提供高质量训练信号;验证每条轨迹在逻辑上的连贯性,涵盖从情境分析到记忆更新的每一个环节;以及将工具使用、规划、验证、恢复、记忆等分散能力无缝整合为真实的端到端智能体行为,这对数据生成和校验提出了极高要求。
常用场景
经典使用场景
在自主智能体与大语言模型交叉研究的前沿,《The_Autonomy_From_WithIn_10k》数据集为端到端自主代理行为的训练提供了范式级资源。其经典使用场景在于,通过10,000条完整的专业轨迹数据,训练语言模型掌握从目标解析、情境分析、策略规划、工具执行、质量验证、异常恢复到记忆更新的全闭环自主推理能力。每一条样本均包含封装在<think>标签内的专业思维链,模拟真实世界中复杂、多步骤的专业自主任务,尤其适用于监督微调阶段,帮助模型习得长程可靠性与可追溯的决策逻辑。该数据集已成为构建下一代通用智能代理系统的重要训练基准。
实际应用
在产业落地层面,该数据集训练的智能体已在多个高复杂度专业领域绽放价值。于软件工程与云原生运维中,模型能够自主完成模型部署、CI/CD流水线构建、灰度发布与监控告警系统的搭建;在科学研究场景下,智能体可协同进行实验设计、数据采集与结果验证;企业运营方向,它则胜任合规文档自动化生成、项目风险评估与跨团队任务协调。这些应用不再依赖人工预设的固定流程,而是依托智能体实时分析情境、动态规划行动路径并持续更新记忆,显著提升了自动化系统在现实复杂环境中的鲁棒性与运营效率。
衍生相关工作
该数据集的诞生催生了一系列前沿研究方向与衍生工作。在方法论层面,研究者基于其全轨迹结构启发,发展了更高效的思维链压缩技术与多步骤推理蒸馏策略。在模型层面,已有工作探索将其与工具增强模型、反思式学习框架以及分层记忆网络相融合,构建具备长期连续性的自主代理。此外,该数据集的验证与恢复机制设计,间接推动了可解释自主系统与失败恢复强化学习领域的新范式形成。值得关注的是,其开放性MIT许可协议允许广泛的学术与商业复用,加速了自主智能体研究社区从零散模块向端到端统一系统的跃迁。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

