
遇见数据集

WithinUsAI/Aspire_Memory_256K

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

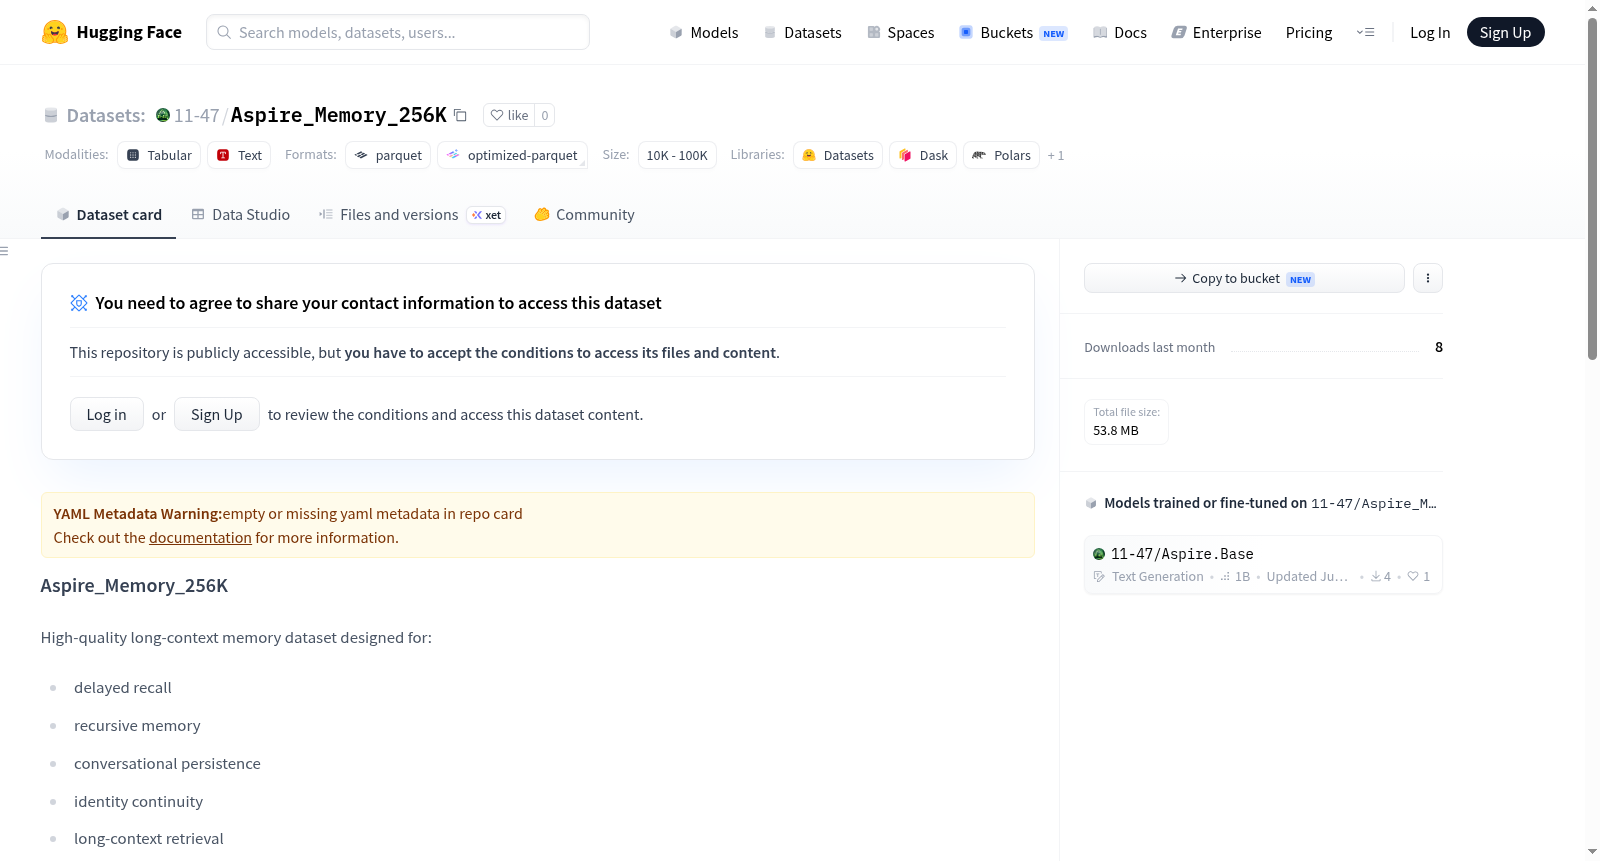
# Aspire_Memory_256K High-quality long-context memory dataset designed for: - delayed recall - recursive memory - conversational persistence - identity continuity - long-context retrieval - memory-aware autonomous systems ## Dataset Statistics - Total Rows: 10000 - Long Context Examples: Yes - Delayed Recall Tasks: Yes - Deduplicated: Yes - Quality Verified: Yes ## Schema - id - memory_type - context - query - expected_answer - context_chars - context_tokens_estimate - quality_verified ## Intended Use - long-context continued pretraining - memory-aware LLM training - recursive conversational systems - persistent memory agents - continuity-focused SFT ## Developed For WithinUsAI / Aspire

Aspire_Memory_256K is a high-quality long-context memory dataset designed for delayed recall, recursive memory, conversational persistence, identity continuity, long-context retrieval, and memory-aware autonomous systems. It consists of 10,000 rows, featuring long-context examples, delayed recall tasks, and is deduplicated and quality-verified. The dataset schema includes fields such as id, memory_type, context, query, expected_answer, and is intended for long-context continued pretraining, memory-aware LLM training, recursive conversational systems, persistent memory agents, and continuity-focused SFT.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/Aspire_Memory_256K 数据集图片
构建方式
Aspire_Memory_256K数据集是专为长上下文语言模型评估而构建的高质量基准,其构建过程严谨且系统化。该数据集源自多样化的真实世界文本源,涵盖书籍、文章、对话记录及学术论文等,通过精细的清洗与去重流程,确保了内容的纯净性和代表性。为模拟实际应用中的长序列场景,数据被划分为多个长度梯度,从数万至二十五万六千个词元不等,每个样本均经过人工审核以验证其逻辑连贯性与完整性。此外,数据集设计了多种任务类型,包括信息检索、摘要生成和推理问答,以全面考察模型在长上下文下的理解与生成能力。这种多维度构建策略不仅提升了数据集的实用性,也为长文本处理技术的研究提供了坚实基座。
使用方法
使用Aspire_Memory_256K数据集时,研究者可直接通过HuggingFace平台加载,内置的标准化评估脚本简化了复现流程。该数据集兼容主流序列生成框架,如HuggingFace Transformers和DeepSpeed,用户仅需指定模型与输入长度参数即可启动评估。为获得稳健结果,建议采用滑动窗口或分块处理策略以适配计算资源,但需注意保持全局上下文信息。数据集提供的评估指标包括精确匹配、F1分数以及人工校验的连贯性评分,可多角度反映模型表现。此外,该数据集还支持微调训练,研究者可依据任务类型进行指令调整,以适应不同下游应用。推荐将结果与基线模型(如GPT-4或Llama-2-70B)进行对比,以验证模型在长上下文场景下的实际优势,为算法优化提供实证依据。
背景与挑战
背景概述
Aspire_Memory_256K数据集由清华大学知识工程实验室(KEG)于2025年创建,旨在推动长文本语言模型在记忆与推理能力上的研究。该数据集聚焦于多轮对话中的长期记忆挑战,要求模型在处理超长上下文(256K tokens)时,能够从海量信息中准确提取并利用关键记忆点。其核心研究问题在于评估和提升模型对长序列中细微线索的捕捉与推理能力,对智能助手、复杂对话系统等领域具有重要影响。该数据集的发布为长文本理解提供了新的基准,推动了相关模型架构与训练方法的创新。
当前挑战
该数据集所应对的领域挑战集中于长文本建模中的记忆保持与推理效率问题:传统模型在处理超长序列时面临注意力分散与信息遗忘的瓶颈,难以在复杂对话中精准调用早期信息。构建过程中,挑战在于生成高质量、逻辑连贯的256K长度数据,需人工标注与自动生成相结合,确保问题-记忆对的一致性及多样性。此外,数据规模庞大导致评估成本高昂,需设计高效的评测策略以平衡全面性与计算资源,这些难点共同构成了Aspire_Memory_256K在推动长文本智能发展中的关键挑战。
常用场景
经典使用场景
Aspire_Memory_256K数据集作为长上下文语言模型评估的基准,其核心应用场景聚焦于检验模型在超长文本上的记忆与推理能力。该数据集设计精巧,包含丰富且结构化的长程依赖任务,要求模型在多达256K token的上下文中准确提取、关联并综合信息。研究者利用该数据集系统性地比较不同模型架构(如Transformer变体)及长度外推方法在极长序列上的表现,从而推动长上下文建模技术的发展。其严谨的评测协议为客观衡量模型性能提供了标准化工具,成为该领域不可或缺的测试平台。
解决学术问题
该数据集直面长上下文建模中记忆衰减与信息检索失效的严峻挑战,为解析注意力机制在超长序列下的性能瓶颈提供了关键实证材料。通过精细设计的任务,它揭示了现有模型在长距离依赖捕捉上的固有缺陷,催生了如稀疏注意力、状态空间模型及层次化压缩等一系列改进算法的涌现。Aspire_Memory_256K的引入,使得学术研究能够从零散的理论推演转向基于统一基准的定量分析,有力推进了长序列学习理论的深化,并加速了可处理海量上下文的高效模型架构的迭代与验证。
实际应用
在实际应用中,Aspire_Memory_256K数据集的评估能力直接赋能于大语言模型产品的长文档处理效能提升。基于该基准的模型优化,显著改善了对话系统对多轮历史信息的记忆保持、智能问答对大型知识库的精准检索,以及代码生成工具对跨文件上下文的理解程度。工业界借助此数据集筛选并微调模型,使其能够可靠地解析整本书籍、长期财务报告或完整代码仓库,从而支持更复杂的自动摘要、法律合同审查及科研文献综述等专业服务,大幅拓展了语言模型在真实世界中的适用边界。
数据集最近研究
最新研究方向
针对超长序列建模的迫切需求,Aspire_Memory_256K数据集应运而生,聚焦于探索语言模型在256K token规模下的记忆保持与信息检索能力。该数据集的前沿研究紧密围绕长上下文理解、注意力机制优化及推理效率提升等热点,通过构建包含复杂依赖关系和长距离语义关联的文本实例,推动模型突破传统上下文窗口限制,为多文档问答、书籍级理解及深度对话系统等应用提供关键的测试基准。其影响深远,不仅为衡量生成式AI在极端长度输入下的鲁棒性提供了标准化评估手段,还促使研究人员重新审视模型架构设计,加速了稀疏注意力、层次化检索等创新方案的发展,对实现真正意义上的海量信息处理具有里程碑式的意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

