
遇见数据集

CoSHE-500

收藏
Hugging Face2026-06-18 更新2026-06-19 收录
官方服务:

资源简介:

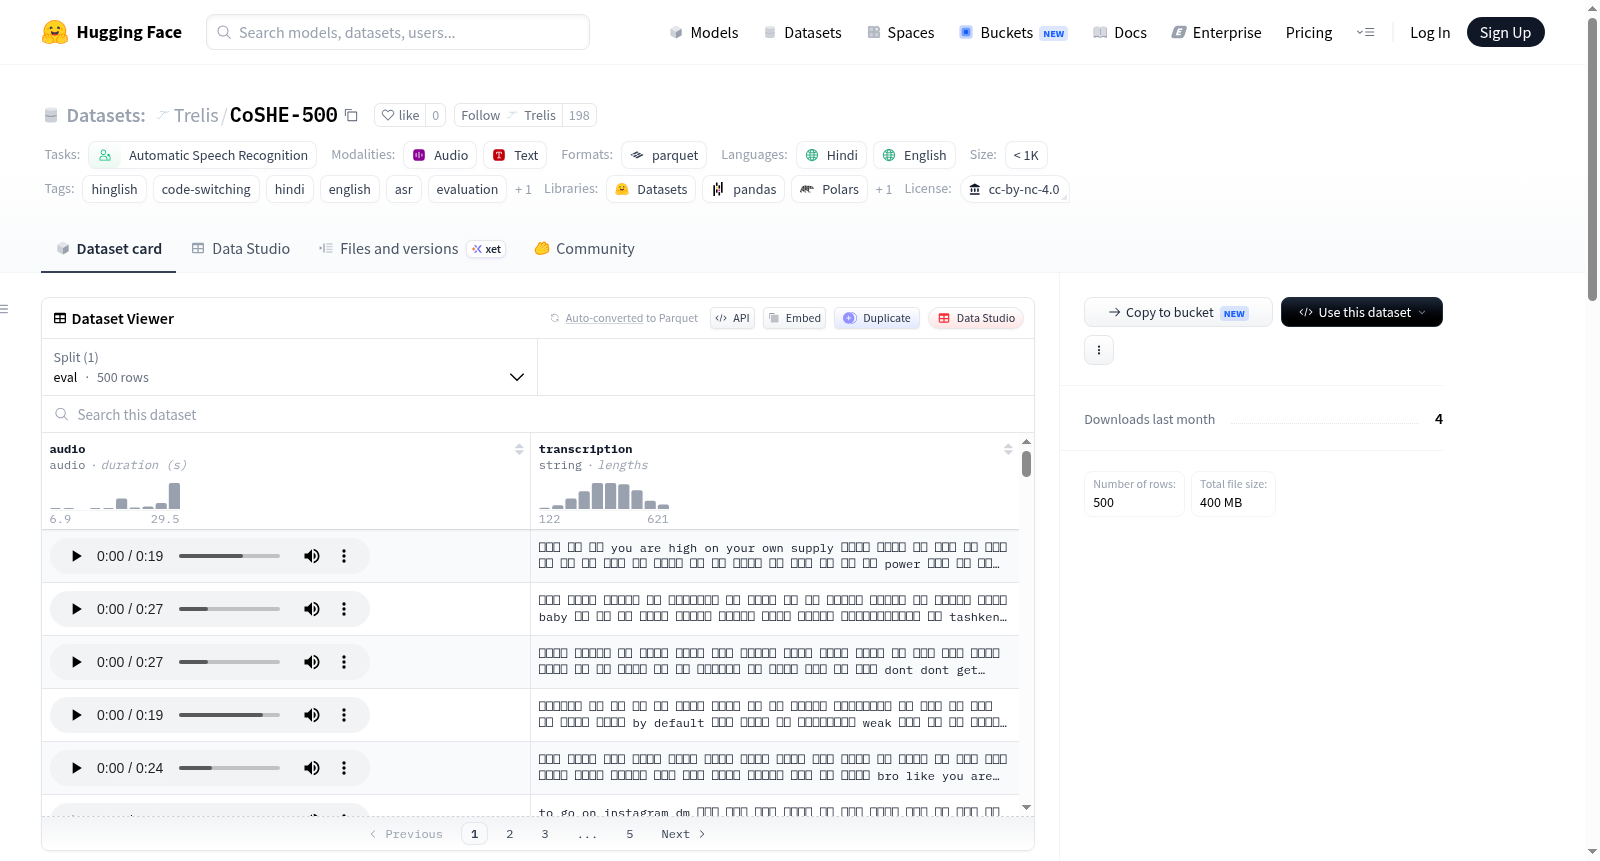
CoSHE-500(对话式印地英语语音评估)是一个专门用于评估自动语音识别系统在印地语-英语代码转换(Hinglish)场景下性能的数据集。该数据集包含500个对话语音片段,每个片段时长约30秒,采样率为16kHz单声道,并提供了逐字记录的混合脚本(天城文用于印地语,拉丁文用于英语)参考转录。数据内容为真实的对话语音,其中单个话语内存在印地语和英语的代码转换现象。该数据集旨在衡量ASR模型在现实世界代码转换环境中的性能,这是许多印地语/英语模型性能下降的典型场景。数据集仅用于评估和基准测试,不建议用于训练,以保持其作为公平公开基准的完整性。使用时应采用脚本安全的印度语文本规范化流程进行词错误率计算,并注意声明输出文本的书写规范。数据集基于CC-BY-NC-4.0许可分发,要求署名且仅限非商业用途。

CoSHE-500 (Conversational Speech in Hinglish for Evaluation - 500) is a dataset specifically designed for evaluating the performance of automatic speech recognition systems in Hindi-English code-switching (Hinglish) scenarios. It contains 500 conversational speech clips, each approximately 30 seconds long, with a sampling rate of 16kHz mono, and provides verbatim reference transcriptions in a mixed script (Devanagari for Hindi, Latin for English). The data consists of real conversational speech featuring intra-utterance code-switching between Hindi and English. The dataset aims to measure the quality of ASR models in real-world code-switching environments, a typical scenario where many Hindi/English models experience performance degradation. It is intended solely for evaluation and benchmarking, not for training, to preserve its integrity as a fair and open benchmark. When used, a script-safe Indian text normalization pipeline should be applied for word error rate calculation, and the writing standard of the output text should be declared. The dataset is distributed under the CC-BY-NC-4.0 license, requiring attribution and permitting only non-commercial use.
提供机构:
Trelis
创建时间:
2026-06-18
搜集汇总
数据集介绍
CoSHE-500 数据集图片
构建方式
CoSHE-500数据集源自Soket Labs发布的CoSHE-Eval大型评估语料库,经过精心筛选与后处理构建而成。研究者从原始语料中抽取了500条对话语音片段,每条时长约30秒,并进行了统一的16kHz单声道重采样。此外,数据集对转录文本进行了细致整理,保留了印地语的天城文与英语拉丁文混合书写的原始形态,未施加任何强制转写,从而忠实还原了印地语-英语代码转换(Hinglish)的真实语言面貌。
使用方法
使用者可通过HuggingFace Datasets库直接加载该数据集的eval分割,获取包含audio字段(16kHz numpy数组)与transcription字段(混合脚本转录文本)的样本。在评估ASR模型时,推荐采用脚本安全的Indic文本归一化方案:该方案需保留天城文的元音符号与鼻化点、对拉丁字母进行小写化、去除标点符号,且严禁执行音素转写或数字归一化。最终通过计算语料级词错误率(corpus WER)来量化系统性能,同时需明确标注系统的输出格式以避免评分偏差。
背景与挑战
背景概述
在自动语音识别(ASR)领域,多语言与代码转换语音的识别历来是研究难点,尤其在印地语与英语混合的“Hinglish”场景中,现有模型性能显著下降。CoSHE-500数据集由Soket Labs团队于近年创建,核心研究问题聚焦于评估ASR系统在真实对话级Hinglish代码转换语音上的识别质量。该数据集精心挑选500条约30秒的对话片段,保留原汁原味的混合文字转录(天城文+拉丁文),为衡量现实世界中代码转换ASR性能提供了标准化的测试基准。其发布填补了Hinglish语音评估集的空白,推动了多语言ASR评测的严谨性,对南亚语言技术社区产生了重要影响。
当前挑战
该数据集所解决的领域挑战主要在于:Hinglish代码转换语音的ASR评估缺乏统一标准,传统WER计算在混合文字转录中因标准化处理(如Whisper默认文本标准化器会剥离天城文附标)而严重失真,导致模型性能被错误低估。构建过程中面临的挑战包括:从原始CoSHE数据集(soketlabs/CoSHE-Eval)中筛选出500个代表性片段,确保每个约30秒的对话自然且涵盖丰富代码转换模式;同时维护转录的逐字准确性,避免强制音译带来的信息损失,并设计出能够保留天城文和拉丁文混合拼写的脚本安全标准化方案,以支持公平的基准对比。
常用场景
经典使用场景
在自动语音识别(ASR)领域,评估模型在混合语言场景下的表现一直是极具挑战的课题。CoSHE-500作为精心挑选的500条印地语-英语代码混合会话语音评估集,其经典使用场景聚焦于衡量ASR系统在真实对话中处理多种语言交织的能力。研究者常利用该数据集测试Whisper、Wav2Vec 2.0等主流模型在面对Hinglish代码混合语音时的词错误率,尤其在语音中同时出现天城文与拉丁文转录的复杂情况下,该数据集成为检验系统稳健性的天然试金石。
解决学术问题
该数据集直面了多语言ASR研究中长期存在的评估瓶颈——即现有基准测试往往忽略代码混合现象,导致模型在真实复杂场景下的表现被高估。CoSHE-500解决了对混合语言语音进行标准化、细粒度评估的难题,尤其揭示了默认文本标准化方法会因剥离天城文元音符号而显著膨胀词错误率的严重问题。其学术意义在于推动研究者重新审视ASR评估流程,并为跨语言语音理解、对比语言学中的语言接触现象提供了可量化的实验支撑。
实际应用
CoSHE-500的实际应用价值体现在南亚多语言社会数字化转型的多个层面。在智能语音助手产品中,该数据集可作为质检基准,确保华为、小米等品牌的印地语语音界面能准确理解用户混用英语的日常指令。此外,面向印度、巴基斯坦等国的口语翻译系统与呼叫中心自动化服务,可借助该数据集评估模型对真实会话中语言切换的响应能力,从而提升金融问答、医疗问诊等场景下语音交互的鲁棒性与用户体验。
数据集最近研究
最新研究方向
CoSHE-500作为印地语-英语混合语码(Hinglish)会话语音评估基准,其前沿研究方向聚焦于真实场景下代码转换自动语音识别(ASR)系统的鲁棒性评测。随着多语言AI应用在印度次大陆的爆发式增长,传统ASR模型在处理日常会话中频繁出现的梵文天城体与拉丁字母混合书写时往往性能骤降。该数据集通过保留原始语码转换的拼写形式(不进行强制音译),创新性地揭示了现有归一化算法对天城体元音附标符号的破坏性问题——例如Whisper默认文本归一化机制会显著夸大印地语词错误率。研究热点集中于开发脚本感知型的评估管线,强调在保持天城体辅音与nuqta区分的基础上,仅对拉丁字母部分执行小写化处理而避免数字归一化。这一标准直接影响了印度本土语音助手、多模态对话系统及实时翻译服务的质量度量体系,推动行业从单语言WER向跨脚本混合评估范式的转型。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

