
BleachNick/CraftBench
收藏官方服务:
资源简介:
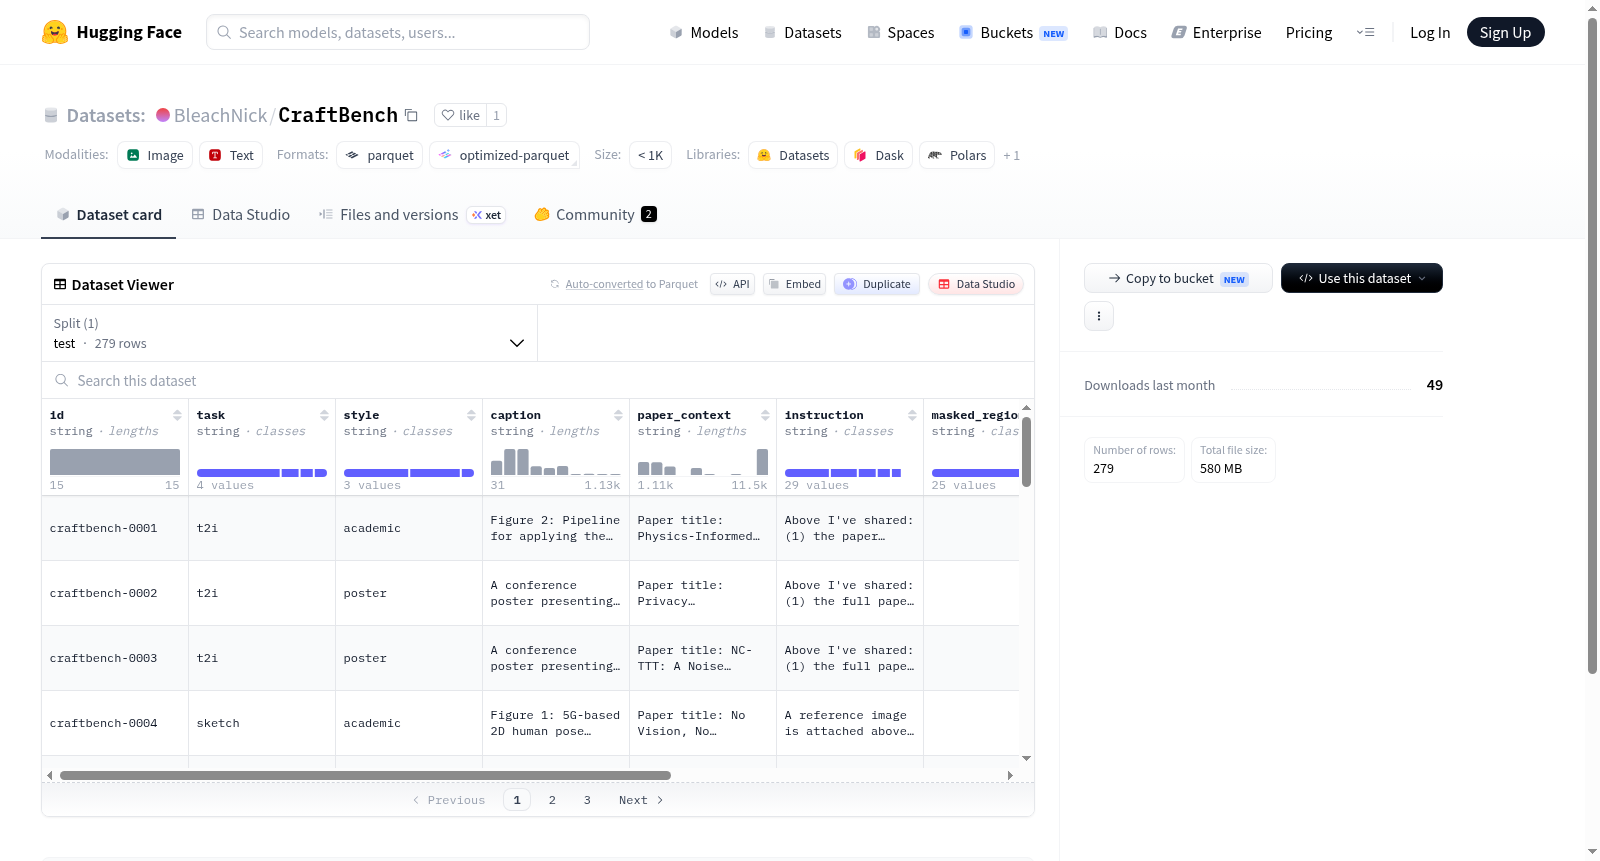
该数据集是一个多模态测试数据集,包含279个示例,每个示例具有id、任务类型、风格、标题、论文上下文、指令、掩码区域、输入图像和目标图像等字段。数据集中文描述未在README中明确提供,基于字段分析,它可能用于图像生成、编辑或理解任务,结合文本指令和图像内容进行测试。
This dataset is a multimodal test dataset containing 279 examples, each with fields such as id, task, style, caption, paper_context, instruction, masked_region, input_image, and target_image. The dataset description is not explicitly provided in the README; based on field analysis, it may be used for image generation, editing, or understanding tasks, combining textual instructions and image content for testing.
提供机构:
BleachNick搜集汇总
数据集介绍
构建方式
CraftBench数据集的构建旨在评估多模态大模型在精细图像编辑任务上的表现。该数据集包含279个测试样本,每个样本由唯一标识符、任务类型、风格标签、描述文本、论文上下文、指令信息以及掩码区域构成。数据集的图像部分包括输入图像与目标图像,其中输入图像为待编辑的原始图像,目标图像为编辑后的标准答案。通过覆盖多样化的任务与风格,CraftBench为研究图像编辑中的指令遵循与掩码约束提供了系统化的测试基准。
特点
CraftBench数据集具有鲜明的特点。首先,它聚焦于精细图像编辑场景,强调对局部区域的精确修改。其次,每个样本均包含详细的论文上下文与指令信息,使得任务描述更加丰富和严谨。此外,数据集覆盖多种任务类型与风格标签,能够评估模型在不同图像编辑需求下的泛化能力。最后,掩码区域的引入使得模型必须准确理解编辑范围,从而提升了评估的挑战性与针对性。
使用方法
使用CraftBench数据集时,用户需要加载输入图像与对应的掩码区域,并根据指令生成编辑后的目标图像。评估过程中,研究者可将模型生成的编辑结果与数据集提供的target_image进行对比。推荐采用自动化指标(如CLIP Score、L1/L2距离)和人工评测相结合的方式,全面衡量模型在指令遵循、区域精准度及视觉保真度上的表现。数据集已按标准格式划分,便于直接接入多模态模型训练或测试流程。
背景与挑战
背景概述
CraftBench数据集由研究团队于近年创建,旨在评估和推动视觉与语言模型在精细操控与手工制作任务中的表现。该数据集聚焦于理解模型如何根据自然语言指令和图像上下文,对指定区域进行精确的视觉修改或生成,其核心研究问题涉及多模态理解、指令跟随与图像编辑能力的交叉领域。CraftBench通过提供包含任务描述、风格信息、图像掩码及输入输出对的结构化样本,为相关领域的研究者提供了标准化的评估基准,对推动具身智能、人机交互及创意内容生成等领域的发展具有重要影响力。
当前挑战
CraftBench数据集直面两大核心挑战:一是解决视觉与语言模型在精细操控任务中的领域难题,即模型需从复杂的自然语言指令中准确解析出操作目标、风格约束及区域限定,并生成符合要求的局部图像修改,这要求模型具备高度的多模态对齐与空间推理能力;二是构建过程中遇到的挑战,包括收集多样化的手工制作任务样本、确保图像掩码的精确性以定义局部修改区域、以及设计指令与背景信息的自然语言表述以避免歧义,同时维护数据规模与质量的高标准平衡。
常用场景
经典使用场景
在视觉与语言交叉研究领域,CraftBench数据集为评估模型在程序化图像编辑任务中的表现提供了标准化基准。其核心设计围绕“指令驱动的图像区域修改”展开,要求模型根据文本描述(如风格迁移、物体替换或局部修复)对图像中指定的遮罩区域进行精准改造。该数据集涵盖了279个多样化的编辑任务,每个样本均包含原始图像、目标图像、自然语言指令及任务标签,使得研究者能够系统性地测试模型在理解复杂视觉语义与执行细粒度编辑操作方面的能力。其独特的“程序化编辑”框架,尤其适合验证模型是否具备将抽象语言指令转化为具体像素级操作的推理能力。
衍生相关工作
CraftBench的发布催生了一系列围绕‘指令式图像编辑’的经典研究。例如,后续工作提出了基于扩散模型的‘区域条件控制’方法,通过解耦语言编码与空间注意力来提升编辑精度;另有研究者利用该数据集构建了‘编辑意图识别器’,实现了从任务描述到编辑动作的端到端映射。在模型评估方面,基于CraftBench的质量指标(如编辑区域PSNR、指令匹配准确率)被广泛采纳为行业标准。此外,该数据集还启发了‘多轮对话编辑’方向的研究,使得模型能够在连续交互中逐步完善编辑结果,推动了人机协作创作领域的理论发展。
数据集最近研究
最新研究方向
CraftBench数据集聚焦于细粒度视觉指令跟随与空间感知生成任务,其设计蕴含了遮挡区域推理与多模态条件对齐的前沿理念。近期研究倾向于利用该数据集评估大语言模型在复杂场景下根据文本指令精准编辑图像局部区域的能力,尤其是在需要结合上下文语义与视觉掩码信息的任务中。这一方向与可控图像生成、个性化内容创作等热点领域紧密相关,其标准化的评估框架为模型的空间理解与指令忠实度提供了关键基准,推动了多模态智能从粗粒度匹配向细粒度交互的演进。
以上内容由遇见数据集搜集并总结生成


