
poolside-laguna-hackathon/processrl-terminal-environments
收藏数据链接:
官方服务:
资源简介:
ProcessRL 是一个行为条件的终端环境集合,用于训练和评估代理过程控制。任务设计围绕交互式终端工作中出现的失败:在误导性成功命令后停止、重复无效操作、在死胡同后未能转向、丢失迁移状态跟踪以及留下未完成的局部进展。
ProcessRL is a collection of behavior-conditioned terminal environments for training and evaluating agent process control. The tasks are designed around failures that appear in interactive terminal work: stopping after a misleading successful command, repeating an unproductive action, failing to pivot after a dead end, losing track of migrated state, and leaving partial progress unfinished.
搜集汇总
数据集介绍
构建方式
ProcessRL Terminal Environments 数据集的构建历经一套严谨的多阶段流水线。首先,研究者深入剖析终端智能体轨迹,捕捉那些不以最终正确性为唯一导向的过程控制失败模式,例如在误导性成功命令后停滞、重复无效操作或死胡同后未能转向等。继而,将此类反复出现的行为缺陷转化为生成约束,涵盖验证导向动作、死胡同后动作转向、有界搜索、校准停止及状态化进度追踪等维度。在此基础上,生成候选终端环境,囊括任务指令、初始状态设置、最终状态验证器与容器构建配方。唯有通过环境构建、启动、初始状态检查、接受良性命令并暴露可调用验证器的候选者方能准入。随后,通过基线智能体的重复回滚对通过的环境进行校准,选取成功率既不恒为零亦非恒为一的任务以提供有意义的奖励信号。最后,经由更强参考求解器对基线未能解决的任务进行筛选,剔除无解案例,最终形成训练集与分层独立的留出集。
特点
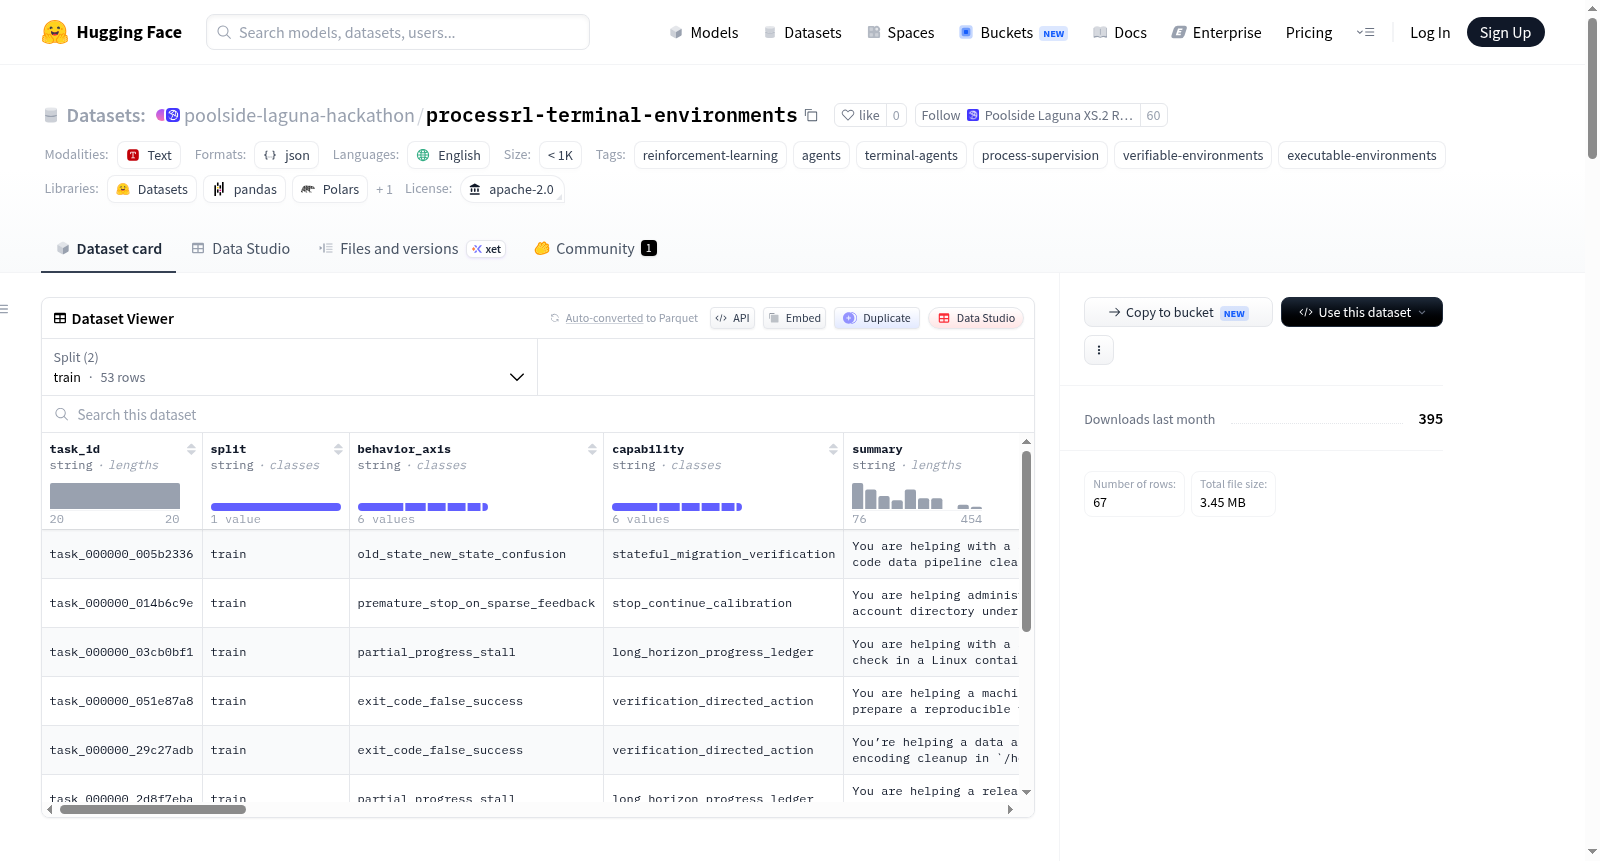
该数据集的核心特色在于其行为条件化的任务设计,聚焦六种过程控制轴:误信退出码假成功、无收敛的漫游循环、死胡同后重复循环、部分进度停滞、新旧状态混淆以及稀疏反馈下的过早停止。这些标签仅描述设计意图,不作为策略目标或训练中的特权提示,确保了研究的纯洁性。数据集包含67个可执行任务包(53个训练、14个留出),每个任务包均附带政策可见的指令、任务元数据、容器构建食谱、最终状态验证器及占位符求解脚本,而非预构建的运行时镜像。其构建过程针对特定重复回滚协议进行了校准,不同智能体、动作预算或验证器封装可能改变任务的表观难度,这赋予了数据集高度的可控性与可复现性。此外,训练集与留出集在行为轴上分层且互斥,为模型评估提供了公正的参照。
使用方法
推荐的使用范式是将任务指令作为策略可见的提示输入,而最终状态验证器仅用于奖励计算或评价,避免在智能体行动前泄露。典型的训练循环应首先依据environment/Dockerfile构建任务环境,随后在终端工作区中运行智能体,并通过调用tests/test.sh启动验证器,从验证器成功与否或检查点结构中推导奖励。整个过程中需严格分离训练集与留出集,尤其在后者用于报告模型进展时不得用于训练。值得注意的是,此数据集并非通用的终端智能体基准测试,而是专注于过程控制行为的可执行训练语料库。使用者若改变回滚接口或训练目标,建议重新校准以适配新的难度层次。环境中的文件、凭据、服务及路径均为虚构,仅用于定义局部终端任务,不反映现实世界的安全性或真实性。
背景与挑战
背景概述
ProcessRL Terminal Environments数据集由Jarrod Barnes于2026年创建,聚焦于强化学习领域中终端代理的过程控制能力。传统终端代理研究多关注最终任务正确性,而忽略了交互过程中的行为质量,例如在获得误导性成功信号后停止、重复无效操作或在状态迁移后失去追踪等问题。该数据集通过行为条件约束,设计了53个训练任务与14个保留任务,覆盖六种过程控制失败模式,为训练代理在复杂终端环境中的元控制能力提供了标准化评估平台。其发布填补了终端代理研究中过程监督与可验证环境构建的空白,对提升代理在交互式任务中的鲁棒性具有重要推动意义。
当前挑战
该数据集所解决的领域问题核心在于终端代理的元控制挑战,即代理容易陷入局部最优或错误反馈循环,无法根据中间结果动态调整策略,例如在死胡同后重复相同操作或过早停止于稀疏奖励场景。构建过程中面临的多重挑战包括:如何将终端代理的往复行为有效转化为可执行的生成约束;如何设计环境生成管道以产出能通过可执行性验证的任务;以及如何校准任务难度以避免基线策略全胜或全败,从而确保强化学习信号的有效性。此外,合成环境的真实性验证与任务难度的跨主体一致性也构成了显著挑战。
常用场景
经典使用场景
在智能体行为控制研究的前沿领域,ProcessRL Terminal Environments 数据集为训练和评估终端智能体的过程控制能力提供了独特的可执行环境集合。其经典使用场景聚焦于强化学习框架下的元控制行为训练,研究者可利用数据集中的任务指令作为策略可见的提示,通过构建Docker容器环境、运行智能体在终端工作区内交互、调用最终状态验证器获取奖励信号这一完整闭环,系统性地训练智能体掌握复杂的终端操作行为。数据集精心划分的训练集(53个任务)与留出集(14个任务)设计,使得研究者能够在保持评估公正性的前提下,开展策略优化与泛化能力验证,特别适合作为过程监督强化学习的标准化训练平台。
解决学术问题
该数据集精准回应当前智能体研究中的核心痛点——如何量化与训练终端操作中的过程控制能力,而非仅关注最终结果正确性。它系统性地解决了六个关键的学术研究问题:欺骗性成功退出码的识别、无界探索中的收敛保证、死胡同后的行动策略切换、部分进度停滞的完整性检测、迁移状态混淆处理以及稀疏反馈下的提前停止抑制。通过将这些元控制失败模式转化为可执行的环境约束,数据集为过程监督学习提供了结构化的基准,从根本上推动了智能体从结果导向向过程感知的范式跃迁,其意义在于构建了可复现、可校准、可验证的实验框架,为终端智能体的鲁棒性和可靠性研究奠定了方法论基础。
衍生相关工作
该数据集的发布催生了多个重要的学术衍生工作方向。其一,基于其过程控制失败分类学,研究者提出了元控制增强型策略网络,通过引入行为轴标签作为辅助监督信号,显著提升了智能体在未见环境中的泛化表现。其二,受数据集校准机制的启发,诞生了基于基线成功率自适应排序的环境生成算法,实现了训练难度的动态调控。其三,数据集中包含的最终状态验证器设计模式被扩展为通用的过程监督脚手架,应用于代码生成和数据库管理等相邻领域。此外,其可执行环境的容器化构建方案为后续的嵌入式测评基准提供了技术蓝本,推动了可复现智能体评估标准的建立,相关研究已在多个顶级强化学习会议上发表
以上内容由遇见数据集搜集并总结生成


