
遇见数据集

The-CoLab/multilingual-textarena-TicTacToe-v0-train

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

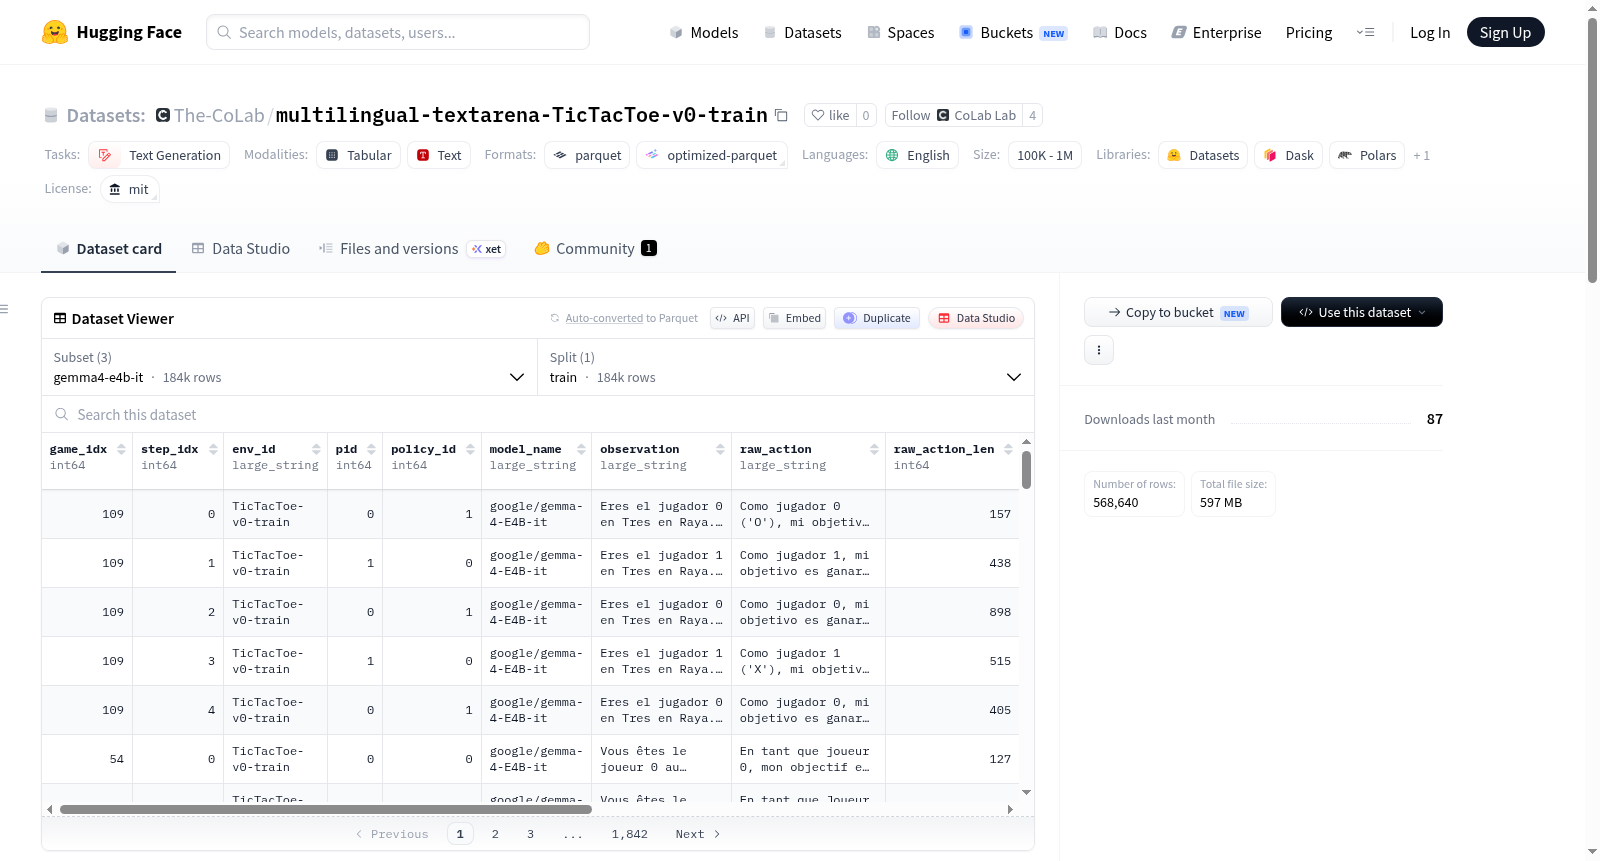
该数据集包含语言条件化的TextArena轨迹数据,用于文本生成任务。每个数据集配置对应不同的模型、实验组或源文件夹,可用配置包括gemma4-e4b-it、qwen3-4b和ministral3-3b-instruct。数据以parquet文件格式存储,包含训练分割,记录行级轨迹信息。常见列包括游戏索引、步骤索引、环境ID、玩家ID、策略ID、模型名称、观察值、原始动作、动作长度、动作、奖励、策略周期、步骤信息、游戏信息、语言代码和语言映射等,部分列可能因原始文件而异。嵌套字段如步骤信息、游戏信息和语言映射以字符串形式存储以确保兼容性。

This dataset contains language-conditioned TextArena trajectory data. Each dataset configuration corresponds to a different model, experiment group, or source folder. Available configurations include gemma4-e4b-it, qwen3-4b, and ministral3-3b-instruct. The data is stored in parquet files with a train split, containing row-level trajectory records. Common columns may include game_idx, step_idx, env_id, pid, policy_id, model_name, observation, raw_action, raw_action_len, action, reward, policy_epoch, step_info, game_info, lang, and lang_map, with some columns varying depending on the original files. Nested fields such as step_info, game_info, and lang_map are stored as strings for compatibility.
提供机构:
The-CoLab
搜集汇总
数据集介绍
The-CoLab/multilingual-textarena-TicTacToe-v0-train 数据集图片
构建方式
multilingual-textarena-TicTacToe-v0-train数据集是基于TextArena语言条件化轨迹数据构建而成,涵盖了多种语言场景下的井字棋游戏交互记录。该数据集的构建过程通过采集不同策略模型在环境中生成的完整游戏轨迹实现,每个配置对应一种特定的模型或实验组,包括gemma4-e4b-it、qwen3-4b和ministral3-3b-instruct等。数据以Parquet格式存储,并按照模型来源划分至独立的子目录中,便于研究者根据需求加载特定模型的训练数据。行级轨迹记录涵盖了游戏状态、动作、奖励及策略信息等关键字段,为多语言文本条件下的强化学习研究提供了结构化、可复现的训练样本。
特点
该数据集的核心特点在于其多语言与多模型兼容性,能够支持跨语言、跨策略的井字棋游戏轨迹分析。每条记录均包含游戏索引、步骤索引、环境标识、策略标识及模型名称等元数据,同时保留了观察、原始动作、动作长度、动作、奖励等序列化信息,完整还原了游戏交互过程。此外,数据集中还存储了步骤信息、游戏信息及语言映射等嵌套字段,这些字段以字符串形式保存以确保兼容性。这种设计既保留了原始数据的丰富语义,又便于在不同加载环境中进行解析与处理,为文本生成任务中的策略学习与评估提供了高质量的训练资源。
使用方法
研究者可通过安装datasets库并加载指定配置来使用该数据集,例如选择gemma4-e4b-it配置进行训练。加载后,训练集以行级轨迹记录形式呈现,每条记录代表游戏中的一个交互步骤。数据集中提供了丰富的字段,如game_idx用于定位游戏实例,step_idx标记步骤顺序,observation与action分别描述状态与动作内容,reward记录即时奖励。研究人员可基于这些字段构建序列化输入,用于微调语言模型或训练策略网络。需要注意,部分嵌套字段如step_info以字符串形式存储,使用前需进行解析。该数据集适用于多语言环境下的文本生成与强化学习结合的研究场景。
背景与挑战
背景概述
在大型语言模型(LLM)与多代理交互系统交叉融合的前沿领域,如何有效捕获并利用多语言环境下的智能体决策轨迹,已成为推动模型对齐与泛化能力提升的关键瓶颈。由Colab研究团队于近期构建并发布的multilingual-textarena-TicTacToe-v0-train数据集,正是为应对这一挑战而生的高价值资源。该数据集聚焦于经典博弈环境——井字棋(Tic-Tac-Toe),旨在提供多语言、多模型(Gemma4、Qwen3、Ministral3等)生成的文本轨迹数据,以支持对语言模型在结构化交互任务中的推理、策略与多语言一致性进行深入研究。作为TextArena语言轨迹系列的一部分,该数据集不仅为理解模型在多语种环境中的行为差异提供了标准化基准,更有望推动跨语言强化学习与对话式Agent训练范式的进一步发展。
当前挑战
当前该数据集面临的核心挑战主要包括三方面:其一,在领域问题层面,现有语言模型在多语言、多轮交互场景中常表现出策略偏移与语言模态间的非一致性,如何基于本数据集系统评估并改善模型在非英语环境下的博弈推理与决策鲁棒性,是亟待突破的难点。其二,在数据集构建过程中,多模型轨迹的采集面临稀疏奖励信号与长尾游戏状态覆盖问题——部分语言版本下有效博弈轨迹数量极为有限,导致模型训练时面临严重的数据不平衡与泛化困境。其三,由于不同模型架构(如指令微调与非指令模型)的输出空间存在本质差异,如何保证跨配置数据的语义对齐与动作标签的可比较性,也是需要精细设计与实验验证的关键工程挑战。
常用场景
经典使用场景
在自然语言处理与强化学习交叉的前沿领域,该数据集为多语言环境下文本博弈智能体的训练与评估提供了宝贵的资源。经典使用场景聚焦于利用基于语言指令的井字棋(TicTacToe)交互轨迹,训练大型语言模型构建具备多语言对话与决策能力的智能体。研究者可通过加载不同模型(如Gemma、Qwen、Ministral)生成的轨迹数据,开展迁移学习、少样本学习或离线强化学习实验,从而验证模型在多语言文本博弈中的泛化表现与策略有效性。
实际应用
在实际应用层面,该数据集可有效支撑多语言智能客服系统中博弈式交互模块的开发。例如,在跨国在线游戏或教育平台中,智能体需实时理解并响应不同语言玩家的指令,完成类似井字棋的回合制策略交流。基于该数据集训练的模型能学习到跨语言的行为模式,从而在用户引导、矛盾化解或游戏助手等场景中展现出更自然的语言理解与策略生成能力,显著提升多语言环境下人机协同的流畅性与智能化水平。
衍生相关工作
依托该数据集,学术界已衍生出若干富有启发性的典型工作。研究者基于其多模型配置设计了针对语言模型博弈能力的对比分析框架,探索不同参数规模与架构的模型在文本TicTacToe任务中的策略偏好与漏洞。此外,部分工作借鉴该数据集的多语言轨迹结构,构建了跨语言策略迁移的基线方法,检验了从英语数据中学习的博弈策略在法语、西班牙语等场景下的迁移效率。这些衍生效仿不仅深化了对语言模型决策可迁移性的理解,亦催生了面向文本博弈鲁棒性测试的新基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

