
遇见数据集

The-CoLab/multilingual-textarena-Nim-v0-train

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

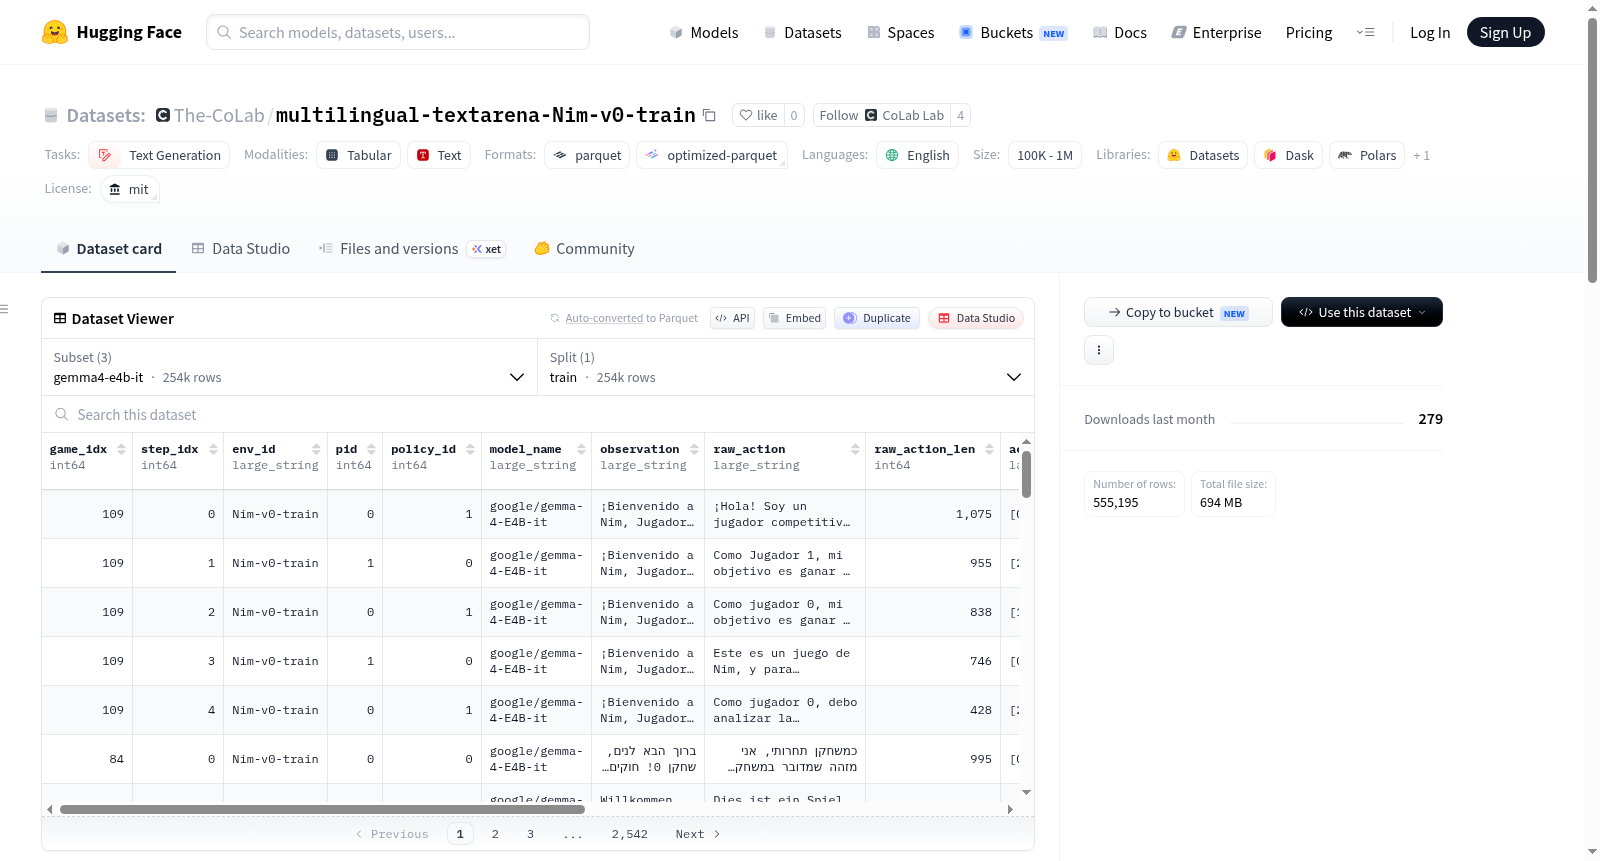
该数据集包含语言条件化的TextArena轨迹数据,用于文本生成任务。每个数据集配置对应不同的模型、实验组或源文件夹,具体包括gemma4-e4b-it、qwen3-4b和ministral3-3b-instruct配置。数据以parquet文件格式存储,涵盖训练分割,包含行级轨迹记录,常见列有game_idx、step_idx、env_id、pid、policy_id、model_name、observation、raw_action、raw_action_len、action、reward、policy_epoch、step_info、game_info、lang和lang_map等,部分列可能因原始文件而异。嵌套字段如step_info、game_info和lang_map以字符串形式存储以确保兼容性。数据集基于MIT许可证,语言为英语。

This dataset contains language-conditioned TextArena trajectory data for text generation tasks. Each dataset configuration corresponds to a specific model, experimental group, or source folder, with the included configurations being gemma4-e4b-it, qwen3-4b, and ministral3-3b-instruct. The data is stored in Parquet file format, covering the training split, and contains row-level trajectory records. Common columns include game_idx, step_idx, env_id, pid, policy_id, model_name, observation, raw_action, raw_action_len, action, reward, policy_epoch, step_info, game_info, lang, and lang_map, while some columns may vary across the original files. Nested fields such as step_info, game_info, and lang_map are stored as strings to ensure compatibility. This dataset is licensed under the MIT License, with English as its primary language.
提供机构:
The-CoLab
搜集汇总
数据集介绍
The-CoLab/multilingual-textarena-Nim-v0-train 数据集图片
构建方式
该数据集源自多语言文本竞技场(TextArena)环境,旨在捕捉不同语言指令下智能体交互的轨迹数据。构建过程中,研究者采用多种大型语言模型作为策略主体,包括gemma4-e4b-it、qwen3-4b以及ministral3-3b-instruct,在Nim博弈任务中收集其决策序列。每一轨迹记录均以行级形式存储于Parquet文件中,并依据模型来源划分为独立配置,确保数据组织清晰且易于检索。
特点
数据集呈现鲜明的多维度特性。首先,其覆盖英语在内的多种语言,通过'lang'与'lang_map'字段索引语言标签,满足跨语言研究需求。其次,每条轨迹包含完整的博弈步骤信息,如环境状态(observation)、原始动作及执行动作(raw_action、action)、即时奖励(reward)等核心字段,为强化学习与模仿学习提供细粒度参考。此外,复杂嵌套字段(如step_info与game_info)以字符串形式存储,保证了数据兼容性与后续解析的灵活性。
使用方法
数据集通过HuggingFace的datasets库便捷加载,用户可按需指定具体配置名(如'gemma4-e4b-it')获取对应的轨迹数据,拆分均设定为训练集。加载后,数据以行级记录呈现,适合进行策略分析、行为克隆或价值函数学习等任务。由于部分字段以字符串格式存储嵌套内容,推荐使用JSON或字典解析器进行反序列化处理,以充分利用其丰富的信息结构。
背景与挑战
背景概述
多智能体交互与语言模型的结合正成为人工智能研究的前沿方向,其中文本环境下的博弈与决策任务为评估智能体的语言理解与策略能力提供了理想平台。在此背景下,The-CoLab团队于近期发布了multilingual-textarena-Nim-v0-train数据集,该数据集聚焦于多语言文本竞技场中的策略轨迹记录,涵盖了Gemma、Qwen、Ministral等多种先进语言模型在不同配置下的交互数据。该数据集的核心研究问题在于如何利用语言模型在复杂博弈环境中生成与理解多语言指令,从而推动多智能体系统的协作与竞争能力研究。其发布为跨语言强化学习与多模态智能体训练提供了宝贵的资源,对自然语言处理与强化学习的交叉领域具有重要的推动作用。
当前挑战
当前数据集面临的核心挑战首先在于解决多语言环境下智能体策略生成的一致性与鲁棒性难题,即不同语言表述可能显著影响模型对博弈规则的理解与决策质量,而现有模型在低资源语言上的表现往往不稳定。其次,数据集构建过程中需克服高维轨迹数据的标准化存储问题,尤其是嵌套字段(如step_info、game_info)以字符串形式存储后,解析与复用难度增加。此外,多模型、多语言配置的实验复现与不同模型间策略对比的系统化框架尚不完善,数据规模与场景多样性之间的平衡也是实际使用中需持续优化的技术挑战。
常用场景
经典使用场景
在自然语言处理与多智能体交互研究的交汇点上,多语言文本竞技场轨迹数据集(multilingual-textarena-Nim-v0-train)为研究者提供了一扇窥探语言驱动决策过程的窗户。该数据集最经典的使用场景在于训练和评估基于文本的强化学习模型,尤其是在多语言环境下,智能体如何通过自然语言指令进行策略选择与博弈对抗。通过记录Gemma、Qwen、Ministral等不同大语言模型在Nim博弈中的完整对话与动作轨迹,研究者能够模拟真实世界中人机或机机交互的复杂动态,从而测试模型在有限步骤内理解环境、生成合理动作并获取奖励的能力。这一场景不仅覆盖了单一语言的博弈学习,更延伸至跨语言迁移学习,为构建通用语言智能体提供了宝贵的训练燃料。
解决学术问题
长期以来,学术界在多智能体语言互动中面临两大瓶颈:一是缺乏大规模、多语言的环境交互数据以支持模型从试错中学习;二是难以在可控的博弈任务中分离语言理解与策略优化的贡献。该数据集的引入有效弥合了这一研究裂缝。通过提供Gemma-4B、Qwen-3B、Ministral-3B等主流模型在高维度Nim博弈中的细粒度轨迹——包括观测、动作、奖励及多语言标签——研究者得以深入剖析语言模型在零样本或少样本条件下的策略泛化能力、语言偏差对决策的影响,以及多语言训练数据是否增强模型对文化焦点的感知。这一资源推动了语言条件强化学习理论的实证研究,使得探索元学习、逆强化学习和语言对齐等前沿议题成为可能。
衍生相关工作
围绕该数据集的构建与发布,一批开创性研究工作已如雨后春笋般涌现。一方面,研究者利用多语言文本竞技场轨迹作为微调基础,催生了文本RLHF(基于强化学习的人类反馈)方法在跨语言环境下的变体,例如通过对比不同语言下的奖励分布来改进模型的价值函数估计,相关工作发表在ACL和NeurIPS等顶级会议中。另一方面,该数据集启发了对语言模型内部表示的可解释性探索——学者们通过轨迹中抽象的动作编码与语言映射,揭示模型是如何在潜在空间中构建博弈树与对手模型的。更值得一提的是,部分工作开始将此类多语言博弈数据与元学习范式结合,提出了情景记忆增强的智能体架构,显著提升了在新游戏任务上的零样本成功率,而这些成果又反哺了数据集下一版本的扩展设计。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

