Nemotron-CC-Math-4plus_translated
收藏资源简介:
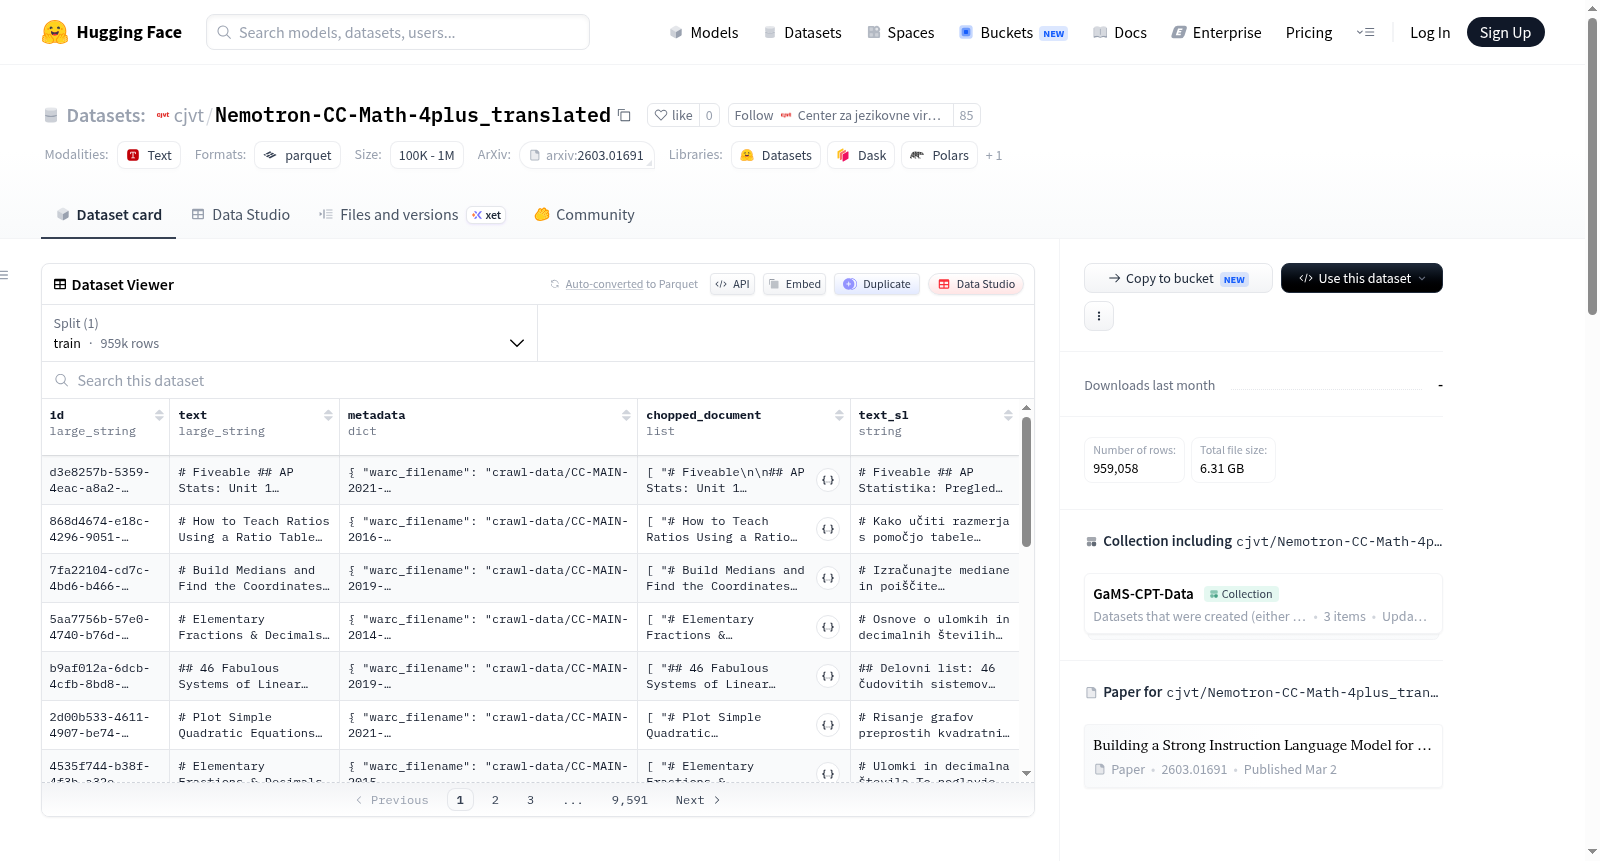
Nemotron CC-Math 4plus翻译数据集是一个斯洛文尼亚语翻译版本,源数据来自NVIDIA的Nemotron-CC-Math-v1数据集的4plus子集,并经过子采样处理。该数据集通过GaMS-DPO-Translator模型进行自动翻译,旨在支持斯洛文尼亚语的自然语言处理研究,特别是为低资源语言构建指令语言模型。数据集包含约96万个文档,翻译后文本总计约8.74亿斯洛文尼亚语单词。每个样本包含以下字段:id(原始数据标识符)、text(原始英文文本)、metadata(原始元数据,包括WARC文件名、ID、Finemath和Nemocurator的整数与分数评分、类别和使用的模型)、chopped_document(为适应翻译模型上下文窗口而切分的文本单元列表)以及text_sl(斯洛文尼亚语翻译文本)。该数据集适用于机器翻译质量评估、跨语言文本生成、数学内容的多语言处理以及低资源语言模型训练等任务。开发工作属于PoVeJMo研究计划(自适应自然语言处理与大语言模型)下的SloLLaMai项目,资金来源于斯洛文尼亚研究与创新机构、NextGenerationEU和欧盟Horizon Europe计划。数据集采用CC BY 4.0许可证发布。
The Nemotron CC-Math 4plus translation dataset is a Slovenian translation version, sourced from the 4plus subset of NVIDIAs Nemotron-CC-Math-v1 dataset, specifically a subsample. This dataset is automatically translated using the GaMS-DPO-Translator model, aiming to support Slovenian natural language processing research, particularly for building instruction language models for low-resource languages. It contains approximately 960,000 documents, with translated text totaling about 874 million Slovenian words. Each sample includes the following fields: id (original data identifier), text (original English text), metadata (original metadata, including WARC file name, ID, integer and fractional scores from Finemath and Nemocurator, categories, and models used), chopped_document (a list of text units segmented to fit the translation models context window), and text_sl (Slovenian translated text). The dataset is suitable for tasks such as machine translation quality evaluation, cross-lingual text generation, multilingual processing of mathematical content, and training low-resource language models. The development work falls under the SloLLaMai project within the PoVeJMo research initiative (Adaptive Natural Language Processing and Large Language Models), funded by the Slovenian Research and Innovation Agency, NextGenerationEU, and the EU Horizon Europe program. The dataset is released under the CC BY 4.0 license.
数据集概述:Nemotron CC-Math 4plus translation
该数据集是 Nemotron CC Math 数据集的斯洛文尼亚语翻译版本。原始数据集取自 nvidia/Nemotron-CC-Math-v1 的 4plus 子集,并使用 cjvt/GaMS-DPO-Translator 模型完成翻译。
数据规模
- 文档数量:约 96万 份
- 翻译后文本:包含约 8.74亿 个斯洛文尼亚语单词
数据规模详情
- 训练集(train):
- 文件大小:12,595,324,755 字节
- 样本数量:959,058 条
- 下载大小:6,306,067,561 字节
数据结构
每条数据包含以下字段:
id:源数据集中的原始标识符text:原始英文文本metadata:源数据集的元数据(包括 WARC 文件名、ID、数学分数、类别、所用模型等)chopped_document:为适配翻译模型上下文窗口而切分的文本单元列表text_sl:英文文本对应的斯洛文尼亚语翻译
许可协议
该数据集采用 CC BY 4.0 许可协议发布。