遇见数据集

fineproofs-prm-context-v2-cot-pbudget

收藏
Hugging Face2026-08-03 更新2026-08-04 收录
官方服务:

资源简介:

FineProofs PRM Context v2: Cot Pbudget 是一个用于过程奖励模型(Process Reward Model)和定理证明(Theorem Proving)任务的数据集。该数据集是 FineProofs rollout collection 的九个行匹配上下文变体之一,使用 'cot_pbudget' 上下文,从 'same_problem' 的 rollout 中生成,并采用 'middle_truncated_reasoning_equal_share' 打包策略。所有变体共享相同的行键、标签、奖励、训练/验证问题划分和硬端点覆盖。数据集的训练集包含 53,457 行(对应 2,542 个问题),验证集包含 2,602 行(对应 128 个问题)。目标使用基于 clamped points 除以 max points 得到的规范化 rubric 得分;'correct' 列是 legacy 布尔投影(当 reward >= 0.5 时为 True),而训练时使用密集的 'reward' 目标。该数据集适用于过程奖励模型的训练与评估,以及定理证明中的推理步骤质量评估。

FineProofs PRM Context v2: Cot Pbudget is a dataset designed for Process Reward Model and Theorem Proving tasks. It is one of nine row-matched context variants of the FineProofs rollout collection, using the cot_pbudget context, generated from same_problem rollouts, with a middle_truncated_reasoning_equal_share packing strategy. All variants share the same row keys, labels, rewards, train/validation problem splits, and hard endpoint coverage. The training set contains 53,457 rows (corresponding to 2,542 problems), and the validation set contains 2,602 rows (corresponding to 128 problems). The target is a normalized rubric score based on clamped points divided by max points; the correct column is a legacy boolean projection (True when reward >= 0.5), while the dense reward target is used during training. The dataset is suitable for training and evaluating process reward models and assessing reasoning step quality in theorem proving.

创建时间:
2026-08-02
原始信息汇总

数据集概述:FineProofs PRM Context v2 - Cot Pbudget

该数据集是 FineProofs 项目下的一个过程奖励模型(Process Reward Model, PRM)训练数据集变体,属于文本分类任务范畴,主要用于定理证明场景中的过程奖励建模。

核心特征

  • 上下文类型:采用 cot_pbudget(思维链 + 预算)上下文模式,来源于 same_problem 的 rollout 采集,打包策略为 middle_truncated_reasoning_equal_share
  • 目标设计:部分前缀和完整响应的目标均使用规范化标准评分(标准化评分 = 截断点得分 / 最高分)。其中 correct 列仅为旧版布尔投影(reward >= 0.5),训练时使用密集的 reward 目标。
  • 变体关系:该数据集是九个行匹配的上下文变体之一,各变体具有相同的行键、标签、奖励、训练/验证问题划分和硬端点覆盖。

采集契约

属性
运行 ID fineproofs_all_qwen35_9b_direct2phase_m32_20260730
采集模型 Qwen/Qwen3.5-9B
模型修订版本 c202236235762e1c871ad0ccb60c8ee5ba337b9a
上下文臂/模式 cot_pbudget
上下文范围 same_problem
上下文正确性标签 no
验证 SHA-256 c5a3b92bd6196d4a33cded2c1a01870d1963d323351d573b369b7f97f3b7f648

数据划分

划分 行数 问题数
训练集(train) 53,457 2,542
验证集(validation) 2,602 128
  • 本地文件 val.parquet 发布为 validation.parquet
  • 数据集中包含 dataset_provenance.json(实时输入来源)、verification.json(跨臂检查)和 _SUCCESS.json(已发布文件的精确指纹),用于完整性验证。
  • 留出(held-out)的问题在划分和上下文选择之前已被移除。
搜集汇总
数据集介绍
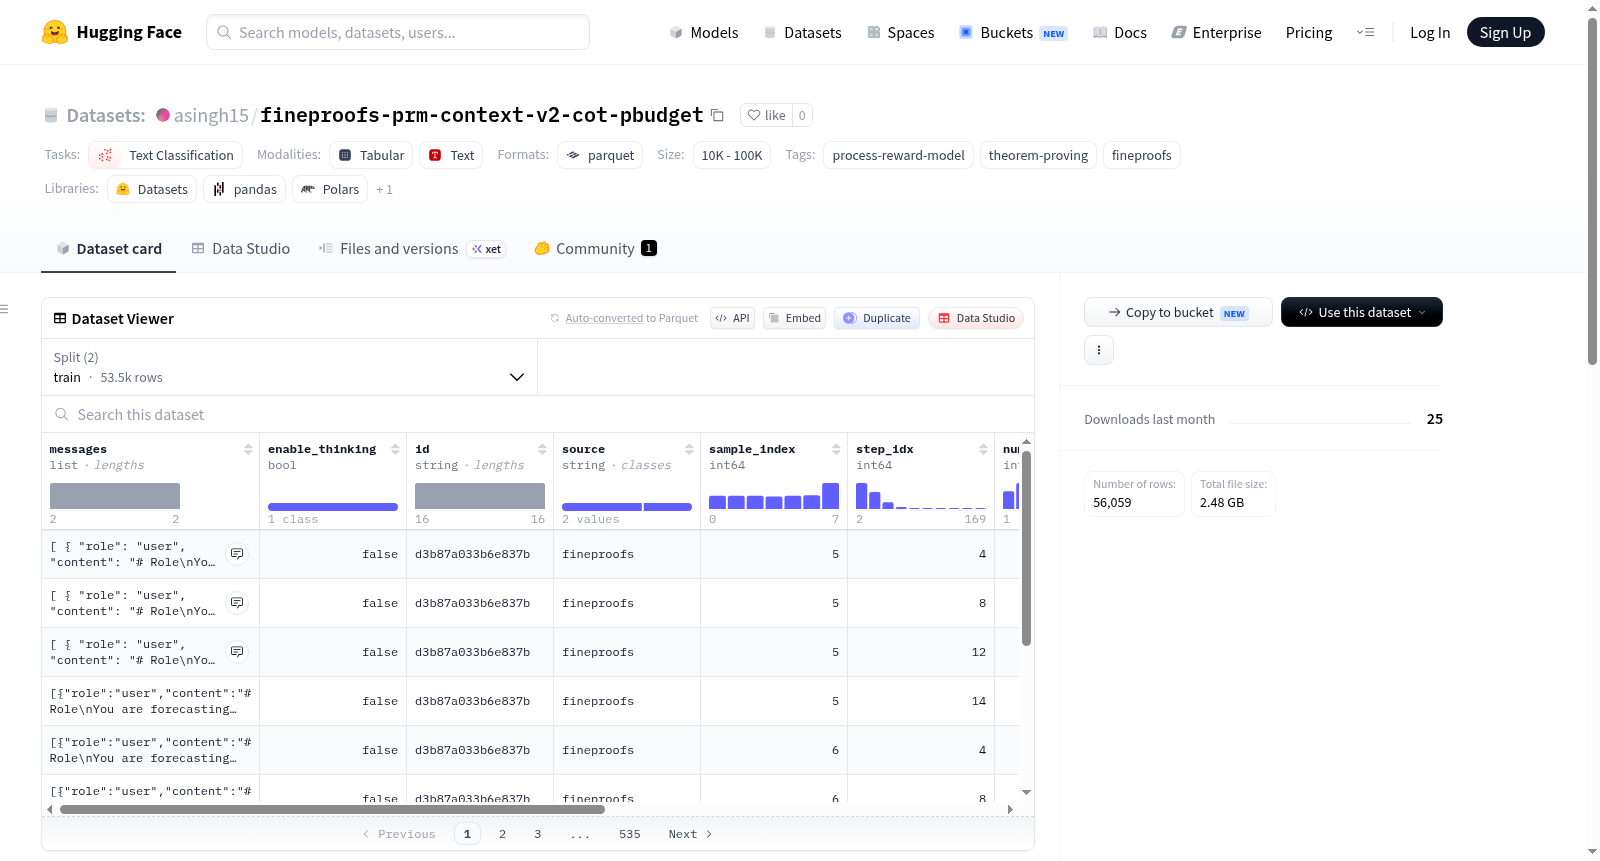
fineproofs-prm-context-v2-cot-pbudget 数据集图片
构建方式
FineProofs PRM Context v2: Cot Pbudget 数据集源于对定理证明过程奖励模型的研究,是在已验证的 FineProofs 展开集合基础上构建的九种行匹配上下文变体之一。其以 Qwen/Qwen3.5-9B 模型在同题滚动(same_problem rollouts)中生成的 'cot_pbudget' 上下文为特征,并采用 'middle_truncated_reasoning_equal_share' 打包策略。数据集的构建遵循严格的合同规范,包括运行 ID、模型版本及验证校验和,确保了来源的可追溯性。在数据划分上,先剔除预留问题,再进行训练与验证集的切分,训练集含53,457行对应2,542个问题,验证集含2,602行对应128个问题。所有部分前缀和完整响应目标均采用基于裁剪分数与最大分数之比的规范化规则化信贷,为奖励建模提供稠密监督信号。
特点
该数据集的核心特色在于其行匹配的上下文变体设计,九个变体共享相同的行键、标签、奖励及问题划分,从而支持跨变体的对照实验。上下文模式 'cot_pbudget' 强调在预算约束下的思维链推理,且上下文范围内不包含正确性标签,促使模型依赖过程信号。数据集中 'correct' 列仅为基于奖励阈值的传统布尔投影,而训练实际采用稠密 'reward' 目标,捕捉细粒度的过程质量差异。此外,数据集的发布包含完整的 provenance 与验证元数据,如 dataset_provenance.json 和 verification.json,确保数据完整性与可复现性,符合科学研究对数据透明性的严苛要求。
使用方法
该数据集主要面向过程奖励模型(PRM)的训练与评估,适用于文本分类任务。用户可直接加载 train.parquet 和 validation.parquet 文件,利用 'reward' 列作为回归目标进行模型优化,而非依赖二元的 'correct' 列。由于训练与验证集的问题已严格划分,评估时可确保模型在未见问题上的泛化能力。研究者可针对九种上下文变体进行消融研究,探究不同上下文策略对奖励模型性能的影响。数据集的官方文档提供了详细的合同信息,便于复现实验设置。建议使用过程中结合定理证明领域的知识,对样本的推理步骤进行深入分析,以提升模型的解释性和稳健性。
背景与挑战
背景概述
FineProofs PRM Context v2: Cot Pbudget 数据集诞生于2026年,由研究团队基于 Qwen3.5-9B 模型构建,旨在推进数学定理证明领域的过程奖励模型(PRM)研究。该数据集从已验证的 FineProofs 回放集合中提取,采用 'cot_pbudget' 上下文模式,专注于同一问题的推理过程评估。其核心研究问题在于如何利用过程奖励信号,精确评估逐步推理的质量,以提升自动定理证明的可靠性和效率。该数据集的发布为过程奖励模型提供了大规模、细粒度的训练资源,对自动推理和机器学习交叉领域具有重要影响力,推动了从结果导向到过程导向的评估范式转变。
当前挑战
该数据集面临的挑战多维且深刻。在领域层面,自动定理证明的核心难题在于评估推理过程的正确性,这要求模型不仅识别最终答案,还需理解每一步的逻辑推导,传统的结果监督难以胜任。构建过程中,团队需确保数据的一致性与公平性,体现在九个上下文变体需保持行键、标签和奖励的同源性,并严格移除留出问题以避免数据泄漏。此外,奖励归一化采用钳制分数除以最大值的标准,但如何平衡不同问题难度下的奖励分布,以及如何在部分前缀与完整响应间保持目标一致性,仍是关键挑战。这些问题的解决对于提升过程奖励模型的泛化能力和实用性至关重要。
常用场景
经典使用场景
FineProofs PRM Context v2 - Cot Pbudget 数据集是面向过程奖励模型(Process Reward Model, PRM)训练与评估的高质量语料资源,其核心设计在于利用思维链(Chain-of-Thought)预算上下文(cot_pbudget)对数学定理证明过程进行细粒度标注。该数据集经典使用场景聚焦于训练能够逐步评估推理过程正确性的过程奖励模型,通过提供部分前缀与完整回答的密集奖励信号,使模型学会判别证明步骤的逻辑有效性与贡献度。研究者可基于其统一的问题划分与行对齐结构,开展跨上下文变体的对比实验,从而深入剖析不同上下文策略对PRM性能的影响。
衍生相关工作
围绕FineProofs PRM Context v2 - Cot Pbudget,衍生了一系列关于过程奖励模型与上下文策略优化的前沿工作。研究者借鉴其多臂数据构造范式,探索了不同的上下文打包策略(如middle_truncated_reasoning_equal_share)对模型性能的影响,并开发了针对PRM的专门训练算法、奖励校准技术及鲁棒性评估方法。该数据集亦成为验证过程监督在数学推理中有效性的重要基准,带动了从结果奖励到过程奖励的范式转变,催生了多项关于证明步骤重要性加权、推理路径多样性以及模型自我反思机制的研究成果。
数据集最近研究
最新研究方向
该数据集聚焦于形式化定理证明中过程奖励模型(PRM)的细粒度监督信号构建,通过同问题采样与上下文打包策略(cot_pbudget)生成部分前缀与完整响应的密集奖励目标,旨在利用归一化rubric信用分数突破传统二元正确性标注的局限。最新研究趋势围绕多臂上下文变体对比、密集奖励分布学习以及推理链截断策略对模型泛化能力的影响展开,其中Qwen3.5-9B作为采集模型推动了过程级验证的规模化应用,为自动数学推理的可靠性与可解释性评估提供了新范式。该数据集的发布对提升大模型在定理证明中的步骤级错误定位与反馈机制研究具有重要推动作用,助力构建更稳健的智能推理系统。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务