
遇见数据集

rag-plurality-dataset

收藏
Hugging Face2026-09-07 更新2026-09-08 收录
官方服务:

资源简介:

该数据集包含多个事实核查或论证相关的子集,包括 perspectrum、health_contradict 和 perspectra。每个样本由主文本(text)、两个证据段落(evidence_A 和 evidence_B,每个证据包含元数据和文本内容)以及一个黄金标签(gold_label)组成。标签可能表示证据之间或证据与主文本之间的支持、矛盾或中立关系。数据集适用于论证挖掘、矛盾检测、观点比较等自然语言理解任务。

This dataset contains multiple subsets related to fact-checking or argumentation, including perspectrum, health_contradict, and perspectra. Each sample consists of a main text (text), two evidence passages (evidence_A and evidence_B, each containing metadata and textual content), and a gold label (gold_label). The label may indicate a support, contradiction, or neutral relationship between the evidence passages or between the evidence and the main text. The dataset is suitable for natural language understanding tasks such as argument mining, contradiction detection, and opinion comparison.

创建时间:
2026-09-02
原始信息汇总

数据集详情总结:rag-plurality-dataset

数据集概述

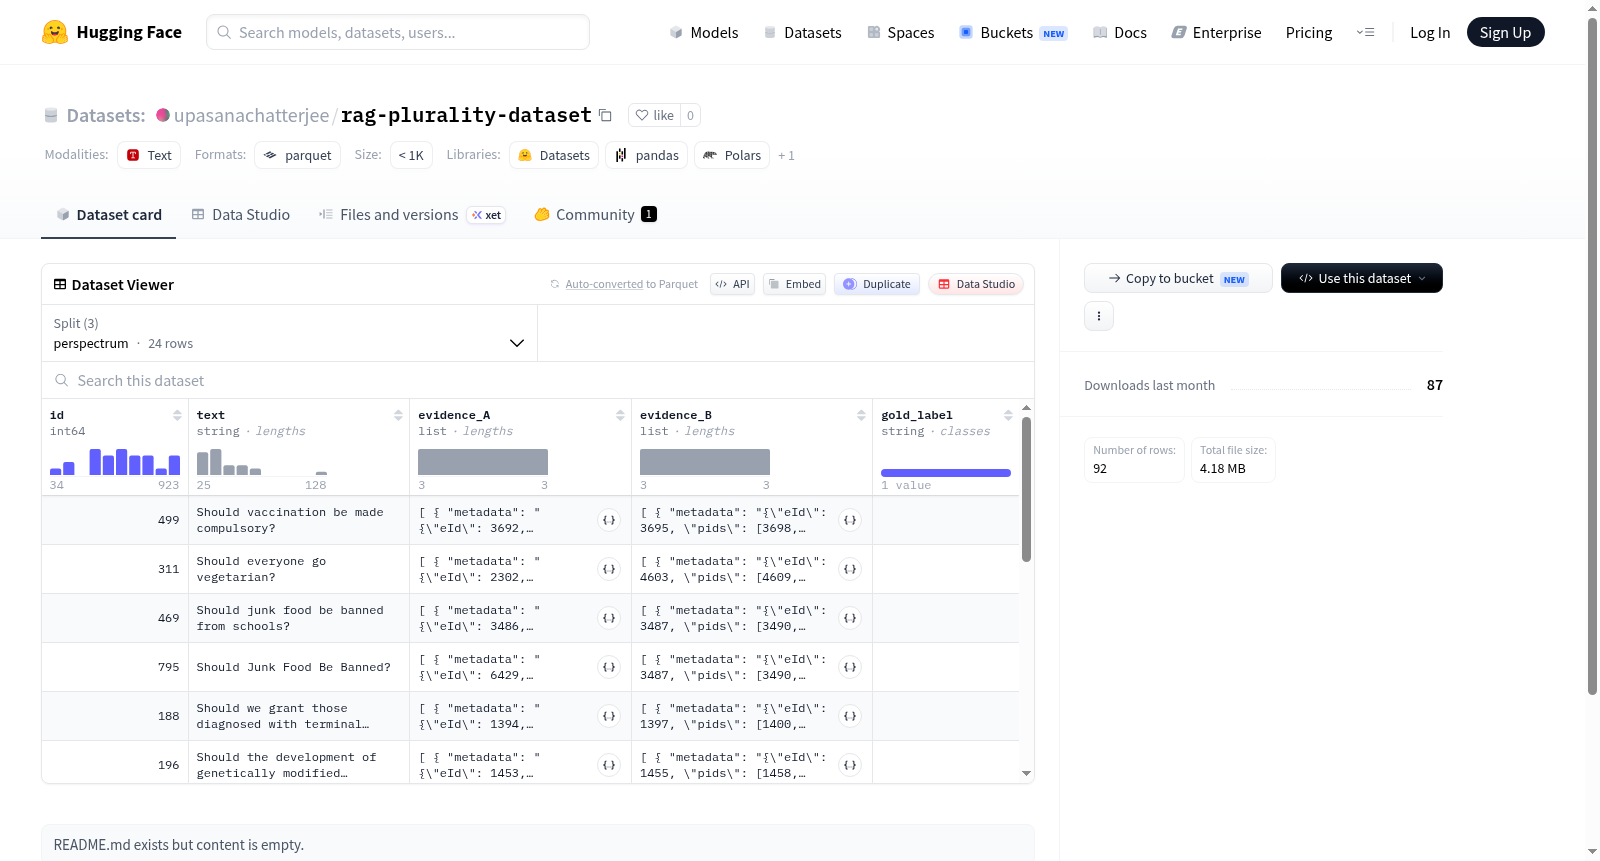
该数据集名为 rag-plurality-dataset,由用户 upasanachatterjee 在 Hugging Face 上发布。数据集主要面向检索增强生成(RAG)场景中的多元性研究,提供了包含多视角证据的文本对样本,用于支持相关模型的训练或评估。

数据集特征

数据集包含以下字段:

  • id:整数类型,样本的唯一标识符。
  • text:字符串类型,主要的文本内容。
  • evidence_A:包含 metadata(字符串)和 text(字符串)两个子字段,用于存储第一组佐证信息及其元数据。
  • evidence_B:结构与 evidence_A 相同,用于存储第二组佐证信息及其元数据。
  • gold_label:字符串类型,黄金标准标签,标记样本的类别或对立性质。

数据集划分

数据集分为三个子集,每个子集对应不同的来源或主题:

子集名称 样本数量 大小(字节)
perspectrum 24 284,889
health_contradict 55 7,290,419
perspectra 13 165,777

数据集规模

  • 下载总大小:24,825,301 字节
  • 数据集总大小:7,741,085 字节
  • 样本总数量:92

数据文件

数据文件以通配符方式组织,每个子集对应独立的数据文件路径:

  • data/perspectrum-*
  • data/health_contradict-*
  • data/perspectra-*

其他信息

  • 配置信息:数据集默认配置名为 default
  • 适用场景:适用于需要利用多元证据或多视角文本的 RAG 相关任务,尤其涉及对比或矛盾性观点分析的研究。
搜集汇总
数据集介绍
rag-plurality-dataset 数据集图片
构建方式
该数据集为检索增强生成(RAG)领域中的多元观点对齐研究量身打造,汇聚了perspectrum、health_contradict及perspectra三个子集,涵盖24、55与13个实例。每个实例包含一个核心文本片段及其对应的两条证据(evidence_A与evidence_B),每条证据附有来源于何种语境的metadata说明,并标注了gold_label以指示两条证据与文本间的关系类型。构建过程注重从多样化真实语料中抽取矛盾或对立视角,确保数据覆盖医疗健康、社会观点等多元场景。
特点
此数据集的核心特征在于其多元视角的精细标注与结构化呈现,每一条样本均通过双证据对比设计,凸显证据间及与主文本间的语义张力。gold_label的设定不仅区分事实一致性,亦能捕捉观点分歧,为评估RAG系统的鲁棒性提供了高难度基准。跨三个子集的规模虽小,却精准指向少数样本中的深层语义矛盾,适合深度分析。此外,metadata字段为溯源研究提供了便利。
使用方法
使用该数据集时,解析器可依据configs结构直接加载各split,读取text、evidence_A/B及gold_label字段。适用于训练或评测需处理矛盾证据的RAG模型,譬如指令微调与偏好对齐,通过给定主文本与双证据,令模型判别证据的可信度或生成综合答案。研究者可按子集独立测试,亦可合并后用于跨域泛化验证。需注意数据集规模有限,适合作为补充集而非主训练集。
背景与挑战
背景概述
该数据集名为rag-plurality-dataset,由研究团队于2023年创建,旨在评估检索增强生成(RAG)系统在处理多元证据时的鲁棒性。其核心研究问题聚焦于当给定多个可能相互矛盾的证据时,模型能否正确综合信息并生成一致的回答。该数据集整合了三个源自不同领域的子集:perspectrum、health_contradict和perspectra,分别涵盖了观点多样性、医疗矛盾文本及多视角论述,从而为RAG系统的评估提供了跨领域的基准。其提出的“多元性”评估维度,对推动RAG模型在真实世界信息冲突场景下的研究具有重要影响。
当前挑战
该数据集面临的挑战主要源于领域内证据的复杂性和构建过程的难度。在领域层面,RAG系统需应对证据之间的语义重叠或直接矛盾,这对模型的推理与一致性维护构成巨大挑战;同时,不同子集(如医疗文本的严谨性与观点文本的主观性)要求模型具备领域自适应性。在构建过程中,挑战在于从原始来源中筛选并标注出高质量且具有代表性的多元证据对,需要专家介入以确保标签的准确性,且数据量较小(总计92个示例),限制了模型的泛化能力训练。因此,该数据集不仅考验模型的证据整合能力,也挑战了其在稀缺监督下的学习效率。
常用场景
经典使用场景
rag-plurality-dataset 数据集在检索增强生成(RAG)领域扮演着至关重要的角色,其经典使用场景聚焦于多证据推理与信息整合的评测。该数据集精心构建了包含多源证据对(evidence_A 与 evidence_B)的样本,每个样本附带文本与元数据,并标注金标准标签(gold_label),旨在模拟真实世界中查询需综合多方观点或矛盾信息的情境。研究者常利用此数据集评估和提升 RAG 系统在面临多个可能相互支持或冲突的证据时,如何准确选择、权衡并生成连贯、贴切回答的能力,从而推动更鲁棒的信息检索与生成模型的进步。
解决学术问题
该数据集精准击中了 RAG 研究中的核心痛点——当检索结果呈现多样性或矛盾性时,现有模型往往难以做出合理判断,导致生成内容出现偏差或事实性错误。通过提供像 HealthContradict 这样的对抗性子集,其样本包含医学健康领域相互冲突的证据,它系统性地挑战模型对证据间关系(一致性、矛盾性、中立性)的建模能力。rag-plurality-dataset 的引入,为学术界提供了一面镜子,使得量化评估模型在多元证据下的决策质量成为可能,进而启发新的架构或训练策略,以增强模型的证据辨析力、冲突处理能力和答案的可信度,对提升 RAG 系统可靠性的学术探究具有里程碑式的意义。
衍生相关工作
基于 rag-plurality-dataset 的结构与挑战,学术界已衍生出一系列创新工作。一方面,研究者借鉴其成对证据与多来源标签的设计,构建了更为复杂的多文档推理基准,如融合事实核查与立场检测的复合型任务。另一方面,该数据集激发了关于证据偏好建模的研究,催生了基于对比学习或图神经网络的证据融合模块,旨在显式捕获证据间的关系。更前沿的方向包括利用该数据集开发检索器的自监督重排策略,或结合大语言模型上的少样本学习来动态生成反事实证据,以增强训练鲁棒性。这些工作共同编织了一张从评测到方法论的学术图谱,不断深化我们对 RAG 中知识多样性与一致性的理解。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

