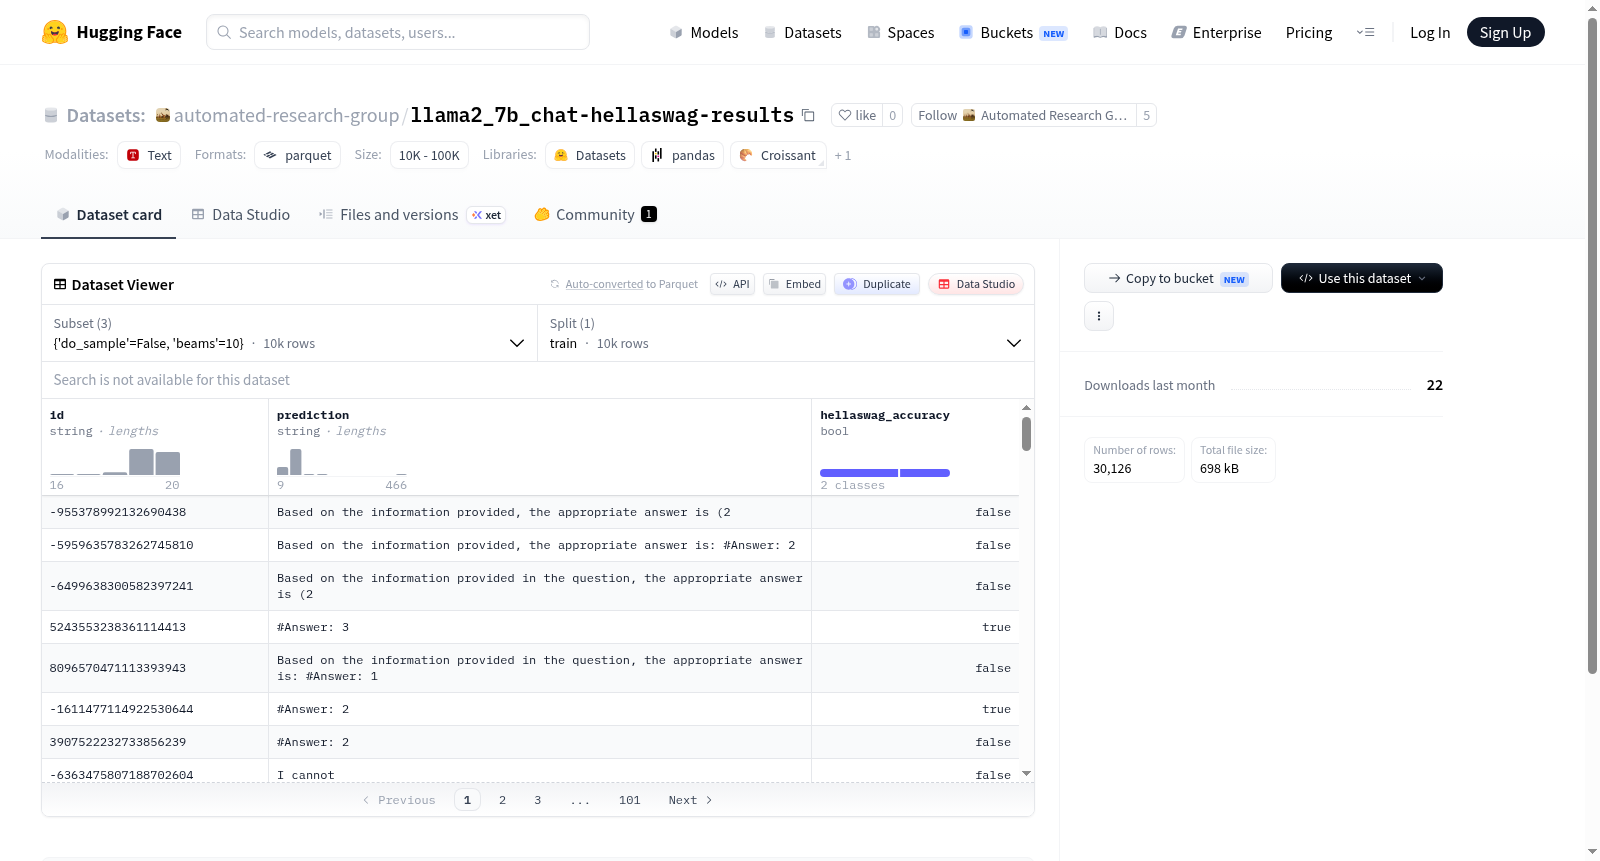
automated-research-group/llama2_7b_chat-hellaswag-results
收藏资源简介:
--- dataset_info: - config_name: '{''do_sample''=False, ''beams''=10}' features: - name: id dtype: string - name: prediction dtype: string - name: hellaswag_accuracy dtype: bool splits: - name: train num_bytes: 863833 num_examples: 10042 download_size: 237030 dataset_size: 863833 - config_name: '{''do_sample''=False, ''beams''=1}' features: - name: id dtype: string - name: prediction dtype: string - name: hellaswag_accuracy dtype: bool splits: - name: train num_bytes: 835788 num_examples: 10042 download_size: 228433 dataset_size: 835788 - config_name: '{''do_sample''=False, ''beams''=5}' features: - name: id dtype: string - name: prediction dtype: string - name: hellaswag_accuracy dtype: bool splits: - name: train num_bytes: 835788 num_examples: 10042 download_size: 228433 dataset_size: 835788 configs: - config_name: '{''do_sample''=False, ''beams''=10}' data_files: - split: train path: '{''do_sample''=False, ''beams''=10}/train-*' - config_name: '{''do_sample''=False, ''beams''=1}' data_files: - split: train path: '{''do_sample''=False, ''beams''=1}/train-*' - config_name: '{''do_sample''=False, ''beams''=5}' data_files: - split: train path: '{''do_sample''=False, ''beams''=5}/train-*' ---
数据集信息: - 配置名称:{'采样开关(do_sample)'=False, '束搜索束数(beams)'=10} 特征字段: - 名称:id(标识符),数据类型:字符串 - 名称:prediction(预测结果),数据类型:字符串 - 名称:hellaswag_accuracy(HellaSwag准确率),数据类型:布尔值 数据集拆分: - 拆分名称:训练集,字节数:863833,样本数量:10042 下载大小:237030,数据集总存储大小:863833 - 配置名称:{'采样开关(do_sample)'=False, '束搜索束数(beams)'=1} 特征字段: - 名称:id(标识符),数据类型:字符串 - 名称:prediction(预测结果),数据类型:字符串 - 名称:hellaswag_accuracy(HellaSwag准确率),数据类型:布尔值 数据集拆分: - 拆分名称:训练集,字节数:835788,样本数量:10042 下载大小:228433,数据集总存储大小:835788 - 配置名称:{'采样开关(do_sample)'=False, '束搜索束数(beams)'=5} 特征字段: - 名称:id(标识符),数据类型:字符串 - 名称:prediction(预测结果),数据类型:字符串 - 名称:hellaswag_accuracy(HellaSwag准确率),数据类型:布尔值 数据集拆分: - 拆分名称:训练集,字节数:835788,样本数量:10042 下载大小:228433,数据集总存储大小:835788 配置项: - 配置名称:{'采样开关(do_sample)'=False, '束搜索束数(beams)'=10} 数据文件: - 数据拆分:训练集,路径:{'do_sample'=False, 'beams'=10}/train-* - 配置名称:{'采样开关(do_sample)'=False, '束搜索束数(beams)'=1} 数据文件: - 数据拆分:训练集,路径:{'do_sample'=False, 'beams'=1}/train-* - 配置名称:{'采样开关(do_sample)'=False, '束搜索束数(beams)'=5} 数据文件: - 数据拆分:训练集,路径:{'do_sample'=False, 'beams'=5}/train-*
数据集配置
配置1
- 配置名称:
{do_sample=False, beams=10} - 特征:
id: 类型为stringprediction: 类型为stringhellaswag_accuracy: 类型为bool
- 分割:
train: 字节数为863833, 样本数为10042
- 下载大小:
237030字节 - 数据集大小:
863833字节 - 数据文件:
train: 路径为{do_sample=False, beams=10}/train-*
配置2
- 配置名称:
{do_sample=False, beams=1} - 特征:
id: 类型为stringprediction: 类型为stringhellaswag_accuracy: 类型为bool
- 分割:
train: 字节数为835788, 样本数为10042
- 下载大小:
228433字节 - 数据集大小:
835788字节 - 数据文件:
train: 路径为{do_sample=False, beams=1}/train-*
配置3
- 配置名称:
{do_sample=False, beams=5} - 特征:
id: 类型为stringprediction: 类型为stringhellaswag_accuracy: 类型为bool
- 分割:
train: 字节数为835788, 样本数为10042
- 下载大小:
228433字节 - 数据集大小:
835788字节 - 数据文件:
train: 路径为{do_sample=False, beams=5}/train-*