
遇见数据集

lucky-initialization-atlas-100m-v2

收藏
Hugging Face2026-08-16 更新2026-08-17 收录
官方服务:

资源简介:

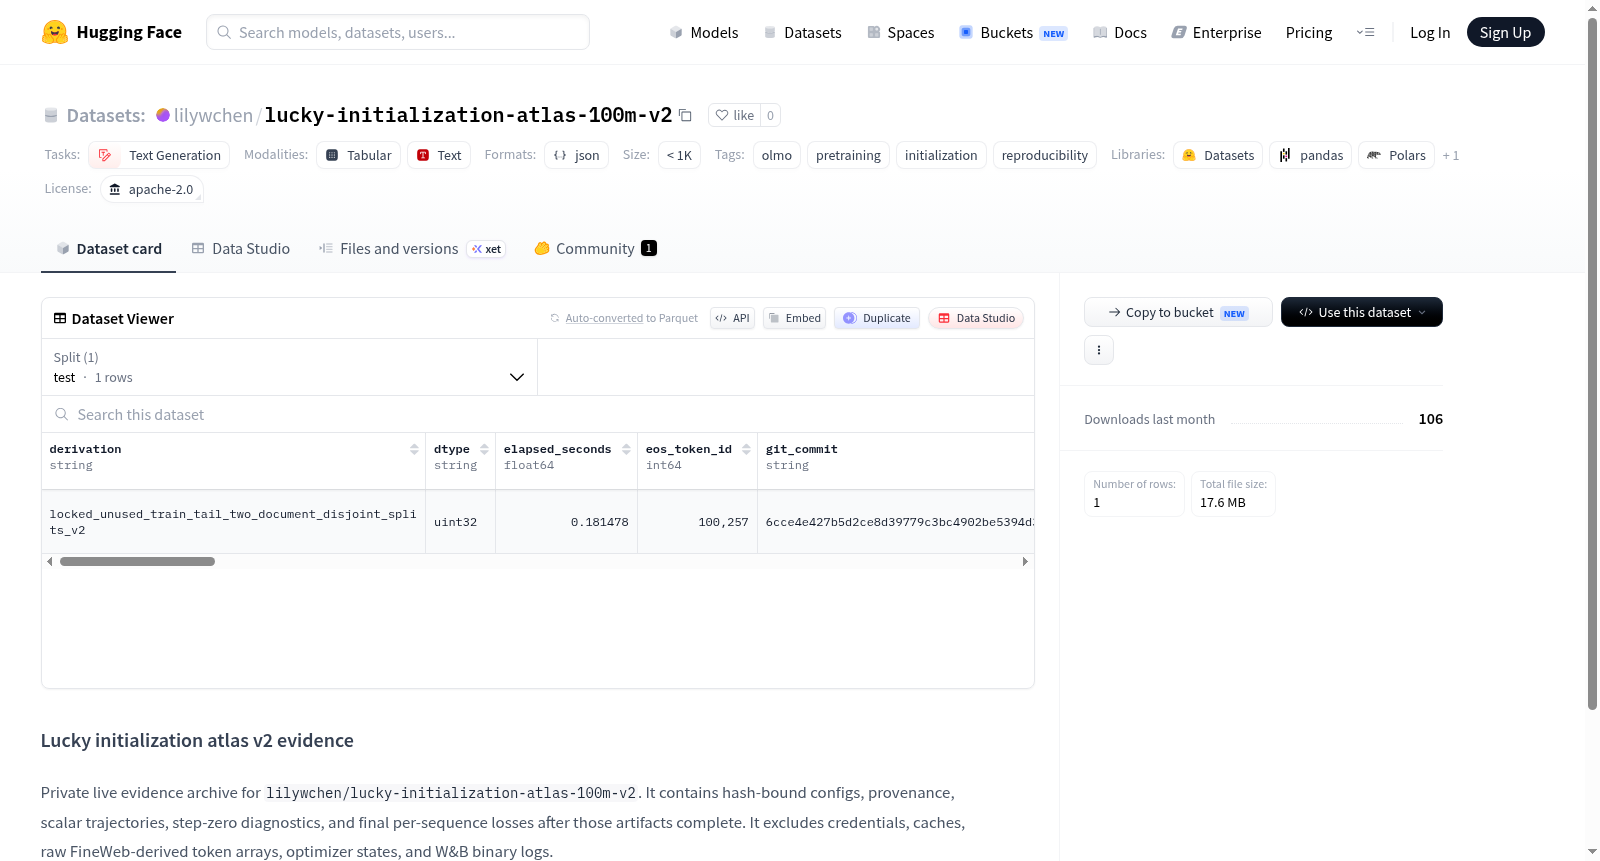
该数据集名为“Lucky Initialization Atlas 100M v2 Evidence”,是一个私有实时证据存档,用于支持 `lilywchen/lucky-initialization-atlas-100m-v2` 项目。数据集包含哈希绑定的配置、来源信息、标量轨迹、零步诊断以及最终每序列损失。它排除了凭证、缓存、原始 FineWeb 派生令牌数组、优化器状态和 W&B 二进制日志。数据集采用 Apache-2.0 许可证,任务类别为文本生成,标签包括 olmo、预训练、初始化和可复现性。

The dataset named Lucky Initialization Atlas 100M v2 Evidence is a private real-time evidence archive supporting the `lilywchen/lucky-initialization-atlas-100m-v2` project. It contains hash-bound configurations, source information, scalar trajectories, zero-step diagnostics, and final per-sequence losses. It excludes credentials, caches, raw FineWeb-derived token arrays, optimizer states, and W&B binary logs. The dataset is licensed under Apache-2.0, with task category text generation, and tags including olmo, pretraining, initialization, and reproducibility.

创建时间:
2026-08-15
原始信息汇总

Lucky Initialization Atlas 100M v2 Evidence 数据集详情

基本信息

  • 数据集名称:Lucky Initialization Atlas 100M v2 Evidence
  • 许可证:Apache 2.0
  • 任务类型:文本生成(text-generation)
  • 标签:OLMo、预训练、初始化、可复现性

内容概述

该数据集是 lilywchen/lucky-initialization-atlas-100m-v2私有实时证据存档,用于记录和追踪初始化实验的相关数据。

所含内容

  • 哈希绑定的配置文件
  • 数据来源与溯源信息
  • 标量轨迹(scalar trajectories)
  • 零步诊断(step-zero diagnostics)
  • 完成后的最终逐序列损失

排除内容

数据集不包含以下内容:

  • 凭证或密钥
  • 缓存文件
  • 原始 FineWeb 派生的 token 数组
  • 优化器状态
  • W&B 二进制日志

用途定位

该数据集主要用于支持初始化实验的可复现性研究与证据留存,服务于预训练相关的研究工作。
搜集汇总
数据集介绍
lucky-initialization-atlas-100m-v2 数据集图片
构建方式
该数据集是‘幸运初始化图谱v2’项目的实时证据档案,通过绑定哈希配置与来源追踪,系统性地记录从零步诊断到最终逐序列损失的全生命周期训练轨迹。其构建过程严格遵循可复现性原则,所有配置经哈希绑定确保不可篡改,同时排除凭据、缓存、原始FineWeb派生令牌数组、优化器状态及W&B二进制日志等敏感或冗余信息,从而形成一个精炼且高可信度的训练过程快照。
特点
该数据集的核心特征在于其作为‘私有实时证据档案’的定位,专注于捕捉模型初始化的偶然性对训练动态的影响。它提供了标量轨迹与逐序列损失的细粒度数据,为研究初始化策略提供了独特的视角。通过分离出轻量级、可公开的元数据与受保护的原始数据,数据集在透明度与隐私保护之间取得了平衡,同时其Apache 2.0许可确保了广泛的可复用性,适应于大规模预训练研究的严谨需求。
使用方法
该数据集适用于预训练模型初始化策略的深入分析,研究者可利用其哈希绑定的配置与来源信息复现实验条件,并借助零步诊断和逐序列损失数据评估初始化对收敛速度及最终性能的影响。标量轨迹便于可视化训练过程中的动态变化,而最终损失可用于下游任务的基准测试。使用时需注意其‘私有’属性,数据集不包含原始令牌数组和优化器状态,因此应聚焦于其提供的元数据层面,以进行实验对照、超参数调优或作为理论验证的实证基础。
背景与挑战
背景概述
在大规模语言模型预训练领域,随机初始化策略对模型性能具有不可忽视的影响。近年来,研究者们开始关注“幸运初始化”现象,即某些特定的权重初始化方式能够显著提升模型的收敛速度与最终表现。为此,华盛顿大学艾伦人工智能研究所(Ai2)的研究团队于2024年发起了“幸运初始化图谱”(Lucky Initialization Atlas)项目,旨在系统性地探索不同初始化策略对百亿参数规模(100M)模型的影响。该数据集v2版本作为项目的重要证据库,依托于OLMo架构,记录了大量实验的哈希绑定配置、数据来源、标量轨迹以及逐序列损失等关键信息,为复现性研究和初始化策略的实证分析提供了宝贵资源。这一数据集的发布不仅推动了初始化理论的发展,也为社区提供了高透明度的实验基准,对后续研究具有重要参考价值。
当前挑战
该数据集所解决的领域核心挑战在于,如何对语言模型预训练中的初期权重进行合理初始化。稀疏而复杂的优化地形常导致模型陷入局部最优或收敛缓慢,而幸运初始化的识别与验证需要大量计算资源和全面实验评估。在构建过程中,研究者面临多重数据管理难题:一方面,需要对多组实验配置进行严格的哈希绑定以保障可复现性,同时确保数据来源(provenance)的完整与清晰;另一方面,数据集中仅保留了必要的实验证据,排除了原始FineWeb派生词元数组、优化器状态及W&B二进制日志等敏感或大规模文件,这要求在信息充分性与存储成本之间取得微妙平衡。此外,实时追踪标量轨迹和最终逐序列损失,并剔除credentials、caches等无关内容,进一步增加了数据清洗与整理的复杂性。
常用场景
经典使用场景
该数据集作为大规模语言模型预训练可复现性的关键证据库,经典使用场景聚焦于验证不同随机初始化条件下模型训练的稳定性。研究者利用其哈希绑定的配置与标量轨迹,系统对比多种初始化种子对训练动态及最终性能的影响,从而在精细粒度上剖析初始化策略的敏感性。此数据集为复现实验提供了不可或缺的基准,使得训练过程中的早停诊断与损失变化趋势得以精确追踪。
衍生相关工作
该数据集衍生了一系列围绕初始化影响与训练可复现性的后续研究,例如基于其轨迹数据开发的自适应初始化搜索算法,以及分析不同初始化下梯度流行为的理论工作。它也促进了标准化预训练日志格式的提出,并激励了类似证据库的构建,以支持跨团队实验的元分析。这些衍生工作共同推动了语言模型预训练从经验实践向更系统化、科学化的方向演进。
数据集最近研究
最新研究方向
该数据集聚焦于预训练语言模型初始化策略的可复现性研究,其最新方向在于通过系统化记录配置哈希、数据溯源、标量轨迹及零步诊断等元数据,构建初始化条件的‘幸运图谱’,以探究不同随机种子对模型收敛行为与下游性能的因果影响。当前热点关联‘彩票假设’与‘初始化敏感性’的实证探索,旨在量化初始权重对训练动态的长期效应,并为超参数搜索提供轻量级替代方案。该数据集以Apache-2.0协议公开,虽剔除凭证与原始数据流,却为复现性基准和初始化理论验证提供了高价值证据,推动语言模型训练从经验调参向可解释的初始化设计范式演进,对降低大规模预训练试错成本具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

