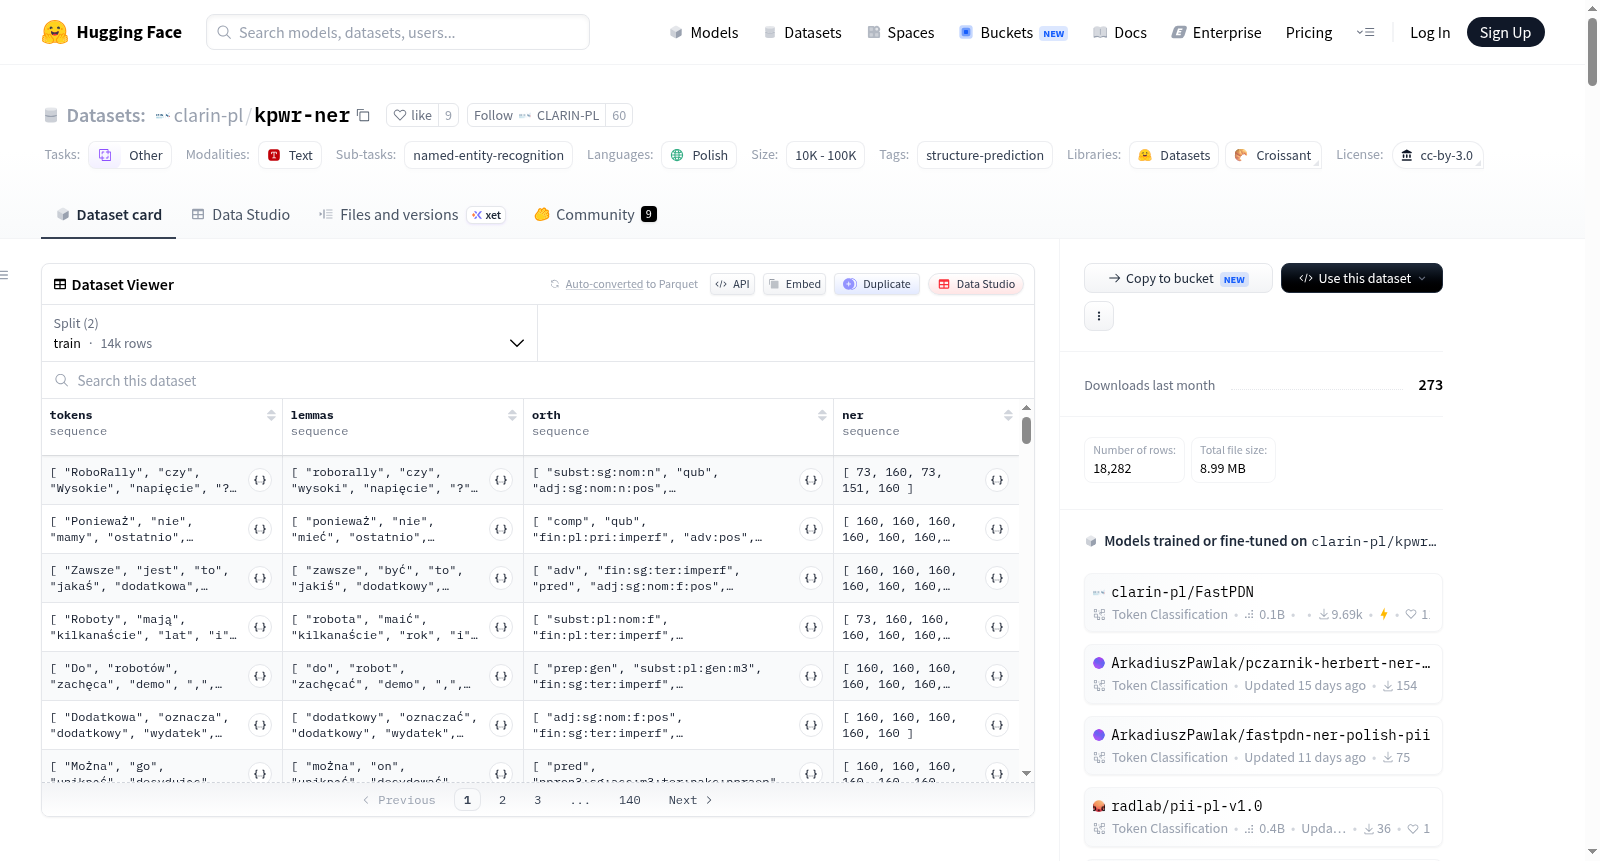
clarin-pl/kpwr-ner
收藏资源简介:
KPWR-NER是波兰弗罗茨瓦夫理工大学波兰语语料库的一部分,专注于细粒度实体类别的命名实体识别任务。该数据集包含来自多个领域和体裁的文本,并由人类进行标注。数据集的版本为n82,意味着类别数量限制为82个(原始为120个)。数据集的任务是命名实体识别,输入为一系列标记,输出为这些标记的类别序列,使用BIO标注法。数据集的评估指标为F1-score(seqeval)。数据集分为训练集和测试集,训练集包含13959个句子,测试集包含4323个句子。数据集的类别分布详细列出了各类别的频率。
KPWR-NER is part of the Polish language corpus from Wrocław University of Science and Technology, focusing on the named entity recognition (NER) task with fine-grained entity categories. This dataset contains texts from diverse domains and genres, and has been manually annotated by human annotators. The dataset is versioned as n82, which means the number of entity categories is limited to 82 (the original number was 120). The task of this dataset is named entity recognition: the input is a sequence of tokens, and the output is the category sequence of these tokens using the BIO annotation scheme. The evaluation metric for this dataset is F1-score (seqeval). The dataset is split into training and test sets: the training set contains 13,959 sentences, while the test set contains 4,323 sentences. The category distribution of the dataset details the frequency of each entity category.
数据集概述
基本信息
- 名称: KPWr-NER
- 语言: 波兰语 (pl)
- 许可证: CC-BY-3.0
- 多语言性: 单语
- 大小: 18K - 10K<n<100K
- 来源: 原始数据
- 任务类别: 其他
- 任务ID: 命名实体识别
- 标签: 结构预测
描述
KPWr-NER是波兰语料库的一部分,专注于细粒度实体的命名实体识别。该数据集是KPWr的‘n82’版本,实体类别限制为82种(原为120种)。数据集中的文本来自多个领域和体裁,由人工标注。
任务详情
- 任务: 命名实体识别 (NER)
- 输入: 序列的令牌
- 输出: 预测的令牌类别序列,使用BIO表示法(82种可能的类别)
- 评估指标: F1-score (seqeval)
数据分割
| 子集 | 基数(句子数) |
|---|---|
| 训练 | 13959 |
| 开发 | 0 |
| 测试 | 4323 |
类别分布
数据集提供了详细的类别分布,包括但不限于以下类别:
- B-nam_liv_person
- B-nam_loc_gpe_city
- B-nam_loc_gpe_country
- B-nam_org_institution
- B-nam_org_organization
- B-nam_org_group_team
- B-nam_adj_country
- B-nam_org_company
- B-nam_pro_media_periodic
- B-nam_fac_road
- B-nam_liv_god
- B-nam_org_nation
- B-nam_oth_tech
- B-nam_pro_media_web
- B-nam_fac_goe
- B-nam_eve_human
- B-nam_pro_title
- B-nam_pro_brand
- B-nam_org_political_party
- B-nam_loc_gpe_admin1
- B-nam_eve_human_sport
- B-nam_pro_software
- B-nam_adj
- B-nam_loc_gpe_admin3
- B-nam_pro_model_car
- B-nam_loc_hydronym_river
- B-nam_oth
- B-nam_pro_title_document
- B-nam_loc_astronomical
- B-nam_oth_currency
- B-nam_adj_city
- B-nam_org_group_band
- B-nam_loc_gpe_admin2
- B-nam_loc_gpe_district
- B-nam_loc_land_continent
- B-nam_loc_country_region
- B-nam_loc_land_mountain
- B-nam_pro_title_book
- B-nam_loc_historical_region
- B-nam_loc
- B-nam_eve
- B-nam_org_group
- B-nam_loc_land_island
- B-nam_pro_media_tv
- B-nam_liv_habitant
- B-nam_eve_human_cultural
- B-nam_pro_title_tv
- B-nam_oth_license
- B-nam_num_house
- B-nam_pro_title_treaty
- B-nam_fac_system
- B-nam_loc_gpe_subdivision
- B-nam_loc_land_region
- B-nam_pro_title_album
- B-nam_adj_person
- B-nam_fac_square
- B-nam_pro_award
- B-nam_eve_human_holiday
- B-nam_pro_title_song
- B-nam_pro_media_radio
- B-nam_pro_vehicle
- B-nam_oth_position
- B-nam_liv_animal
- B-nam_pro
- B-nam_oth_www
- B-nam_num_phone
- B-nam_pro_title_article
- B-nam_oth_data_format
- B-nam_fac_bridge
- B-nam_liv_character
- B-nam_pro_software_game
- B-nam_loc_hydronym_lake
- B-nam_loc_gpe_conurbation
- B-nam_pro_media
- B-nam_loc_land
- B-nam_loc_land_peak
- B-nam_fac_park
- B-nam_org_organization_sub
- B-nam_loc_hydronym
- B-nam_loc_hydronym_sea
- B-nam_loc_hydronym_ocean
- B-nam_fac_goe_stop