
VerboVision/cem_mil_pares_5k_pt_13
收藏官方服务:
资源简介:
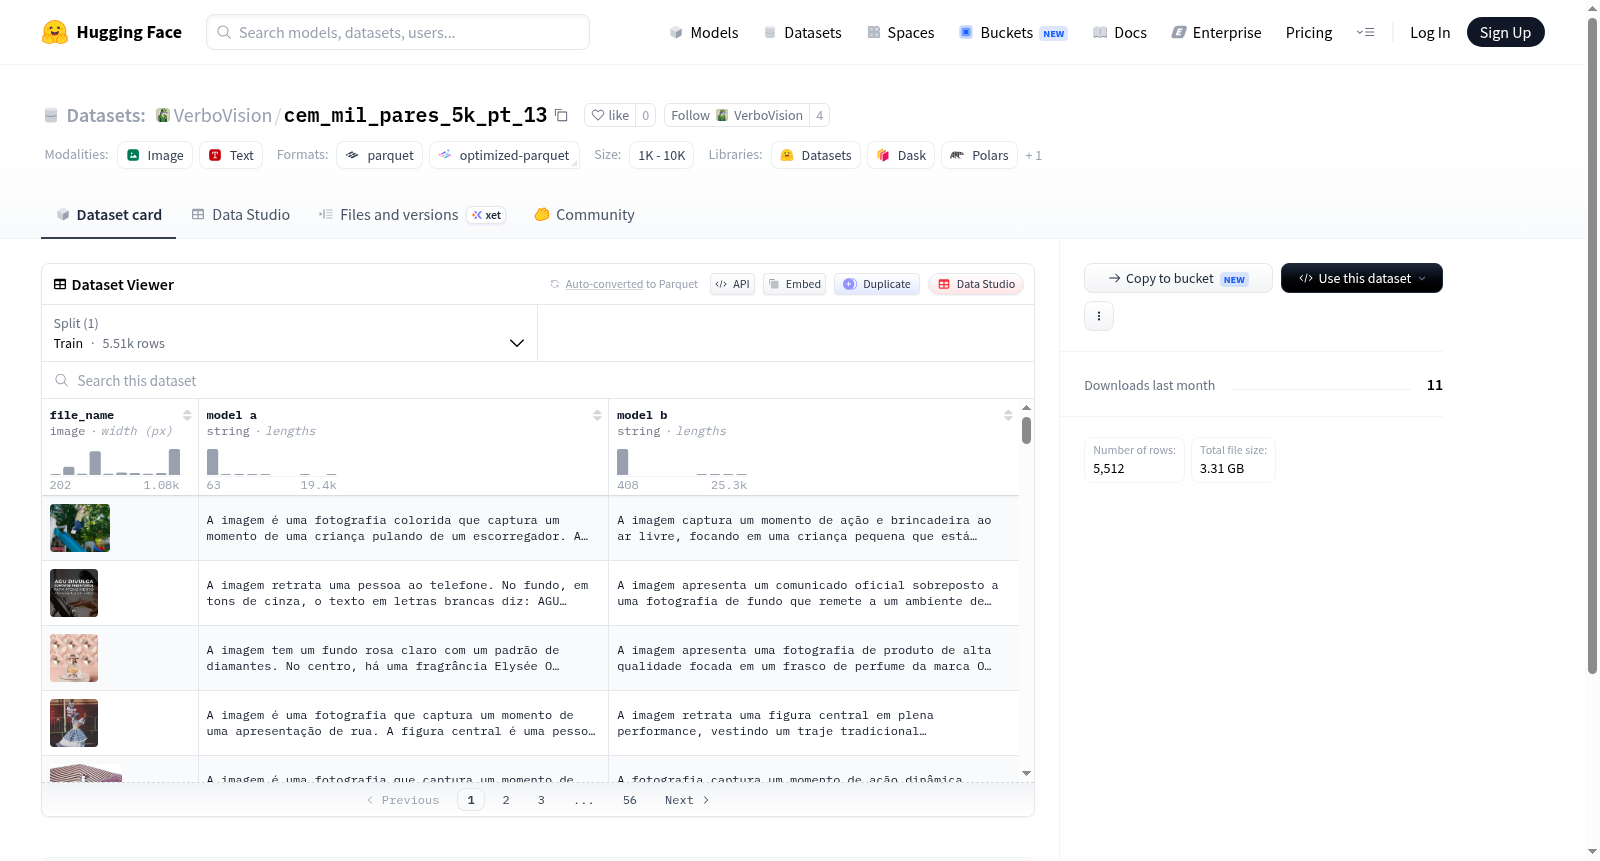
该数据集是一个包含5512个样本的训练集,主要用于图像和文本相关任务。每个样本包含三个特征:file_name(图像文件)、model a(字符串类型)和model b(字符串类型)。数据集总大小为3311569537字节,下载大小为3306002458字节,数据文件存储在data/Train-*路径下。数据集可能用于模型比较或评估,涉及图像与文本数据的结合,但具体应用场景未在README中详细说明。
This dataset is a training set comprising 5512 samples, primarily designed for tasks involving images and text. Each sample includes three features: file_name (image file), model a (string type), and model b (string type). The total dataset size is 3311569537 bytes, with a download size of 3306002458 bytes, and data files are stored in the path data/Train-*. The dataset may be used for model comparison or evaluation, involving the integration of image and text data, but specific application scenarios are not detailed in the README.
提供机构:
VerboVision搜集汇总
数据集介绍
构建方式
该数据集以图像与文本的配对结构为核心,构建了包含5512个样本的训练集。每个样本由三个字段组成:'file_name'字段存储图像数据,'model a'和'model b'字段分别存储对应的字符串文本信息。数据集以分片形式存储于'data/Train-*'路径下,总数据量约为3.3GB,体现了其在高容量视觉-语言数据存储上的设计思路。
特点
数据集的特点在于其简洁而明确的双文本-图像关联结构,每张图像均配有两个关联文本描述(model a与model b)。这种一对二的配对关系为多模态对比学习、文本语义相似性分析等任务提供了丰富的数据基础。数据集规模中等,单一训练集划分聚焦于模型训练场景,避免了复杂的验证或测试集干扰,便于研究者快速切入核心实验。
使用方法
使用该数据集时,可通过HuggingFace的datasets库加载default配置,自动读取Train分片下的所有数据。研究者需将'file_name'字段作为图像输入,利用'model a'和'model b'字段进行文本编码或对比模型训练。建议按需对图像进行预处理(如缩放或归一化),并将文本字段用于计算语义相似度或生成多模态嵌入向量,以支撑下游任务如图像-文本检索或图文匹配。
背景与挑战
背景概述
cem_mil_pares_5k_pt_13数据集创建于图像生成与文本对齐的交叉研究领域,由致力于葡萄牙语环境下视觉语言模型评估的研究机构开发。该数据集的核心研究问题聚焦于如何构建一个针对葡语场景、能够有效评估图像与文本对语义一致性的基准,从而弥补当前主流多模态数据集主要以英语为中心、缺乏低资源语言适配的不足。通过精心筛选超过5500组图像与成对文本样本,该数据集为研究人员提供了评估生成图像与描述匹配质量的标准化工具,在推动葡萄牙语多模态理解与生成技术的发展中发挥了关键作用,对促进语言多样性与人工智能包容性具有深远影响。
当前挑战
该数据集的构建面临多重挑战。在领域问题层面,它着力解决图像与葡语文本间语义匹配度的精准评估难题,尤其是处理葡萄牙语中特有的词汇歧义与文化特定表达,这要求模型超越粗粒度的视觉语义理解,达至细粒度对齐。在构建过程中,挑战包括获取足够数量且涵盖多样场景的高质量葡语图像-文本对,确保文本的自然性与地域代表性,同时需设计严格的审核流程以剔除噪声数据和潜在的文化偏见。此外,平衡数据集中不同视觉类别和语言结构的分布,避免因样本不平衡导致的评估偏差,也是构建过程中的关键难点。
常用场景
经典使用场景
cem_mil_pares_5k_pt_13 是一个专为葡萄牙语文本蕴含识别任务设计的数据集,其核心用途在于评估和训练自然语言理解模型对语义关系——尤其是蕴涵、矛盾和中立关系——的判别能力。该数据集包含了超过5000对经过标注的文本片段,每对由两个模型生成的句子组成,并附带人工标注的语义关系。研究者常将其用作基准测试平台,以衡量多语言预训练语言模型(如BERTimbau、XLM-R)在葡萄牙语上的推理表现,进而推动低资源语言场景下自然语言推理技术的进步。
衍生相关工作
该数据集的发布催生了多项后续研究工作,包括针对葡萄牙语的对抗性样本生成方法,用于系统性地测试模型对语义细微变化的鲁棒性。此外,基于该数据集,研究者提出了跨语言知识迁移策略,通过联合训练葡语与其他资源丰富语言的蕴含数据,改善了低资源场景下的迁移学习效果。还有工作围绕数据增强技术展开,利用回译和同义词替换扩充训练样本,进一步提升了模型在葡语NLI任务上的泛化能力,为多语言自然语言理解领域贡献了宝贵的实践经验。
数据集最近研究
最新研究方向
cem_mil_pares_5k_pt_13数据集聚焦于葡萄牙语环境下图像与文本对的语义匹配研究,其双模型评估框架(model a与model b)为多模态对齐、视觉语言预训练及跨模态检索提供了高精度基准。该数据集在当前前沿研究助力下,深度嵌入大规模多模态模型(如CLIP的葡萄牙语变体)的微调与鲁棒性测试,尤其在低资源语言的多模态理解任务中扮演关键角色。其构建不仅推动了本地化多模态系统的性能突破,还显著降低了视觉与文本歧义性,为构建包容性更强的跨语言AI应用树立了重要里程碑,呼应了全球多模态AI民主化与地域适配的热点趋势。
以上内容由遇见数据集搜集并总结生成


