
nz-research-commons-llama-groq-label-comparison
收藏数据链接:
官方服务:
资源简介:
该数据集是一个包含学术文献元数据及分类标签的数据集,适用于文本分类和模型预测评估任务。数据内容主要包括文献的标题、作者、出版年份、主题分类和摘要文本,同时包含人工标注的分类标签(含标签ID、字符串描述、置信度及标注理由)以及基于LLaMA模型生成的预测标签(含预测结果、置信度、理由及错误信息)。数据集还提供了人工标注与模型预测结果的比较字段,包括是否完全匹配、比较提供方、比较模型、比较类型等元信息。数据规模为1380个训练样本,每个样本包含23个字段,数据类型涵盖字符串、整型、浮点型和布尔型。该数据集可用于学术文献自动分类、自然语言处理模型评估、标注一致性分析等研究场景。
创建时间:
2026-06-22
原始信息汇总
- 数据集名称:nz-research-commons-llama-groq-label-comparison
- 数据集描述:该数据集用于比较 Llama 模型与 Groq 模型在分类标签上的表现,包含多维度标注和对比信息。
- 特征字段:
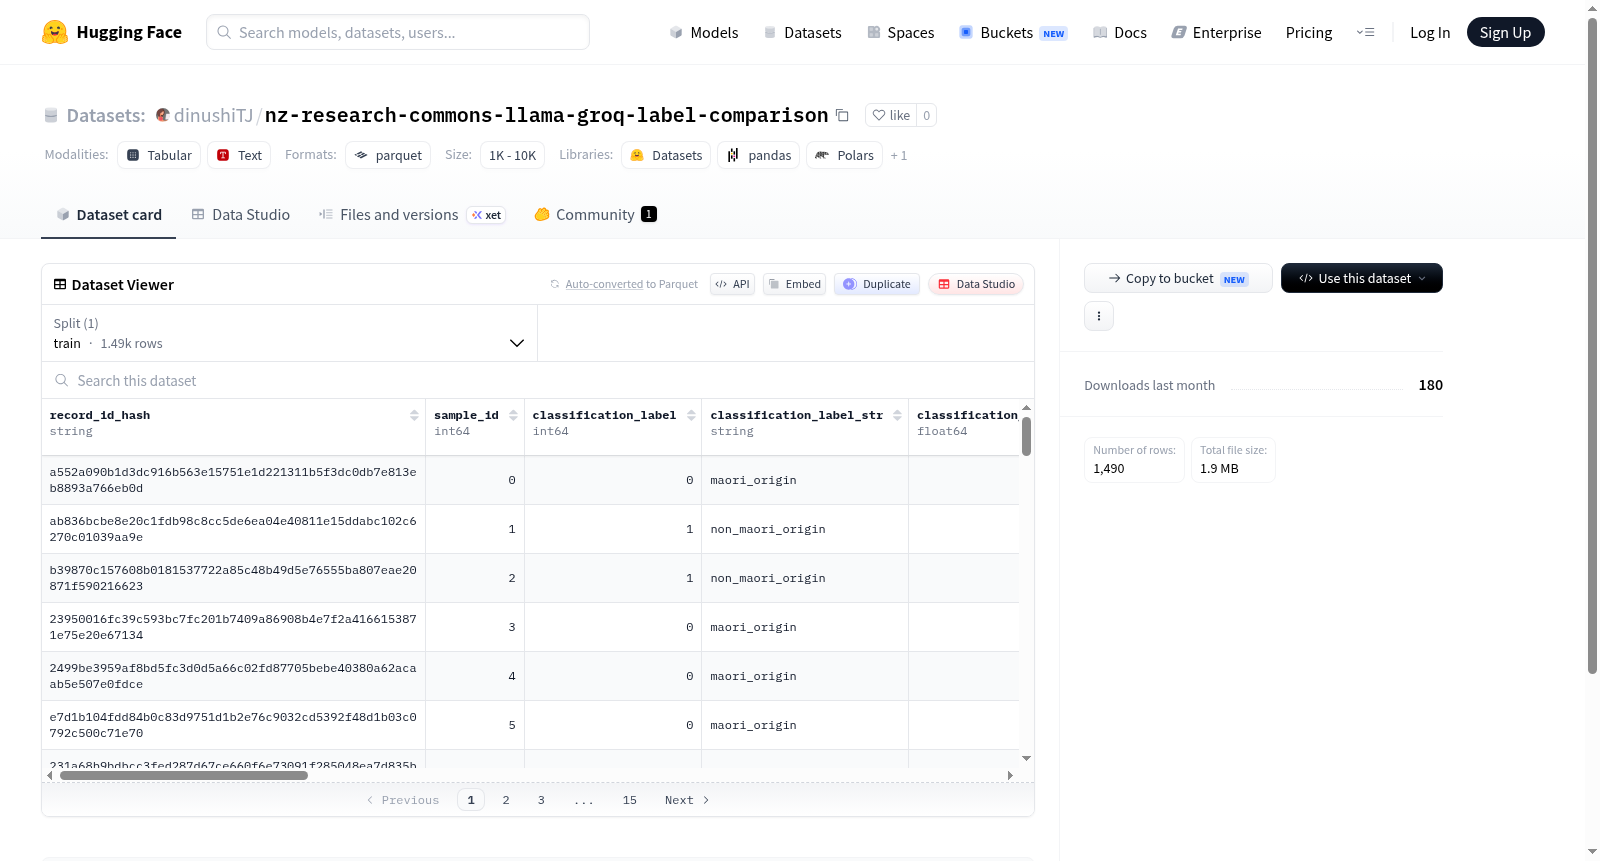
record_id_hash:记录 ID 哈希值(字符串)sample_id:样本 ID(整数)classification_label:分类标签(整数)classification_label_str:分类标签字符串(字符串)classification_confidence:分类置信度(浮点数)classification_reason:分类理由(字符串)title:标题(字符串)authors:作者(字符串)year:年份(字符串)subjects:主题(字符串)abstract:摘要(字符串)llama_label:Llama 模型输出的标签(字符串)llama_confidence:Llama 模型置信度(浮点数)llama_reason:Llama 模型输出理由(字符串)llama_error:Llama 模型错误信息(字符串)exact_match:是否精确匹配(布尔值)comparison_provider:对比服务商(字符串)comparison_model:对比模型(字符串)comparison_type:对比类型(字符串)prompt_version:提示词版本(字符串)sample_type:样本类型(字符串)n_per_class:每类样本数(整数)random_seed:随机种子(整数)
- 数据划分:
- 训练集(train):包含 1470 个样本,大小为 3,619,473 字节
- 下载大小:1,873,061 字节
- 数据集总大小:3,619,473 字节
- 配置:
- 默认配置(default):训练集数据路径为
data/train-*
- 默认配置(default):训练集数据路径为
搜集汇总
数据集介绍
构建方式
本数据集旨在对比不同语言模型在文献分类任务中的表现,特别是针对学术文献的元数据。数据集构建过程中,首先从文献数据库中采样记录,每条记录包含标题、作者、年份、学科主题及摘要信息。随后,利用Groq平台上的Llama模型对每条文献进行分类,生成分类标签、置信度分数以及推理过程。同时,保留了原始的分类标签(classification_label)作为基准。通过比较Llama模型的输出与原始标签,计算精确匹配(exact_match)指标,并记录比较所用模型、提供方及提示版本等元信息,形成了这套包含1490条样本的综合对比数据集。
特点
数据集的一个显著特点是其多维度的对比设计。每条样本不仅包含文献的原始元数据(如标题、摘要),还同时记录了Llama模型的分类结果(llama_label、llama_confidence、llama_reason)以及对应的原始分类标签。通过exact_match字段可以直接评估模型分类的准确性。此外,数据集中还包含了分类置信度、推理文本和错误信息,为深入分析模型行为提供了丰富素材。数据集覆盖了多种学科主题,确保了样本的多样性,而sample_id和record_id_hash的引入则为数据追踪和去重提供了便利。
使用方法
该数据集适用于自然语言处理中的文本分类评估与模型对比研究。使用者可以加载训练集(train split),利用标题和摘要等文本字段作为输入特征,将原始分类标签作为真值,评估Llama模型的分类性能。exact_match字段可直接用于计算准确率,而classification_confidence和llama_confidence可用于分析模型置信度与正确性的关系。classification_reason和llama_reason字段可支持可解释性研究,探究模型决策背后的逻辑。由于数据集提供了详细的元信息,研究者还可以按学科主题、样本类型等维度进行分层分析,深入理解模型在不同子集上的表现差异。
背景与挑战
背景概述
该数据集由新西兰研究机构(New Zealand Research Commons)创建,旨在评估大型语言模型(LLM)在科研文献自动分类任务中的表现。研究围绕Llama模型与人工标注的标签一致性展开,核心问题在于探索LLM能否高效、准确地替代传统人工分类流程,以加速科研文献的组织与检索。数据集包含1490条训练样本,每条样本涵盖标题、作者、摘要、年份及分类标签等元数据,并记录了Llama模型的预测标签、置信度及推理过程。作为开放科学领域的重要资源,该数据集为验证LLM在学术文本理解与分类中的可靠性提供了基准,推动了自动化文献管理技术的发展。
当前挑战
该数据集面临的挑战首先在于解决科研文献分类中人工标注成本高、效率低的问题,LLM需在保持高准确率的同时适应跨学科、多主题的复杂文本分类任务。构建过程中,挑战包括确保标签一致性:Llama模型与人工标注的差异(exact_match字段)揭示了自动分类的主观偏差与语义歧义;同时需处理模型的不确定性(如低置信度预测)和错误输出(llama_error字段),并平衡不同样本类型的代表性(sample_type字段)。此外,提示工程(prompt_version字段)对分类效果的影响也需系统评估,以优化模型在科研文献中的泛化能力。
常用场景
经典使用场景
该数据集旨在评估和比较不同大语言模型(如Llama与Groq)在学术文献分类任务中的表现。其核心应用在于通过记录模型对文献标题、摘要等元数据的分类标签、置信度与推理理由,构建一个多维度的人工与模型标注对比基准。研究者可借此检验语言模型在领域细粒度分类上的精确性、一致性与误差模式,尤其适用于分析模型在处理结构化科研文本时的语义理解能力。
实际应用
在实际科研场景中,该数据集可支撑学术搜索引擎的智能分类、科研基金项目的自动标注、以及文献库的主题聚合等下游任务。图书馆与知识图谱构建方能够利用此类标注对齐数据,优化自动编目流程;科技政策分析者则可依据模型分类置信度与误差分布,快速识别文献归属的潜在偏差。这些应用显著提升了科研数据治理的效率与客观性。
衍生相关工作
该数据集激发了多项衍生研究,包括基于交叉验证的模型对比框架(如引入更多LLM提供者)、面向文献分类的提示工程优化策略,以及针对低置信度样本的主动学习算法。部分工作进一步融合了误差分析结果以改进分类器的推理链可解释性,还有研究基于此数据集构建了领域自适应校准模型。这些成果共同推进了语言模型在学术数据价值链中的可靠整合。
以上内容由遇见数据集搜集并总结生成


