
遇见数据集

telugu-book-line-images-tesseract

收藏
Hugging Face2026-07-27 更新2026-07-28 收录
官方服务:

资源简介:

该数据集是一个用于光学字符识别(OCR)任务的大规模图像文本数据集,包含约244万条样本,总数据量约8.84GB。数据集分为五个独立配置(set_1至set_5),每个配置具有相同的结构特征。每条样本包含以下字段:行级文本图像(line_image)、原始文件名(file_name)、页码(page_number)、图像宽度(image_width)、Tesseract OCR引擎的识别文本结果(pred_tesseract)以及对应的识别置信度分数(tesseract_score)。所有数据均标记为训练集,适用于OCR模型的训练、评估或相关文本识别任务的研究与开发。

This dataset is a large-scale image-text dataset for Optical Character Recognition (OCR) tasks, containing approximately 2.44 million samples with a total data volume of about 8.84GB. The dataset is divided into five independent configurations (set_1 to set_5), each with the same structural characteristics. Each sample includes the following fields: line-level text image (line_image), original file name (file_name), page number (page_number), image width (image_width), recognition text results from the Tesseract OCR engine (pred_tesseract), and corresponding recognition confidence scores (tesseract_score). All data is labeled as a training set and is suitable for the training and evaluation of OCR models, as well as research and development in related text recognition tasks.

创建时间:
2026-07-27
原始信息汇总

数据集概述:telugu-book-line-images-tesseract

该数据集专注于泰卢固语(Telugu)书籍的行级图像,并包含由 Tesseract OCR 引擎生成的预测文本和评分,适用于 OCR 模型训练与评估。

数据集配置与规模

数据集包含 5 个配置(config)set_1set_5。每个配置均为单训练集(train split),具体规模如下:

配置名称 样本数量 数据集大小 下载大小
set_1 505,291 1.79 GB 1.73 GB
set_2 503,849 1.94 GB 1.89 GB
set_3 500,804 1.65 GB 1.60 GB
set_4 503,363 1.73 GB 1.67 GB
set_5 429,578 1.50 GB 1.45 GB
  • 总计样本数:约 244 万行图像。
  • 总计下载大小:约 8.96 GB。
  • 总计数据集大小:约 9.24 GB。

数据特征

每个样本包含 6 个字段

字段名 类型 说明
line_image 图像(image) 泰卢固语书籍的行级图像。
file_name 字符串(string) 图像对应的原始文件名。
page_number 整数(int64) 图像所在书籍的页码。
image_width 整数(int64) 图像的宽度(像素)。
pred_tesseract 字符串(string) Tesseract OCR 引擎对该行图像的文本预测结果。
tesseract_score 浮点数(float64) Tesseract 预测结果的置信度分数。

数据来源与用途

  • 来源:泰卢固语书籍的行级图像及对应的 Tesseract OCR 预测。
  • 用途:可用于训练和改进面向泰卢固语文本的 OCR 模型,或用于评估 Tesseract 在泰卢固语场景下的识别性能。
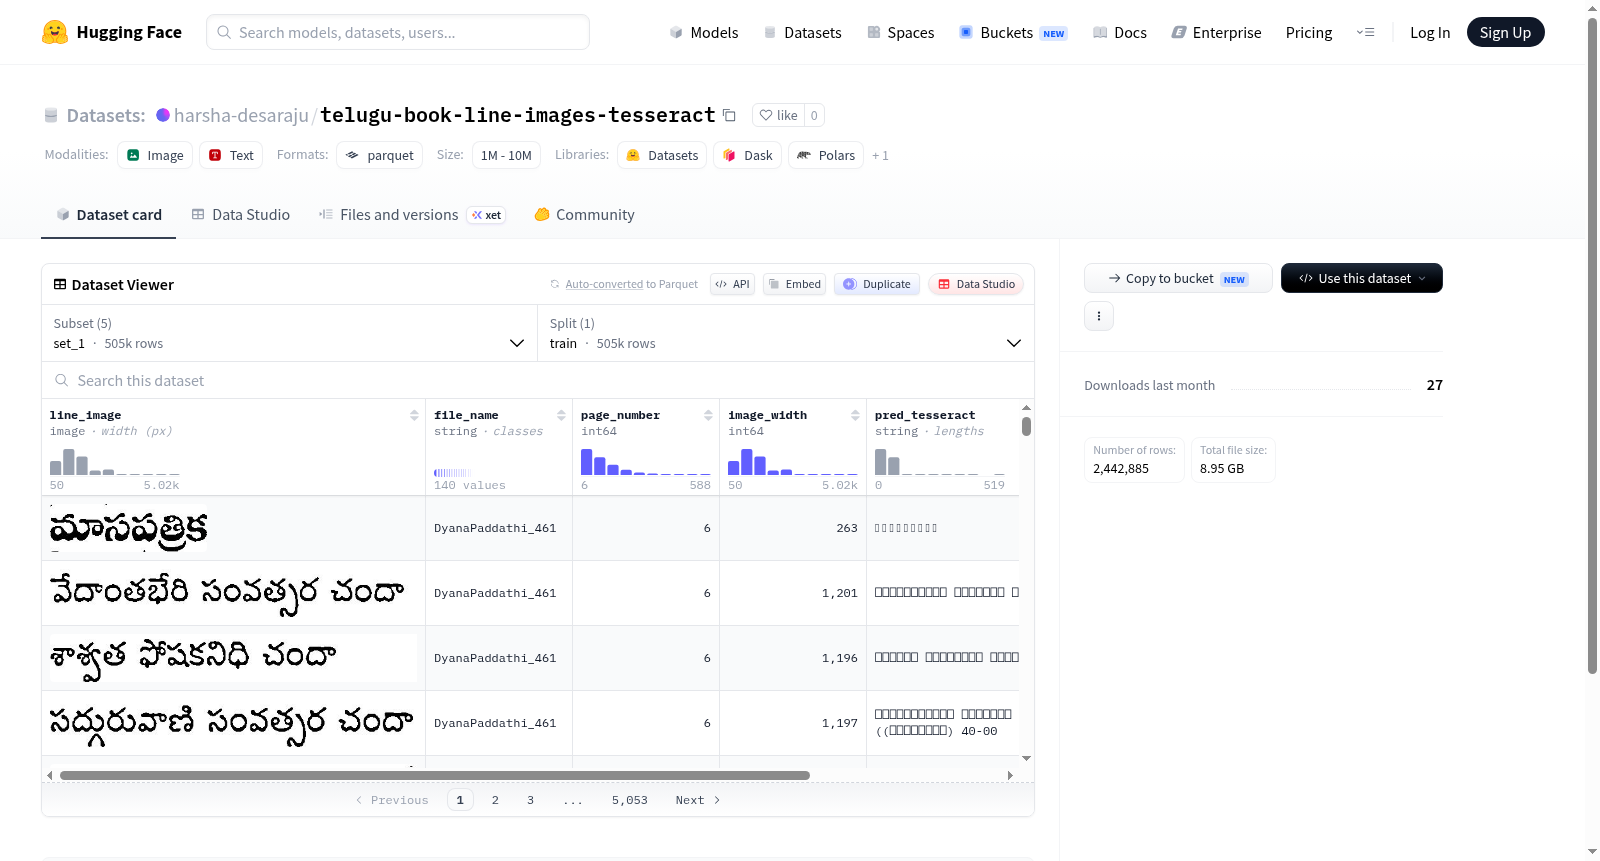
搜集汇总
数据集介绍
telugu-book-line-images-tesseract 数据集图片
构建方式
telugu-book-line-images-tesseract数据集由五个子集(set_1至set_5)构成,每个子集均包含约40万至50万条样本,总计超过244万条。该数据集源自泰卢固语书籍的页面图像,通过将页面分割为单行图像(line_image),并利用Tesseract OCR引擎对每行图像进行文字识别,生成预测文本(pred_tesseract)及其置信度分数(tesseract_score)。每一行图像还关联了原始文件名(file_name)、页面编号(page_number)及图像宽度(image_width),确保了数据与来源页面的可追溯性。
特点
该数据集的核心特点在于其大规模、多子集的结构以及精细的OCR标注信息。每个子集独立提供训练数据,行图像与OCR预测结果成对存在,便于研究者直接用于泰卢固语光学字符识别(OCR)模型的训练与评估。tesseract_score字段提供了预测质量的量化指标,有助于筛选高质量的标注样本。此外,数据集保留了页面级上下文(page_number),支持按页面组织或序列化分析,增强了数据在文档理解任务中的实用性。
使用方法
用户可通过Hugging Face Datasets库加载该数据集,并利用config_name参数选择特定子集(如set_1)以控制数据规模。加载后,每一条样本包含图像(line_image)、文件名、页码、图像宽度、OCR预测文本及置信度分数。典型的使用方式包括:将line_image作为输入特征,pred_tesseract作为标签进行OCR模型微调;或根据tesseract_score阈值过滤低置信度样本以提升训练质量。数据集仅提供训练分割,适合直接用于监督学习流程。
背景与挑战
背景概述
泰卢固语作为印度使用广泛的语言之一,其文献数字化与光学字符识别(OCR)技术的发展对文化遗产保存与信息检索具有重要意义。telugu-book-line-images-tesseract数据集由研究团队构建,旨在为泰卢固语文本行图像提供高质量的Tesseract OCR预测结果及其置信度评分,核心研究问题聚焦于提升低资源语言的OCR识别精度。该数据集包含超过240万条文本行图像样本,分五个子集发布,覆盖广泛的书页布局与字体风格,为相关领域提供了基准测试与模型训练的宝贵资源,对推动泰卢固语OCR系统的改进与多语言OCR技术的泛化研究产生了深远影响。
当前挑战
该数据集主要应对两大挑战。领域问题层面,泰卢固语复杂的连笔字、多样化的字体及变音符号给传统OCR带来巨大困难,Tesseract引擎在低资源语言上的识别错误率远高于主流语言,数据集通过提供大量标注行图像与预测评分,为算法优化提供了基准。构建过程中,面临泰卢固语书籍扫描件的噪声干扰、页面分割的不规则性以及少量标注数据迁移至新场景的泛化难题,团队需协调多个子集间的数据分布差异,确保训练集的多样性以反映真实世界中的应用挑战。
常用场景
经典使用场景
在光学字符识别(OCR)领域,泰卢固语作为一种高度音节化和笔画复杂的印度语言,其文本识别长期面临缺乏大规模标注语料的困境。telugu-book-line-images-tesseract数据集应运而生,它提供了超过240万张来自泰卢固语书籍的行级图像,每张图像都附有Tesseract OCR引擎的预测文本和置信度分数。该数据集最经典的使用场景是作为基准测试平台,用于评估和比较不同OCR模型在泰卢固语文本识别上的性能,尤其是针对古籍和现代印刷书籍的混合场景。研究者可以通过该数据集的标准化分割(如set_1至set_5五个子集),进行模型训练、验证和跨语言泛化能力测试,从而推动低资源语言OCR技术的发展。
实际应用
在实际应用层面,该数据集直接服务于泰卢固语书籍的数字化工程,例如大规模历史档案的电子化存档和在线手稿库的构建。出版社和数字图书馆可以利用基于该数据集训练的模型,自动将泰卢固语印刷品转换为可搜索的电子文本,大幅降低人工录入成本。此外,该数据集也为移动端扫描应用、政府公文处理以及教育领域的文献检索系统提供了底层技术支撑,使得非英语母语者能够更便捷地获取泰卢固语知识资源,从而促进地区文化的数字化传播与保护。
衍生相关工作
围绕telugu-book-line-images-tesseract数据集,学术界已衍生出多项经典工作。研究者基于该数据集的弱标注特性,开发了多种自训练框架,例如利用高置信度伪标签迭代优化识别模型,或者设计多任务学习架构同时预测文本行和纠正Tesseract输出。此外,该数据集也被用于跨语言迁移学习研究,作为泰卢固语基础语料来辅助其他低资源达罗毗荼语言(如泰米尔语、卡纳达语)的OCR模型初始化。一些工作还探索了结合行级图像宽度和页面编号等元数据,构建端到端的文档布局分析系统,实现了从页面分割到文本识别的完整流水线。这些衍生研究共同推动了低资源OCR领域从实验室走向实际部署的进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

