
遇见数据集

lamm-mit/BeamRL-EvalData-v2

收藏
Hugging Face2026-07-02 更新2026-07-22 收录
官方服务:

资源简介:

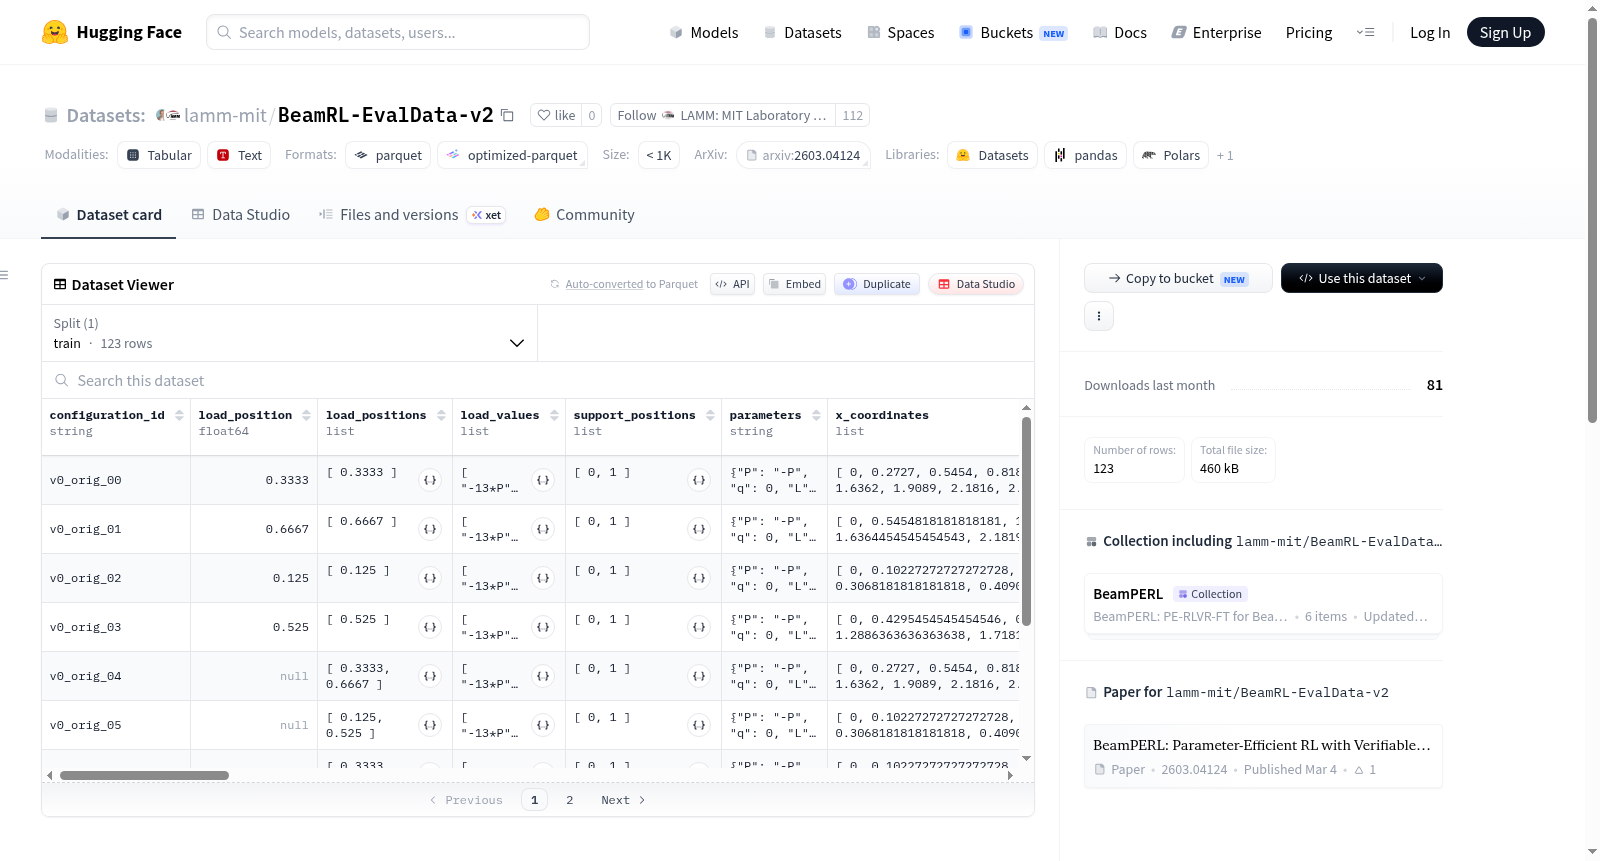
BeamRL-EvalData-v2是一个扩展的评估数据集,专为BeamPERL项目设计,包含123个符号梁力学问题,旨在计算支座反力。数据集中每个问题的真实答案以负载符号P的带符号系数形式给出(例如0.222222P)。数据集涵盖多个类别:id(单点载荷,支座在梁端)、ood_loads(2-4个点载荷,支座在梁端)、ood_supports(不同支座位置,1-3个点载荷)、ood_dist_left/ood_dist_middle/ood_dist_right(分布载荷分别锚定在铰支座、完全内部或滚支座上)、ood_length(梁长度变化为7L、11L、13L)和ood_moment(纯应用力偶,无点载荷)。原始24样本评估集作为子集包含在内。所有配置均使用修改版的SymBeam符号求解,并通过力/力矩平衡验证;自然语言问题变体由LLM生成,每个样本有4个查询,评估工具使用query[0]。数据集由BeamPERL仓库中的DataGen/generate_eval_v2.py脚本生成。

BeamRL-EvalData-v2 is an expanded evaluation dataset for BeamPERL, consisting of 123 symbolic beam-mechanics problems that ask for the reaction forces at the supports, with ground-truth answers as signed coefficients of the load symbol P (e.g., 0.222222P). The dataset includes categories such as id (single point load, supports at beam ends), ood_loads (2–4 point loads, supports at beam ends), ood_supports (varying support positions, 1–3 point loads), ood_dist_left/ood_dist_middle/ood_dist_right (distributed load anchored to the pin/fully interior/anchored to the roller), ood_length (beam length varied as 7L, 11L, 13L), and ood_moment (pure applied couple, no point load). The original 24-sample evaluation set is included as a subset. All configurations are solved symbolically with a modified SymBeam and verified for force/moment balance; natural-language question variants (4 per sample, with the evaluation harness consuming query[0]) are generated with an LLM. The dataset is produced by DataGen/generate_eval_v2.py in the BeamPERL repository.
提供机构:
lamm-mit
搜集汇总
数据集介绍
lamm-mit/BeamRL-EvalData-v2 数据集图片
构建方式
BeamRL-EvalData-v2是一个面向梁力学符号推理的评估数据集,其构建基于BeamPERL框架,旨在扩展原始24样本评估集。该数据集包含123个符号化的梁力学问题,所有工况均通过改进的SymBeam工具进行符号求解,并经过力与力矩平衡的严格验证。每个样本配备四个由大语言模型生成的自然语言问题变体,其中首个问题被评估框架采用。数据集生成代码(DataGen/generate_eval_v2.py)及原始子集均集成于BeamPERL代码仓库中,确保了构建流程的可复现性与完整性。
特点
该数据集的核心特征在于其系统性覆盖了梁力学问题的多样泛化场景。除包含原始评估集的点载荷与端部支撑样本外,新增了多重点载荷、可变支撑位置、分布载荷加载位置变化(如分布载荷锚定于销钉或滚轴支撑)、梁长度缩放及纯力矩作用等六类泛化测试。所有样本均采用符号解表达,以载荷符号P的有符号系数(如0.222222P)作为真实答案,精准刻画了支撑反力的代数形式。这种设计使得BeamRL-EvalData-v2成为评估物理推理模型泛化能力的理想基准。
使用方法
使用BeamRL-EvalData-v2时,用户可通过HuggingFace Datasets库直接加载,数据集包含'default'配置项,训练分割文件位于'data/train-*'路径。每个样本提供了configuration_id、几何载荷参数、剪力与弯矩分布、挠度信息及支撑反力等结构化字段。建议使用query[0]字段作为评估输入,answer字段作为参考答案。该数据集特别适合用于衡量大语言模型或神经符号系统在符号物理推理任务中的表现,尤其可配合BeamPERL框架进行泛化能力测试。
背景与挑战
背景概述
BeamRL-EvalData-v2 数据集由麻省理工学院LAMM实验室的研究团队于2025年创建,旨在评估结构力学领域中基于强化学习的符号推理模型。该数据集以梁力学问题为核心,聚焦于求解支座反力这一经典工程问题,其创新之处在于通过符号力学引擎SymBeam生成精确的解析解,并利用大语言模型生成多样化的自然语言问题变体。作为BeamPERL模型的评测基准,该数据集包含了123个精心设计的符号梁力学问题,覆盖了从简单单点荷载到复杂分布荷载、变梁长及纯力偶作用等多种工况,为评估模型在分布外泛化能力方面提供了系统性的测试框架。
当前挑战
该数据集的核心挑战在于解决传统数值方法难以应对的符号推理泛化问题。在领域层面,梁力学问题的符号计算要求模型不仅掌握基本力学定律,还需具备代数运算和逻辑推理能力,这对现有机器学习模型而言是一项严峻考验。在构建过程中,团队面临的挑战包括:如何确保SymBeam生成的结果在力与力矩平衡上严格自洽,如何设计覆盖不同难度和模式的测试场景以全面评估模型泛化能力,以及如何通过大语言模型生成高质量、多样化的自然语言查询,避免语义歧义对评测结果的干扰。这些挑战共同构成了该数据集在符号力学推理评测中的独特价值。
常用场景
经典使用场景
在结构力学与人工智能交叉研究领域,BeamRL-EvalData-v2数据集被广泛用于评估大型语言模型对梁力学问题的符号推理能力。该数据集包含123个具有明确符号解的梁问题实例,涵盖简支梁、悬臂梁、分布荷载、集中力偶等多种经典工况,研究人员通常利用其多级困难梯度(包括分布荷载位置变化、梁长缩放、支座偏移等),系统性地检验模型在物理规律理解与数学符号运算方面的泛化性能。
衍生相关工作
该数据集是BeamPERL(基于偏好对齐的梁力学推理语言模型)评测框架的关键组件,其设计理念直接催生了后续将符号推理与强化学习奖励模型结合的研究方向。在学术界,受此数据集启发的相关工作还包括面向多跨连续梁与超静定结构的扩展评测集构建,以及将符号解验证机制融入大模型后训练阶段的对比学习范式。这些衍进工作共同构筑了从静态评测到动态能力增强的研究链条。
数据集最近研究
最新研究方向
基于梁力学符号推理的结构工程评估数据集,BeamRL-EvalData-v2通过扩展载荷类型、支撑位置与梁长参数,系统设计了涵盖分布载荷、纯弯矩及多集中力工况的123个案例,为强化学习方法在物理符号计算中的泛化能力评估提供了结构化基准。该数据集与BeamPERL框架协同,可推动大型语言模型与强化学习在结构力学解析求解中的前沿探索,尤其在处理分布载荷分段、非标准支撑布局及变梁长条件时,为量化模型对物理约束的遵循程度与符号推理的鲁棒性开辟了新的验证维度,对智能结构设计自动化具有重要支撑价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

