
mohdali1/baltivoice-asr
收藏官方服务:
资源简介:
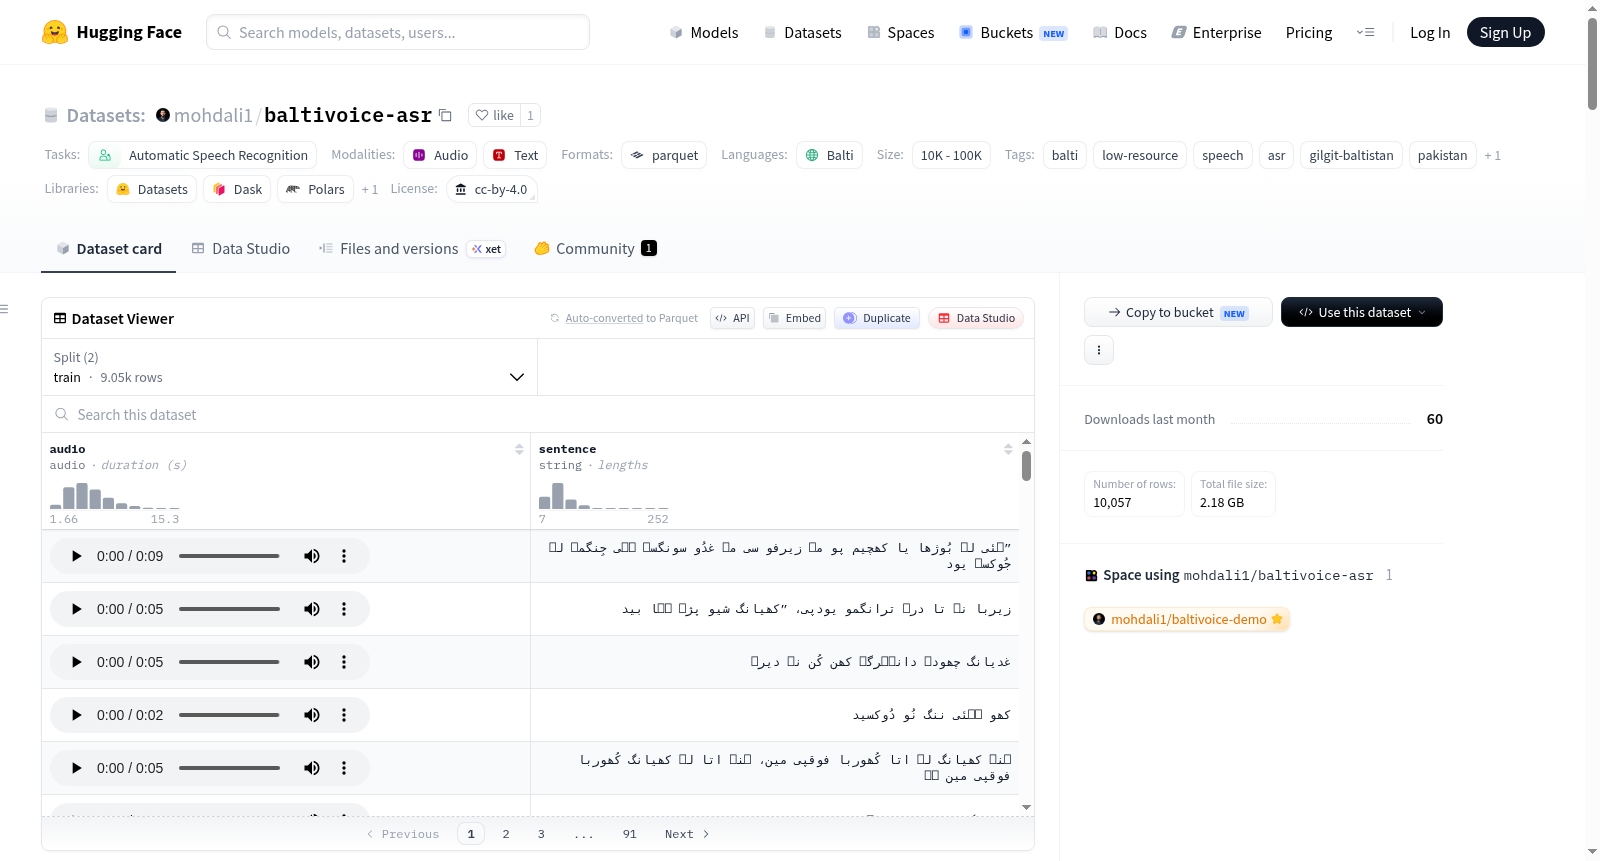
BaltiVoice是首个公开可用的Balti语言(ISO 639-3: bft)自动语音识别(ASR)数据集之一,Balti是一种极度低资源的藏语系语言,主要使用于巴基斯坦的吉尔吉特-巴尔蒂斯坦地区和印度(拉达克)部分地区。该数据集收集、验证和处理于一个组合研究项目中,旨在通过微调OpenAI Whisper构建首个开源Balti ASR系统。
BaltiVoice is one of the first publicly available Automatic Speech Recognition (ASR) datasets for the Balti language (ISO 639-3: bft), a critically low-resource Tibetic language spoken primarily in the Gilgit-Baltistan region of Pakistan and parts of India (Ladakh). This dataset was collected, validated, and processed as part of a portfolio research project aimed at building the first open-source Balti ASR system using OpenAI Whisper fine-tuning.
提供机构:
mohdali1搜集汇总
数据集介绍
构建方式
BaltiVoice ASR数据集是首个公开可用的巴尔蒂语自动语音识别资源,其构建依托于Mozilla Common Voice项目中巴尔蒂语贡献数据,经过严格筛选仅保留已验证的录音片段,最终汇聚成包含10,060条语音样本的集合。在划分训练集与验证集时,采用了基于说话人身份标识的GroupShuffleSplit方法,确保两组数据完全由不同的说话人构成,彻底消除说话人重叠,从而为模型评估提供无偏见的基准。
特点
该数据集涵盖约16.8小时的语音内容,由136位巴尔蒂语使用者贡献,音频均以16kHz单声道WAV格式存储,时长集中在1至15秒之间。转录文本采用纳斯塔里克体书写,平均每句包含10个词汇,反映了巴尔蒂语作为藏缅语系中极度匮乏资源语言的独特书写与发音特征。这一开源资源的诞生,不仅填补了巴尔蒂语在语音识别领域的空白,更为濒危语言的数字化保护与低资源语音技术研究奠定了基石。
使用方法
研究者可通过HuggingFace的datasets库便捷加载该数据集,使用load_dataset函数获取后,需调用cast_column方法将音频列转换为16kHz采样率的Audio格式以匹配模型输入。数据集以字典形式提供训练与验证两个子集,每条记录包含音频数组与对应的巴尔蒂语文本。此外,社区已基于该数据微调出Whisper-small模型,其词错误率从零样本时的182.18%显著降至30.07%,用户可直接利用Transformers库的pipeline接口部署该模型进行巴尔蒂语语音识别推理。
背景与挑战
背景概述
巴尔蒂语(Balti)是一种属于藏缅语系藏语支的濒危语言,主要分布在巴基斯坦吉尔吉特-巴尔蒂斯坦地区和印度拉达克地区,约40万使用者,但数字资源极度匮乏。2025年,独立研究者Mohammad Ali发布了BaltiVoice ASR数据集,这是首个公开可用的巴尔蒂语自动语音识别(ASR)数据集,旨在为这一低资源语言建立基础语音技术。数据集包含10,060条经过验证的语音样本,涵盖136位说话人,时长达16.8小时,并采用说话人不相交的分割策略以确保模型泛化能力。该数据集通过微调OpenAI Whisper模型,将零样本词错误率(WER)从182.18%降低至30.07%,显著提升了巴尔蒂语的语音识别性能,为低资源藏语支语言的自然语言处理(NLP)研究奠定了基础,并推动了濒危语言的数字化保存。
当前挑战
该数据集面临的核心挑战在于领域问题的复杂性:巴尔蒂语是极端低资源语言,缺乏标准化的拼写体系、数字语料库和语音处理工具,导致零样本ASR模型严重幻觉(WER超100%),且现有Whisper模型不支持其纳斯塔里克(Nastaliq)文字的直接分词。构建过程中,数据采集主要依赖志愿者贡献,录音质量参差不齐;词汇局限于朗读语音领域,缺乏自然对话样本,高噪音环境下的实际对话WER可能更高。此外,训练时使用乌尔都语(Urdu)分词器作为代理,未进行统一码规范化,阿拉伯语/波斯语的Yeh字符歧义可能影响评估准确性,且数据集规模仅16.8小时,不足以覆盖巴尔蒂语的方言和多样口音。
常用场景
经典使用场景
BaltiVoice ASR数据集作为首个公开的巴尔蒂语音识别资源,其最经典的用途在于训练和评估低资源语言的自动语音识别系统。研究者可以基于该数据集对预训练模型(如OpenAI Whisper)进行微调,从而构建针对巴尔蒂语的端到端语音转文字系统。数据集的训练集与验证集采用说话人不重叠的严格划分策略,确保了模型评估的泛化能力和可靠性,使其成为低资源Tibetic语系语音技术研究的基石。
衍生相关工作
该数据集衍生了一系列具有代表性的相关工作,最直接的是Mohammad Ali在其基础上微调的Whisper-small-Balti模型,显著降低了巴尔蒂语的词错误率。此外,数据集的构建方法——基于Mozilla Common Voice的说话人分离采样策略——为其他极端低资源语言的ASR数据集创建提供了可复现的基准。未来,该数据集有望催生针对巴尔蒂语的多模态研究、跨Tibetic语系的迁移学习,以及面向阿拉伯文字变体的语音处理创新工作。
数据集最近研究
最新研究方向
在低资源语言语音识别领域,BaltiVoice ASR数据集的发布标志着藏缅语族巴尔蒂语这一濒危语言首次拥有了公开的语音识别基准资源。该数据集通过收集136位发音人的约16.8小时音频,并利用OpenAI Whisper模型进行微调,实现了词错误率从零样本的182.18%大幅降低至30.07%的突破性进展。这一成果不仅为吉尔吉特-巴尔蒂斯坦地区约40万巴尔蒂语使用者打开了语音技术应用的大门,更填补了该语言在自然语言处理工具链中的关键空白。研究还揭示了低资源场景下语音识别系统面临的独特挑战——零样本测试中超过100%的错误率表明模型出现了严重幻觉现象,而通过领域内微调可显著缓解这一问题。该数据集的开源特性为后续的巴尔蒂语文本转语音、命名实体识别及机器翻译系统的构建奠定了坚实基础,同时也为其他藏缅语族濒危语言的数字化保护提供了可复现的方法论参考。
以上内容由遇见数据集搜集并总结生成


