fineproofs-prm-context-v2-cot-pbudget-xprob
收藏资源简介:
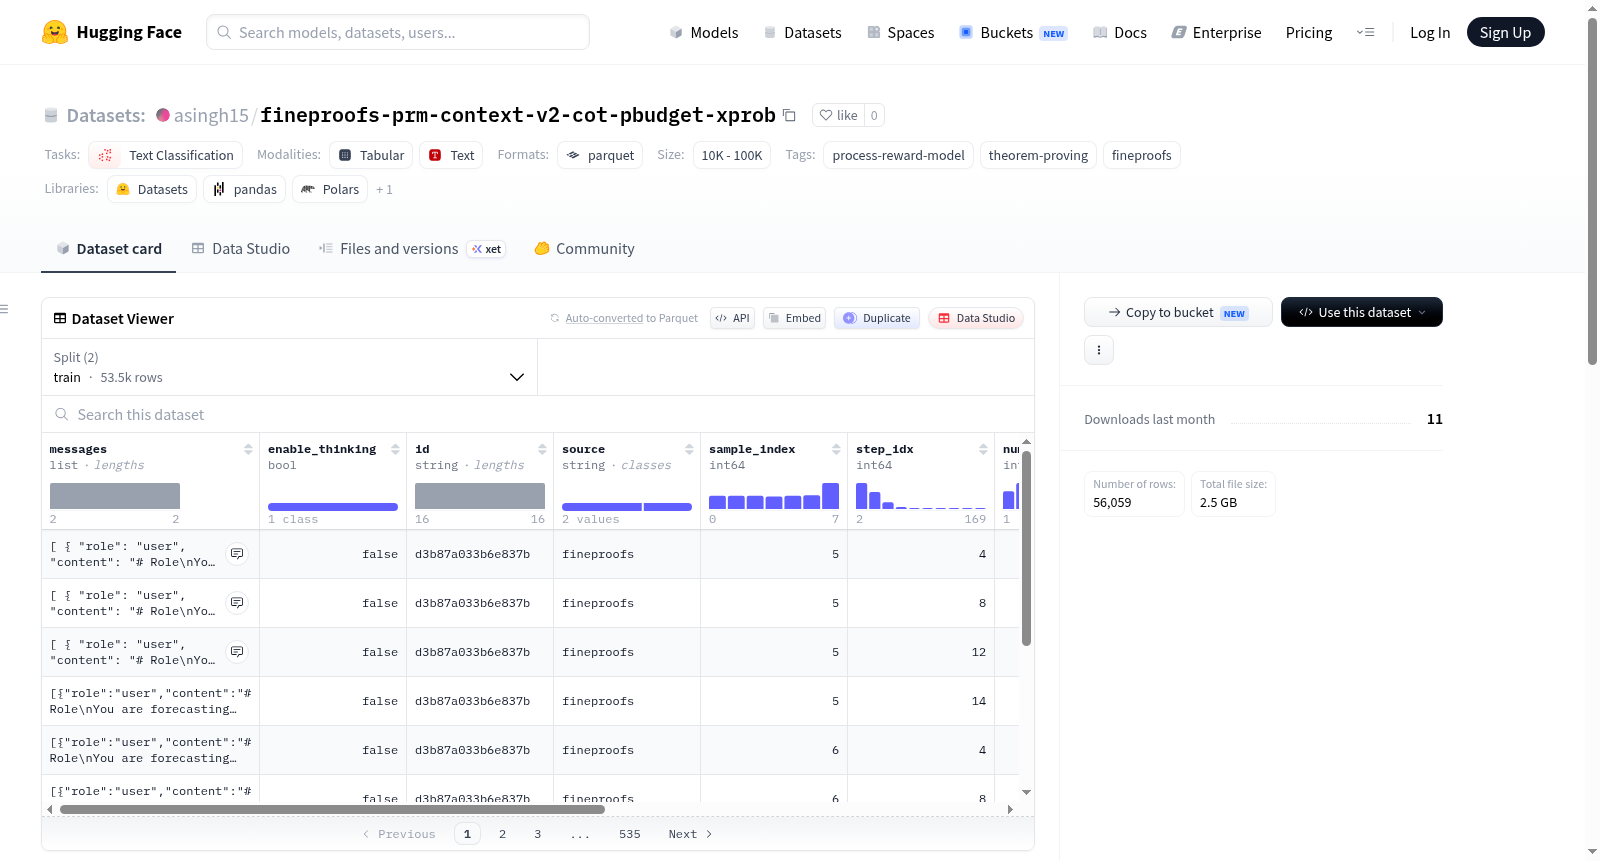
FineProofs PRM Context v2: Cot Pbudget Xprob 是一个用于过程奖励模型(Process Reward Model)训练与评估的数据集,属于 FineProofs 项目的一部分。该数据集采用 cot_pbudget 上下文模式,从 cross_problem 的 rollout 中构建,并使用 middle_truncated_reasoning_equal_share 打包策略。它是九个行匹配的上下文变体之一,所有变体共享相同的行键、标签、奖励值、训练/验证问题划分以及硬端点覆盖。数据集中 partial-prefix 和 complete-response 目标均基于规范化标准积分(由 clamped points 除以 max points 得到),而 correct 列仅作为 legacy 布尔投影(当 reward >= 0.5 时标记为正确),实际训练使用稠密的 reward 目标。数据集包含训练集和验证集:训练集有 53,457 行,涵盖 2,542 个问题;验证集有 2,602 行,涵盖 128 个问题。数据文件格式为 Parquet,并附带 provenance 和验证文件(dataset_provenance.json、verification.json、_SUCCESS.json)以确保数据来源和完整性。该数据集适用于定理证明中的过程奖励模型训练,特别是用于评估中间推理步骤的奖励信号。
FineProofs PRM Context v2: Cot Pbudget Xprob is a dataset for training and evaluating Process Reward Model (PRM), part of the FineProofs project. It uses the cot_pbudget context mode, constructed from cross_problem rollouts with middle_truncated_reasoning_equal_share packing strategy. It is one of nine row-matched context variants, all sharing the same row keys, labels, reward values, train/validation problem splits, and hard endpoint coverage. The partial-prefix and complete-response targets are based on normalized standard scores (clamped points divided by max points), while the correct column is a legacy boolean projection (correct when reward >= 0.5). Actual training uses the dense reward target. The dataset includes training set (53,457 rows, 2,542 problems) and validation set (2,602 rows, 128 problems). Data format is Parquet, with provenance and verification files (dataset_provenance.json, verification.json, _SUCCESS.json) ensuring data source and integrity. This dataset is suitable for training process reward models in theorem proving, especially for evaluating reward signals of intermediate reasoning steps.
FineProofs PRM Context v2: Cot Pbudget Xprob 数据集概述
基本信息
- 数据集名称: FineProofs PRM Context v2 - Cot Pbudget Xprob
- 任务类别: 文本分类(text-classification)
- 标签: 过程奖励模型(process-reward-model)、定理证明(theorem-proving)、FineProofs
- 数据文件格式: Parquet
数据构成
- 训练集: 53,457 行,覆盖 2,542 个问题
- 验证集: 2,602 行,覆盖 128 个问题
- 数据划分: 留出问题在划分和上下文选择之前被移除
数据生成背景
- 运行ID:
fineproofs_all_qwen35_9b_direct2phase_m32_20260730 - 采集模型:
Qwen/Qwen3.5-9B - 模型修订版本:
c202236235762e1c871ad0ccb60c8ee5ba337b9a - 上下文臂:
cot_pbudget_xprob - 上下文模式:
cot_pbudget - 上下文范围:
cross_problem - 上下文中的正确性标签: 否
- 验证SHA-256:
c5a3b92bd6196d4a33cded2c1a01870d1963d323351d573b369b7f97f3b7f648
数据特点
- 上下文类型为
cot_pbudget,来自cross_problem的 rollout,采用middle_truncated_reasoning_equal_share打包策略。 - 部分前缀和完整响应的目标均使用规范化 Rubric 信用(由钳制分数除以最大分数得出)。
correct列是仅基于 reward >= 0.5 的旧版布尔投影;训练使用密集的reward作为目标。- 该数据集是九个行匹配的上下文变体之一,基于已验证的 FineProofs rollout 集合构建。
- 九个变体具有相同的行键、标签、奖励、训练/验证问题划分和硬端点覆盖。
附带文件
本地 val.parquet 以 validation.parquet 形式发布。dataset_provenance.json、verification.json 和 _SUCCESS.json 包含实时输入的来源信息、跨臂检查和精确的已发布文件指纹。