
遇见数据集

vaibhavalakshmiravideshik/emapa-uberon-4k

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

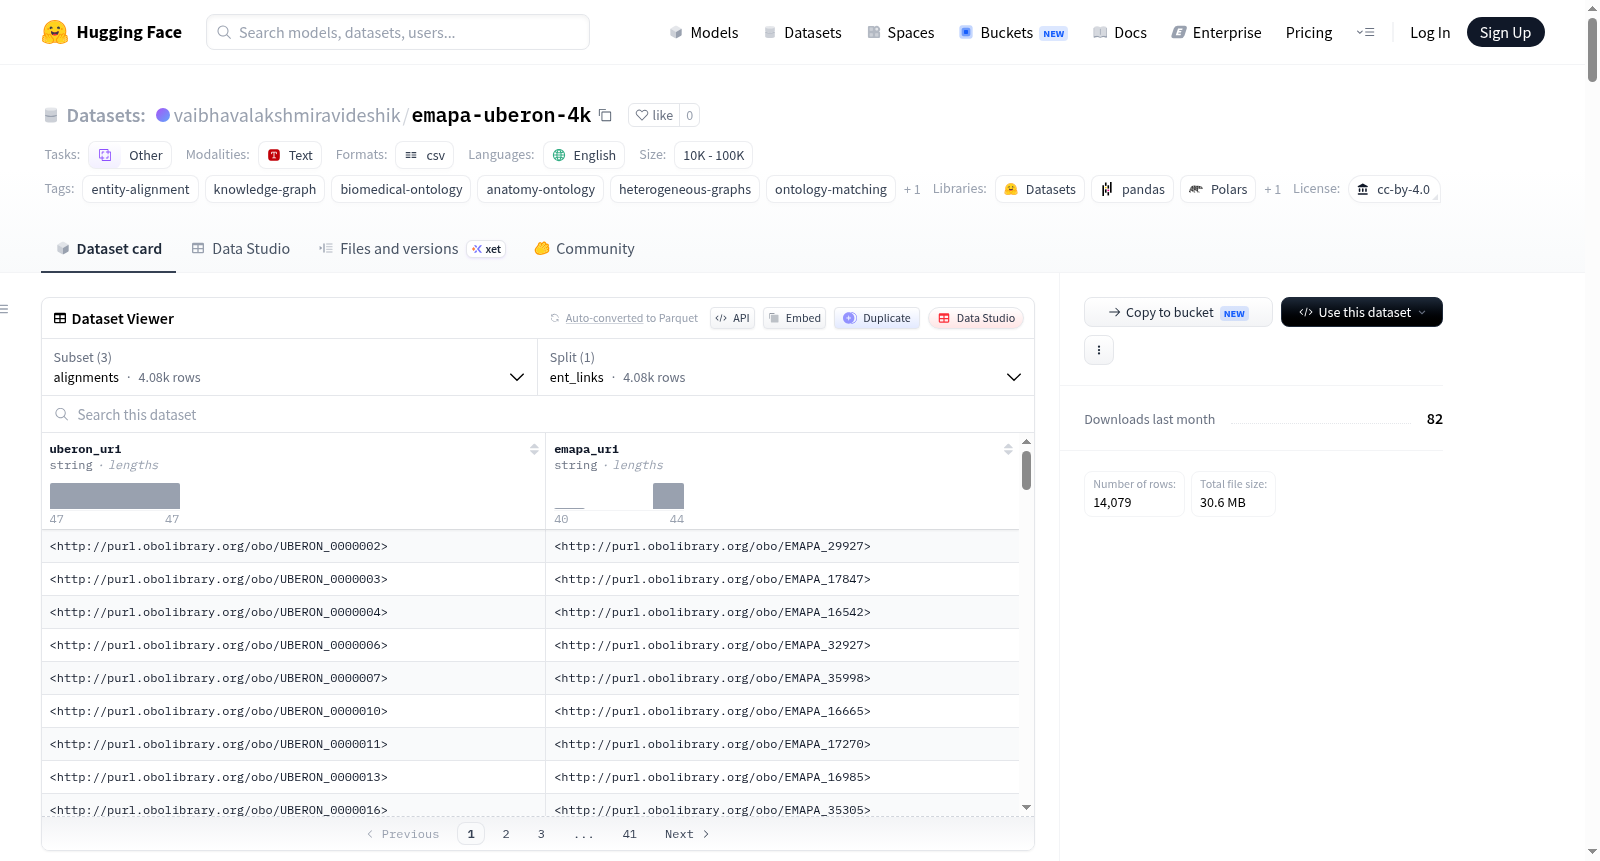
Uberon-EMAPA Entity Alignment 4K 是一个用于异构知识图谱的生物医学实体对齐基准数据集。该数据集对齐了 Uber-anatomy Ontology (Uberon) 和 Edinburgh Mouse Atlas Project Anatomy ontology (EMAPA) 两个解剖学本体之间的解剖实体,使用Uberon中直接嵌入的经过人工整理的交叉引用作为对齐依据。数据集包含4,079个经过验证的实体对齐对,旨在支持真实的实体对齐研究,而非简化的标签匹配。该基准将黄金对齐嵌入完整的Uberon和EMAPA本体图谱中,因此模型必须在存在物种不匹配、时间与非时间表示不匹配、模式不对称以及大量非黄金背景结构的情况下恢复对齐的解剖概念。数据集包括实体对齐文件(ent_links)、关系三元组文件(rel_triples_1和rel_triples_2)和属性三元组文件(attr_triples_1和attr_triples_2),总计约200,943行数据,27.37 MB。Uberon图谱包含14,971个实体,42,260个关系三元组和115,702个属性三元组;EMAPA图谱包含8,106个实体,28,299个关系三元组和9,603个属性三元组。数据集的异质性体现在模式不匹配、时间与非时间不匹配、物种不匹配、属性不对称以及背景比率高等方面。

Uberon-EMAPA Entity Alignment 4K is a biomedical entity alignment benchmark for heterogeneous knowledge graphs. It aligns anatomical entities between the Uber-anatomy Ontology (Uberon) and the Edinburgh Mouse Atlas Project Anatomy ontology (EMAPA) using curated cross-references embedded directly in Uberon. The benchmark contains 4,079 validated entity alignment pairs and is designed for realistic entity alignment research rather than simplified label matching. The gold alignment is embedded in the full Uberon and EMAPA ontology graphs, so models must recover aligned anatomical concepts in the presence of species mismatch, temporal-vs-atemporal representation mismatch, schema asymmetry, and substantial non-gold background structure. The dataset includes entity alignment files (ent_links), relation triple files (rel_triples_1 and rel_triples_2), and attribute triple files (attr_triples_1 and attr_triples_2), totaling approximately 200,943 lines and 27.37 MB. The Uberon graph contains 14,971 entities, 42,260 relation triples, and 115,702 attribute triples; the EMAPA graph contains 8,106 entities, 28,299 relation triples, and 9,603 attribute triples. The heterogeneity of the dataset is reflected in schema mismatch, temporal vs atemporal mismatch, species mismatch, attribute asymmetry, and high background ratio.
搜集汇总
数据集介绍
vaibhavalakshmiravideshik/emapa-uberon-4k 数据集图片
构建方式
该数据集的构建依托于Uberon本体中嵌入的策展交叉引用(curated cross-references),通过提取每个活跃的Uberon术语中标注为'xref: EMAPA:XXXXX'的单一对应关系,生成候选对齐对。随后执行严格的过滤流程:剔除拥有多个EMAPA交叉引用的Uberon术语(122个),移除在EMAPA本体中已废弃的术语(14个),最终获得4,079个经校验的高置信度黄金对齐对。知识图谱部分则分别从Uberon和EMAPA的完整OBO文件中解析所有活跃术语及其关系三元组与属性三元组,保留了丰富的背景结构信息。
特点
该数据集以高度异质性著称,集中体现了跨物种、跨时间尺度与跨模式的本体对齐挑战。Uberon涵盖多物种、偏成体解剖且拥有十余种关系类型,而EMAPA专精于小鼠发育解剖学,采用时间阶段标注与简化的关系词汇。两者在属性丰富度上也显著不对称:Uberon包含标签、定义、同义词及广泛交叉引用,EMAPA则仅有名称与同义词,缺乏文字定义。此外,仅有约27%的Uberon实体和50%的EMAPA实体参与黄金对齐,背景噪声比例高,使得基于简单标签匹配的模型难以奏效。
使用方法
数据集以制表符分隔的UTF-8纯文本文件形式提供,用户可直接加载'ent_links'文件获取4,079对黄金对齐实体URI。通过解析'rel_triples_1'与'rel_triples_2'中的关系三元组,以及'attr_triples_1'与'attr_triples_2'中的属性三元组,可分别构建Uberon和EMAPA两个异构知识图谱。推荐用于异质性生物医学实体对齐、解剖学本体匹配、跨物种语义对齐研究以及多模态或结构加文本的实体对齐系统评估。Hugging Face数据集查看器中的辅助文件仅用于兼容性预览,不影响基准测试的原始文件结构。
背景与挑战
背景概述
在生物医学本体工程领域,跨物种解剖学知识的整合是精准医学与比较生物学研究的重要基石。由研究者Vaibhavalakshmi Ravideshik于2026年构建的Uberon-EMAPA Entity Alignment 4K基准数据集,聚焦于多物种解剖本体Uberon与小鼠发育解剖本体EMAPA之间的实体对齐任务。该数据集依托Monarch Initiative与OBO Foundry社区维护的权威本体资源,通过提取Uberon中嵌入的4,079个经审校的交叉引用对,构建了首个面向真实异构知识图谱的解剖实体对齐基准。其核心研究问题在于克服跨物种、跨时间表征及模式不对称带来的对齐挑战,为生物医学知识图谱融合提供了关键的评估平台,推动了异质性本体匹配方法的发展。
当前挑战
该数据集所解决的领域挑战在于跨物种解剖概念的语义对齐,尤其是Uberon的跨物种、无时间维度表征与EMAPA的小鼠特异性发育分期刻画之间的根本性冲突,导致模式图谱在关系类型(Uberon含10余种 vs EMAPA仅4种)、属性丰富度(Uberon含详细定义 vs EMAPA无定义)及背景噪声比例(仅27%-50%实体参与对齐)上存在显著不对称。构建过程中,面对122个一对多交叉引用及14个已废弃EMAPA术语的过滤难题,通过严格的单对一验证策略保证了金标准质量;同时,需完整保留非对齐背景实体以模拟真实场景,避免简化标签匹配的陷阱,使模型必须在物种、时间与模式三重异质性下恢复对齐关系。
常用场景
经典使用场景
在生物医学本体对齐领域,实体对齐任务旨在发现不同知识图谱中代表同一现实世界概念的实体对。Uberon-EMAPA Entity Alignment 4K数据集为这一任务提供了一个极具挑战性的基准,它专注于跨物种解剖学本体的对齐,要求模型能够将多物种解剖本体Uberon中的解剖结构与小鼠发育解剖本体EMAPA中的对应结构进行精确匹配。这一场景的经典之处在于,它超越了传统基于标签匹配的简化设定,迫使研究者在面对物种不匹配、时间与无时间表征差异、模式不对称以及大量非对齐背景结构等复杂异构因素时,依然能够设计出鲁棒的对齐方法。该数据集包含4079个经过精心验证的金标准对齐对,并提供了完整的图谱结构,是评估实体对齐模型在真实生物医学语境下泛化能力的理想平台。
衍生相关工作
该数据集的发布催生了一系列围绕异构知识图谱实体对齐的经典工作。许多研究者将其作为评估基准,探索如何利用图神经网络(GNN)的聚合能力处理模式不对称问题,例如设计能够同时建模时序关系(如EMAPA的starts_at/ends_at)和静态层次关系(如Uberon的subClassOf/part_of)的异构图联合学习框架。另一类衍生工作聚焦于属性不对称下的对齐策略,开发了基于语义嵌入的增强方法,利用Uberon丰富的文本定义和跨库引用信息来补偿EMAPA缺乏定义的劣势。此外,该数据集还激发了关于少量样本对齐(few-shot alignment)和零样本对齐(zero-shot alignment)的探索,因为其金标准对齐对仅覆盖部分实体,促使模型在有限监督下利用图谱拓扑结构进行泛化。这些衍生研究共同推动了生物医学本体对齐从理想化设定向真实场景的演进,并为后续构建更全面的跨物种解剖知识图谱提供了方法论启示。
数据集最近研究
最新研究方向
该数据集聚焦于异构知识图谱间的生物医学实体对齐研究,尤其是在跨物种与跨发育阶段的解剖本体匹配领域。emapa-uberon-4k的发布填补了现有基准测试在真实异质性场景下的空白——其巧妙融合了物种特异性(鼠类仅见于EMAPA)与多物种整合(Uberon涵盖后生动物)、时间性(EMAPA包含发育阶段关系)与非时间性表征(Uberon及更宽泛)的多重语义鸿沟,为评估实体对齐方法对模式不对称、属性稀疏性及大规模背景噪声的鲁棒性提供了标杆。这一基准正推动领域前沿从简化标注匹配转向应对生物医学本体深度融合中的本质挑战,如物种演化、发育时序与结构粒度差异,对精准医学跨物种知识迁移与变异表型推理具有重要奠基意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

