
专利审查分析数据集
收藏官方服务:
资源简介:
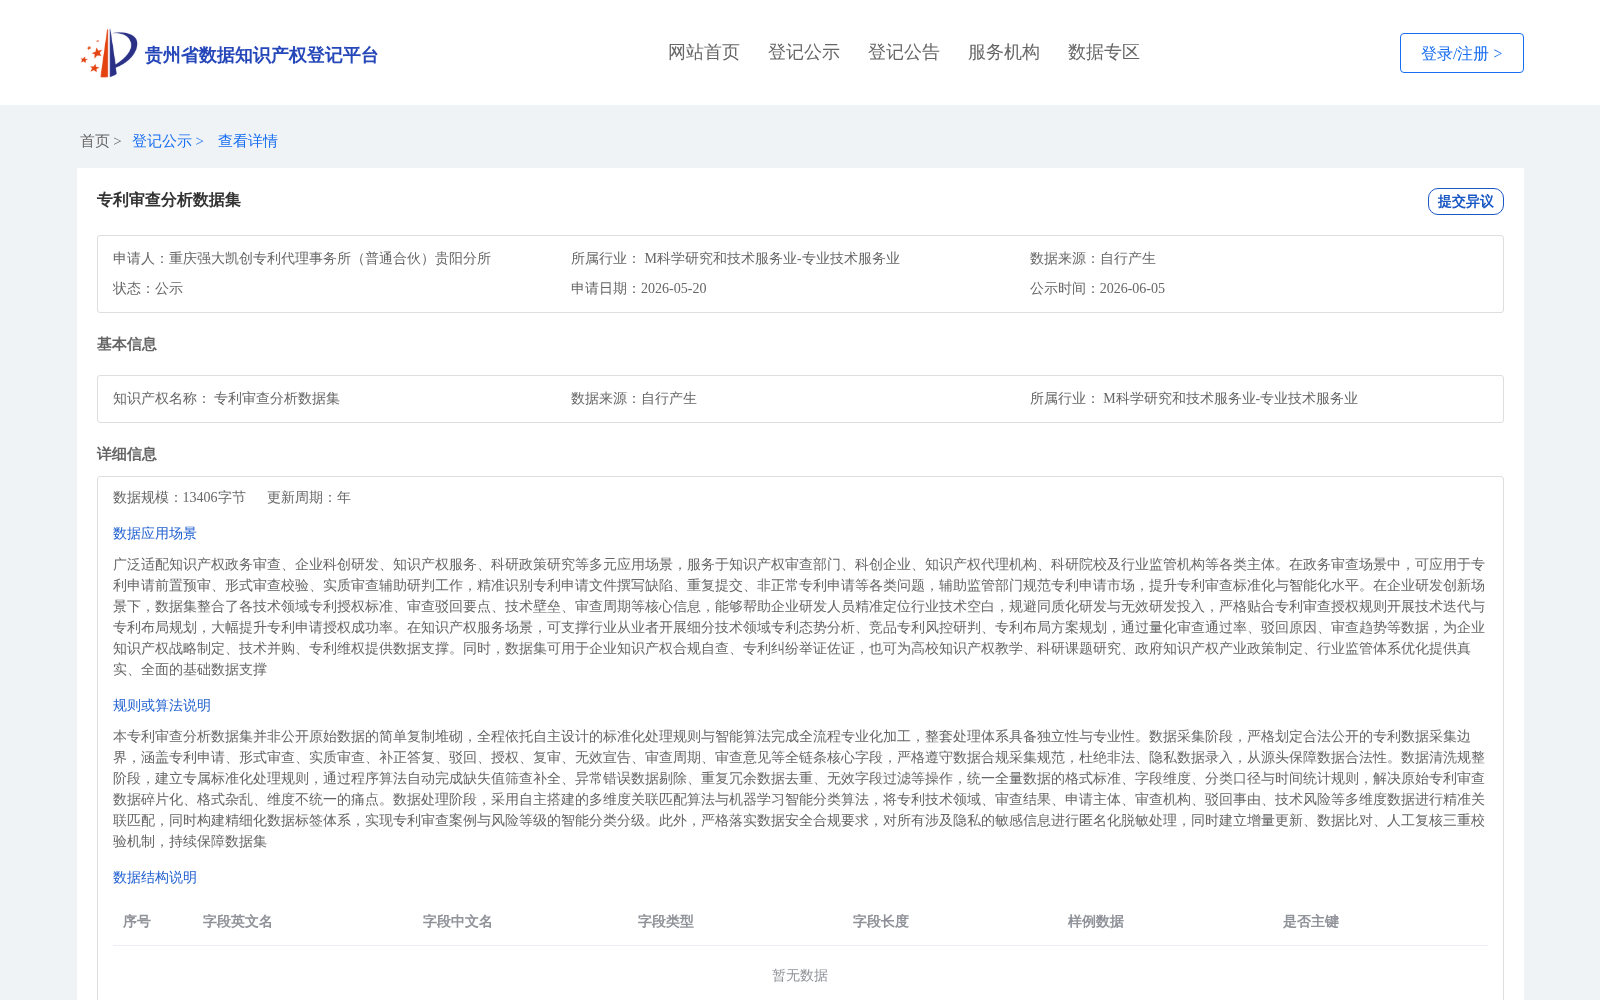
本专利审查分析数据集并非公开原始数据的简单复制堆砌,全程依托自主设计的标准化处理规则与智能算法完成全流程专业化加工,整套处理体系具备独立性与专业性。数据采集阶段,严格划定合法公开的专利数据采集边界,涵盖专利申请、形式审查、实质审查、补正答复、驳回、授权、复审、无效宣告、审查周期、审查意见等全链条核心字段,严格遵守数据合规采集规范,杜绝非法、隐私数据录入,从源头保障数据合法性。数据清洗规整阶段,建立专属标准化处理规则,通过程序算法自动完成缺失值筛查补全、异常错误数据剔除、重复冗余数据去重、无效字段过滤等操作,统一全量数据的格式标准、字段维度、分类口径与时间统计规则,解决原始专利审查数据碎片化、格式杂乱、维度不统一的痛点。数据处理阶段,采用自主搭建的多维度关联匹配算法与机器学习智能分类算法,将专利技术领域、审查结果、申请主体、审查机构、驳回事由、技术风险等多维度数据进行精准关联匹配,同时构建精细化数据标签体系,实现专利审查案例与风险等级的智能分类分级。此外,严格落实数据安全合规要求,对所有涉及隐私的敏感信息进行匿名化脱敏处理,同时建立增量更新、数据比对、人工复核三重校验机制,持续保障数据集
创建时间:
2026-05-20
搜集汇总
数据集介绍
背景与挑战
背景概述
本专利审查分析数据集通过自主设计的标准化处理规则与智能算法,对专利审查全链条核心字段进行采集、清洗与多维度关联匹配,实现了专利审查案例与风险等级的智能分类分级。数据集涵盖专利申请至无效宣告等关键环节,并对敏感信息进行匿名化脱敏处理,建立了增量更新与人工复核机制。该数据集广泛适用于政务审查、企业研发、知识产权服务及科研政策研究等场景,旨在提升专利审查的标准化与智能化水平。
以上内容由遇见数据集搜集并总结生成


