biomed-aqa-dataset
收藏资源简介:
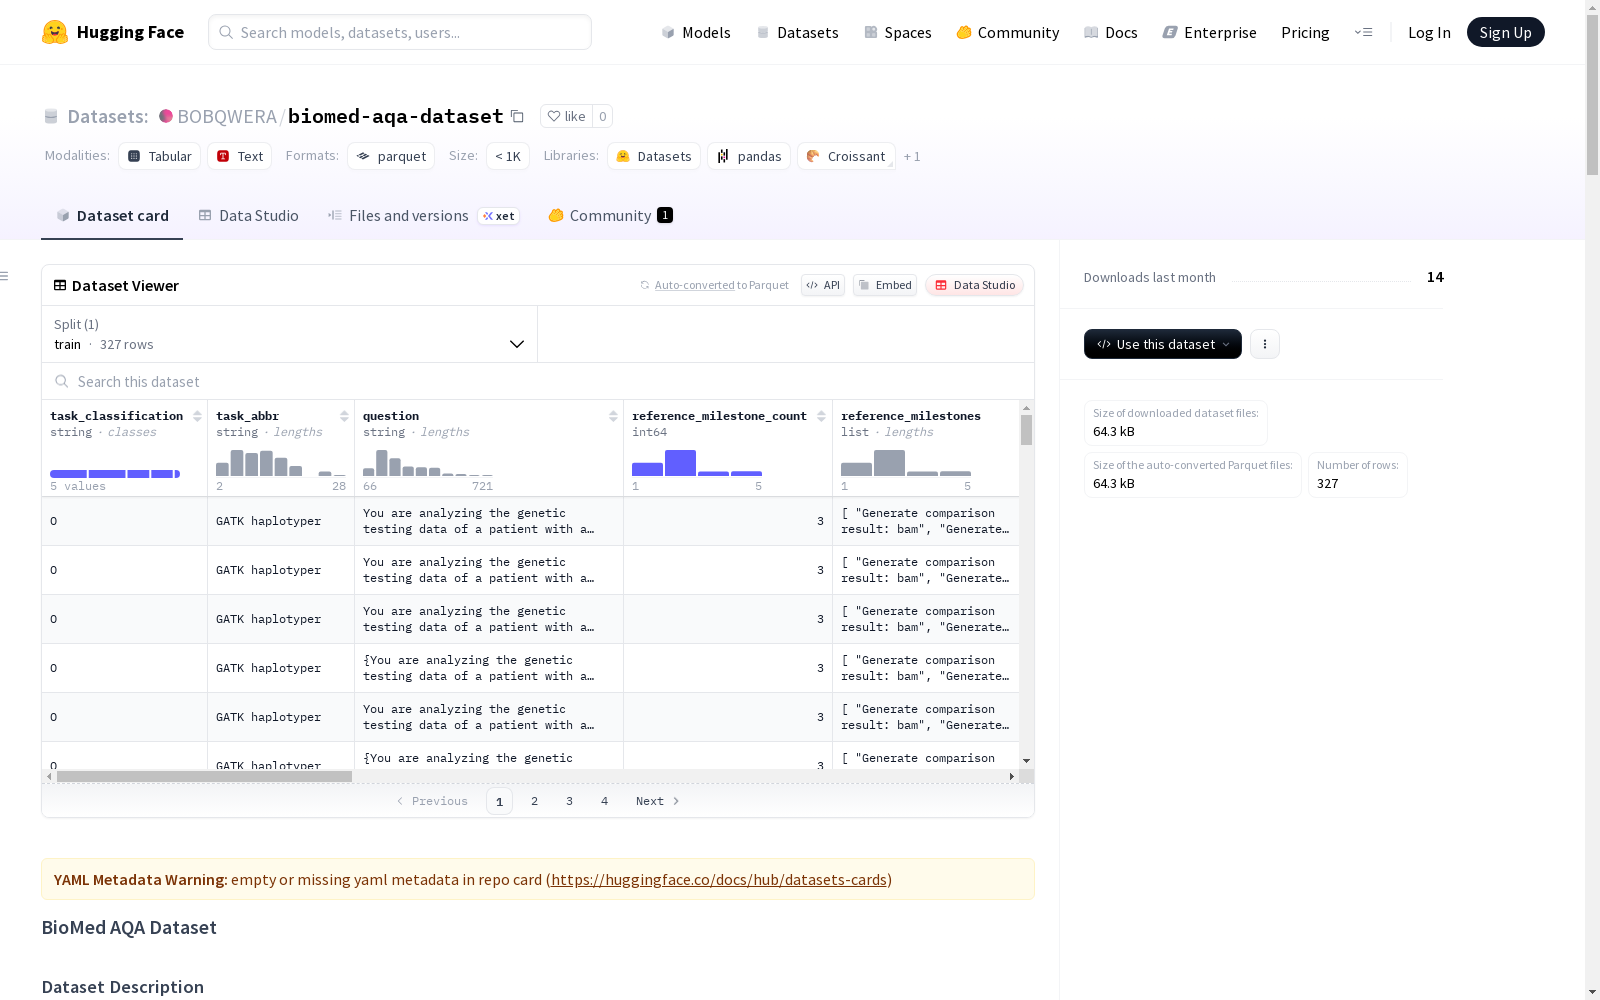
BioMed AQA数据集包含327个生物医学分析问题和任务,涉及基因组学、转录组学等多种生物信息学工作流程。数据集中的每个记录都包括任务类型、任务简称、问题描述、参考里程碑和步骤等详细信息。该数据集适用于生物医学领域的分析和研究。
The BioMed AQA Dataset consists of 327 biomedical analytical questions and tasks, covering a wide range of bioinformatics workflows including genomics, transcriptomics and other related fields. Each record in the dataset contains detailed information such as task type, task abbreviation, problem description, reference milestones and implementation steps. This dataset is suitable for analysis and research within the biomedical field.
BioMed AQA 数据集概述
数据集描述
该数据集包含327个生物医学分析问题和任务,涵盖各种生物信息学工作流程,包括基因组学、转录组学和其他分子生物学数据分析任务。
数据集结构
数据字段
每个记录包含以下字段:
task_classification:任务类型分类task_abbr:任务缩写名称question:主要问题或任务描述reference_milestone_count:参考里程碑数量reference_milestones:里程碑描述列表reference_step_count:参考步骤数量reference_steps:步骤描述列表milestone_reference_files:里程碑参考文件列表task_subclass:任务子类dataset:数据集标识符question_type:问题类型test:测试标识符files:任务所需的输入文件列表order:顺序标识符task:任务类别index:记录索引
数据集统计
- 总记录数:327
- 总文件数:1,028个文件(约30 GB)
任务分类分布
- O(组学分析):96条记录
- V(可视化):96条记录
- M(机器学习):59条记录
- S(统计):58条记录
- P(蛋白质分析):18条记录
任务子类分布
- RNA:42条记录
- 推断统计:38条记录
- DNA:36条记录
- 基础绘图:26条记录
- 拟合与推断:23条记录
- 描述性统计:20条记录
- scRNA:18条记录
- Upset:18条记录
- 分类:16条记录
- 回归:14条记录
- 聚类:13条记录
- 肿瘤:12条记录
- 生存分析:12条记录
- 特征选择:10条记录
- 遗传:6条记录
- 深度学习:6条记录
- 其他:17条记录
问题类型分布
- 清晰问题:202条记录
- 开放问题:125条记录
数据文件
数据集引用了位于downloaded_files目录中的文件集合,包括:
- FASTQ文件:283个 - 原始测序数据
- TSV文件:276个 - 表格数据
- GZ压缩文件:132个 - 压缩数据文件
- BAM文件:比对序列数据
- VCF文件:变异调用格式文件
- MAF文件:突变注释格式文件
- CSV文件:逗号分隔值文件
- 其他生物信息学文件格式
总计:1,028个文件,约31.1 GB
数据下载
数据文件存档并可从Zenodo下载:
DOI:https://doi.org/10.5281/zenodo.17430550
数据集分为30个卷存档以便下载和管理。
下载选项
选项1:下载所有文件(推荐完整数据集) bash wget https://zenodo.org/api/records/17430550/files-archive -O biomedical_dataset_all.zip
选项2:下载单个卷 每个卷独立包含数据集的子集文件夹,完整列表请访问:https://doi.org/10.5281/zenodo.17430550
提取说明
下载后提取存档文件,所有卷将提取到包含index_0001到index_0327文件夹的downloaded_files/目录。
使用方法
python import json from datasets import Dataset
加载数据集
with open(biomed_aqa_hf_dataset.json, r, encoding=utf-8) as f: data = json.load(f)
转换为HuggingFace数据集
dataset = Dataset.from_list(data)
访问样本
sample = dataset[0] print(f"Question: {sample[question]}") print(f"Task: {sample[task]}") print(f"Files: {sample[files]}")