
遇见数据集

Shaer-AI/shaer-sft-test-generations-k5-meter-count

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

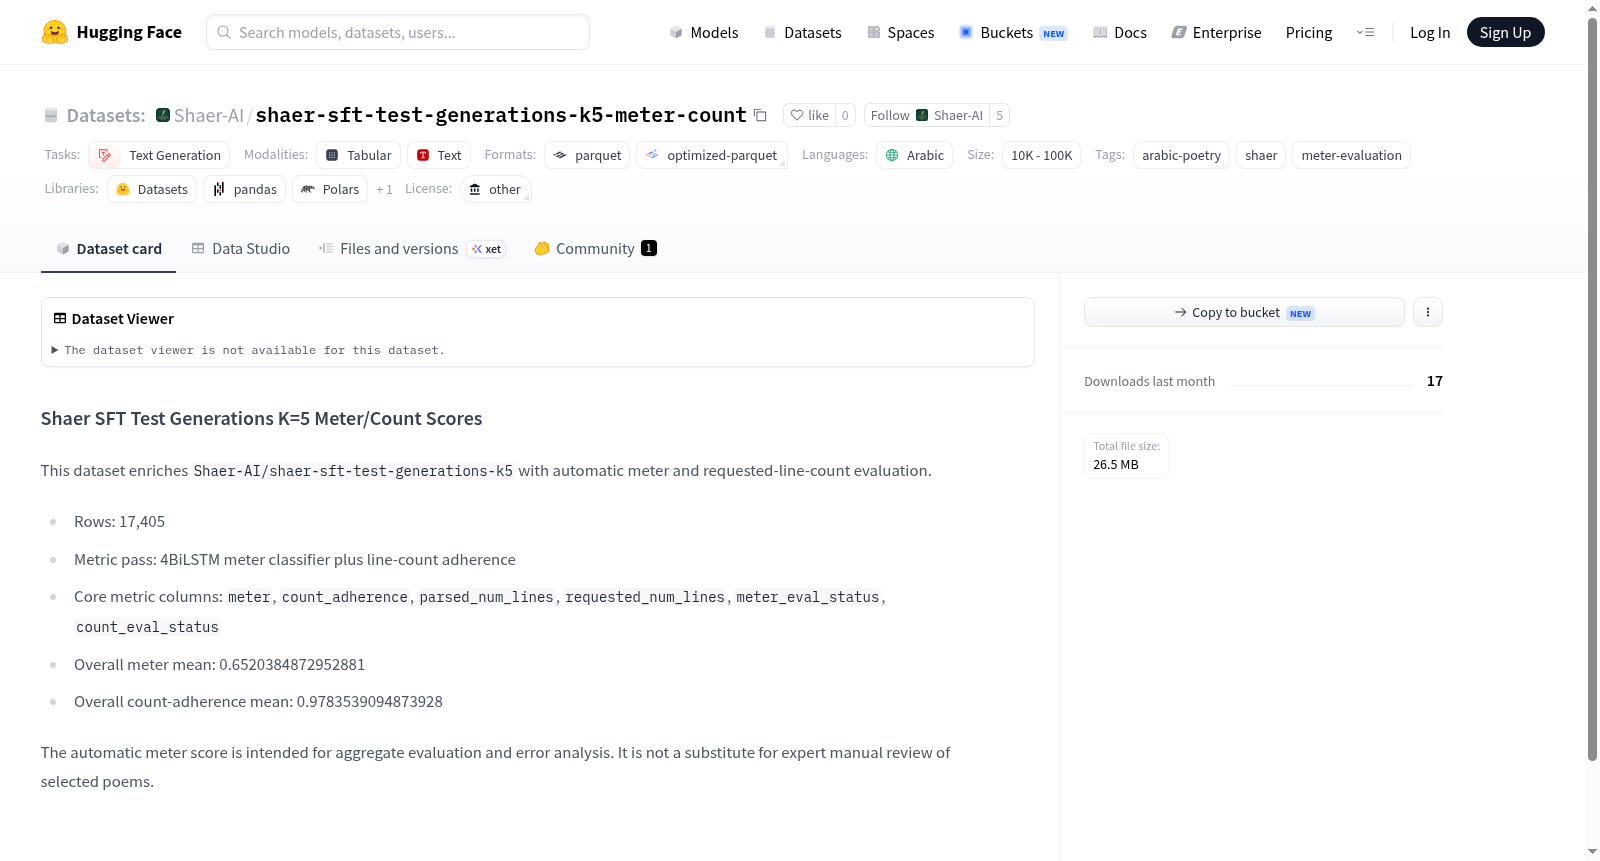
该数据集名为Shaer SFT Test Generations K=5 Meter/Count Scores,是基于Shaer-AI/shaer-sft-test-generations-k5数据集增强而来的,专门添加了自动韵律和请求行数评估功能。数据集包含17,405行数据,使用4BiLSTM韵律分类器和行数依从性进行度量评估,核心指标列包括meter(韵律)、count_adherence(行数依从性)、parsed_num_lines(解析行数)、requested_num_lines(请求行数)、meter_eval_status(韵律评估状态)和count_eval_status(行数评估状态)。整体韵律平均值为0.6520384872952881,行数依从性平均值为0.9783539094873928。自动韵律评分主要用于聚合评估和错误分析,不能替代专家对选定诗歌的手动审查。数据集涉及阿拉伯语诗歌(Arabic poetry)和韵律评估(meter evaluation),任务类别为文本生成(text-generation)。

This dataset, titled Shaer SFT Test Generations K=5 Meter/Count Scores, enriches the Shaer-AI/shaer-sft-test-generations-k5 dataset by adding automatic meter and requested-line-count evaluation. It contains 17,405 rows and uses a 4BiLSTM meter classifier plus line-count adherence for metric evaluation. Core metric columns include meter, count_adherence, parsed_num_lines, requested_num_lines, meter_eval_status, and count_eval_status. The overall meter mean is 0.6520384872952881, and the overall count-adherence mean is 0.9783539094873928. The automatic meter score is intended for aggregate evaluation and error analysis and is not a substitute for expert manual review of selected poems. The dataset is related to Arabic poetry and meter evaluation, with task categories in text-generation.
提供机构:
Shaer-AI
搜集汇总
数据集介绍
Shaer-AI/shaer-sft-test-generations-k5-meter-count 数据集图片
构建方式
本数据集以Shaer-AI/shaer-sft-test-generations-k5为基础,通过引入自动化的韵律评估与行数合规性检测机制进行构建。具体而言,采用4BiLSTM韵律分类器对生成的阿拉伯诗歌逐句进行韵律分析,同时结合请求行数与实际解析行数的比对,计算行数合规性得分。每条样本均包含韵律标签、合规性指标、解析行数及请求行数等核心字段,最终形成包含17405条记录的高质量评估集合。
使用方法
该数据集主要用于阿拉伯诗歌生成模型的自动化评估与误差分析。研究者可加载数据集后,直接访问'meter'与'count_adherence'等核心指标列,计算模型的整体韵律与行数表现。更深入的分析可通过筛选'meter_eval_status'与'count_eval_status'列中的失败样本进行,定位生成质量瓶颈。需注意,自动化评分适用于批量评估与趋势分析,不替代专家对精选诗歌的人工审校。
背景与挑战
背景概述
阿拉伯诗歌作为阿拉伯文化遗产的瑰宝,其格律分析一直是自然语言处理领域的难点。Shaer-SFT-Test-Generations-K5-Meter-Count数据集由Shaer-AI团队于近期创建,旨在为阿拉伯诗歌生成模型提供自动化的格律与行数评估标准。该数据集基于SFT测试生成结果,引入4BiLSTM格律分类器与行数一致性检验,推出meter与count_adherence等核心指标,弥补了阿拉伯诗歌质量自动评估领域的空白。凭借17,405条样本与明确的评分框架,该数据集为研究阿拉伯诗歌生成模型提供了系统性的量化分析工具,推动了相关研究的标准化进程。
当前挑战
该数据集面临的挑战涵盖多个层面。在领域问题层面,阿拉伯诗歌格律规则复杂多样,传统上依赖于专家人工鉴定,缺乏高效的自动评估手段,数据集旨在解决这一评估瓶颈,但其自身依赖的4BiLSTM分类器无法完全取代人工审校,存在误判风险。在构建过程中,团队需处理诗歌生成可能出现的格律偏离与行数不匹配问题,确保评估指标既能捕捉模型表现又不过度简化评测标准。如何平衡自动评估的规模化优势与专家验证的准确性,成为数据集持续演进的核心难题。
常用场景
经典使用场景
在阿拉伯诗歌的数字化研究中,韵律与格律的自动评估一直是自然语言处理领域的核心挑战。shaer-sft-test-generations-k5-meter-count数据集专为评估大语言模型在诗歌生成任务中的韵律合规性而设计,其经典用途在于衡量模型输出诗句的格律正确性与行数匹配度。通过整合4BiLSTM韵律分类器与行数一致性审查,该数据集提供了一个自动化的综合评价框架,尤其适用于对诗歌生成模型进行批量测试与错误分析,成为AI诗歌创作评估的标准基准之一。
解决学术问题
该数据集精准回应了阿拉伯诗歌生成研究中两个长期存在的学术难题:一是如何客观量化生成诗歌的韵律质量,二是如何确保输出格式与指令一致性。传统依赖人工评审的方法成本高昂且主观性强,而该数据集通过引入自动格律评分与行数跟随率指标,使得模型在韵律保持和计数约束方面的表现得以大规模、可重复地评估。这一突破为诗歌生成模型的系统性对比与迭代优化奠定了方法论基础,推动了计算诗学从定性分析向定量评估的范式转型。
实际应用
在实际应用中,该数据集主要服务于阿拉伯语诗歌智能创作系统的质量监控环节。开发者可利用其提供的格律与行数评估指标,快速筛选出韵律失范或格式异常的生成结果,从而优化模型的微调策略。此外,该数据集也适用于教育领域中的诗歌教学辅助工具,通过自动检测学生习作或AI辅助创作作品中的韵律错误,帮助学习者掌握古典诗歌的格律规则,提升创作规范性与艺术表现力。
数据集最近研究
最新研究方向
该数据集聚焦于阿拉伯诗歌的格律与行数自动评估,为诗歌生成模型的精细化评测提供了关键基准。在当前自然语言处理向低资源语言与复杂文化形态纵深发展的背景下,研究者借助4BiLSTM格律分类器与行数合规性检验,构建了涵盖逾1.7万样本的测试集,使得机器生成的诗歌在韵律结构上的自动纠偏与质量监控成为可能。这一方向呼应了阿拉伯诗歌数字化保护与智能创作工具研发的热点,其公布的格律通过率(0.65)与行数符合率(0.98)为后续模型优化提供了重要量化锚点,推动了生成式诗歌评测从定性走向定量分析的范式演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

