nemotron-terminal-data_querying
收藏资源简介:
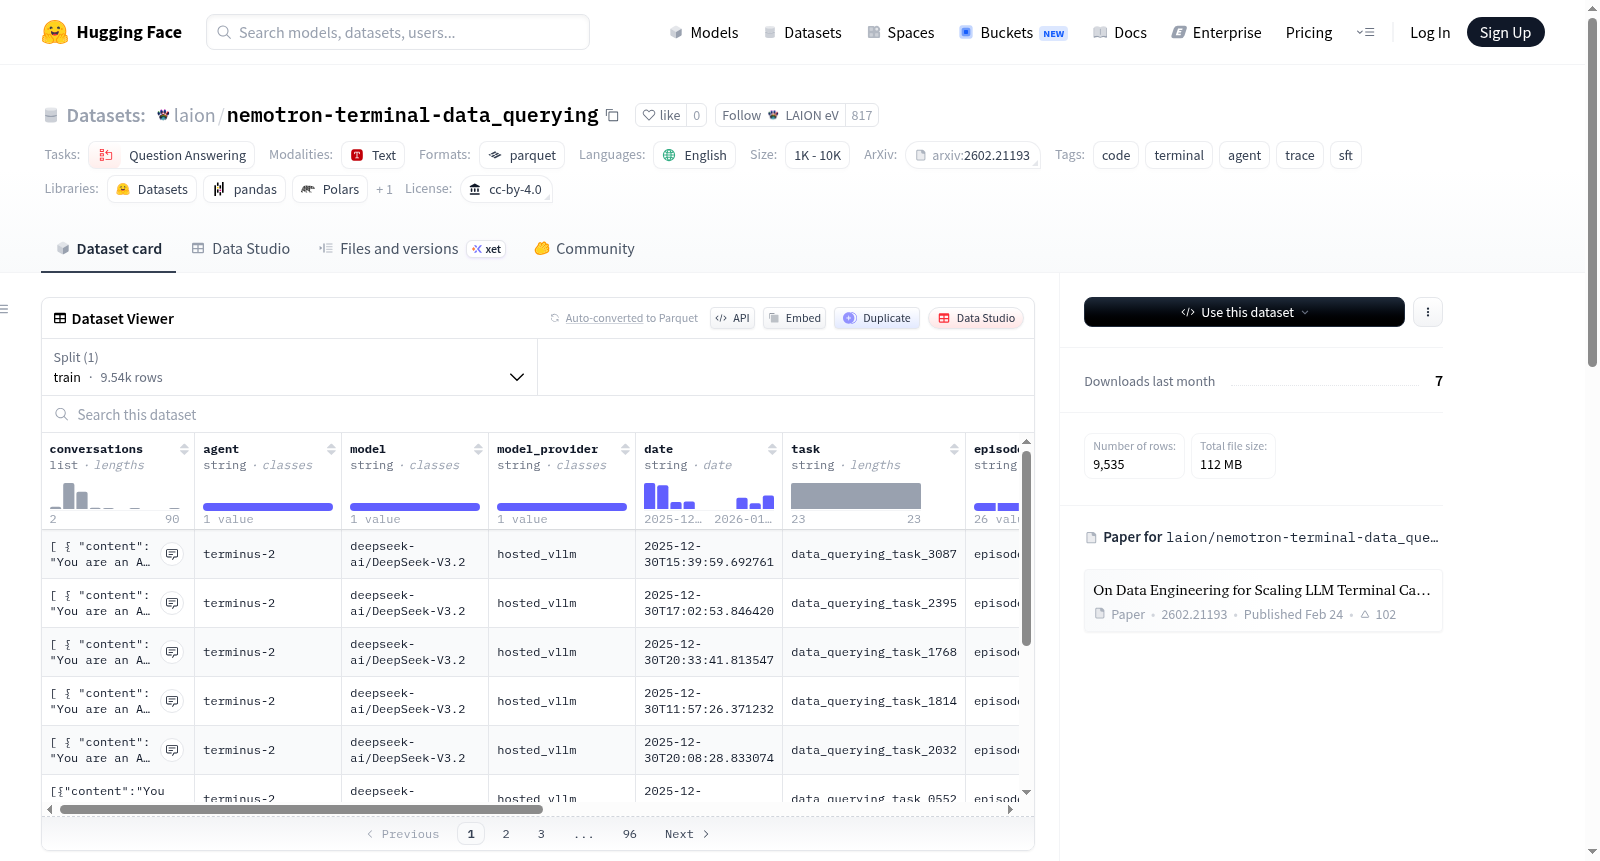
nemotron-terminal-data_querying 数据集是 nvidia/Nemotron-Terminal-Corpus 数据集的一个过滤子集,专注于数据查询任务。该数据集适用于问答任务,涉及代码、终端、代理、跟踪和 sft 等领域。数据集包含多个列,如 'conversations'、'agent'、'model'、'model_provider'、'date'、'task'、'episode'、'run_id'、'trial_name' 和 'enable_thinking',以及额外的列 'source'、'difficulty' 和 'original_source'。数据集按照 'adapters_{code,math,swe}' 和各种技能类别(如 'debugging'、'security' 等)进行分区。难度级别分为 'easy'、'medium'、'mixed' 和 'na'。数据集采用 CC-BY-4.0 许可证,并提供了相关的引用信息。
nemotron-terminal-data_querying 数据集概述
数据集基本信息
- 数据集名称: nemotron-terminal-data_querying
- 许可协议: CC-BY-4.0
- 主要任务类别: 问答
- 主要语言: 英语
- 标签: 代码、终端、智能体、轨迹、监督微调
数据集来源与构成
- 本数据集是
nvidia/Nemotron-Terminal-Corpus数据集的一个按来源划分的子集。 - 数据经过筛选,仅保留
source == "data_querying"的数据行。 difficulty列保留了原始的难度划分(easy/medium/mixed),对于来自dataset_adapters/*文件的数据,其难度标签为na。
分区方案
- adapters_{code,math,swe}: 数据行来自
dataset_adapters/{code,math,swe}.parquet。 - {skill} (例如
debugging,security, …): 数据行来自synthetic_tasks/skill_based/{easy,medium,mixed}/{skill}/data_filtered.parquet。
数据列说明
包含源数据集的所有列:conversations, agent, model, model_provider, date, task, episode, run_id, trial_name, enable_thinking。
额外包含以下列:
source: 分区键,在本数据集中始终为"data_querying"。difficulty: 难度等级,取值为easy/medium/mixed/na。original_source: 仅存在于adapters_code分区中,用于保留上游文件中原始的source列值(OpenCodeReasoning或synthetic)。
引用信息
如需引用,请使用以下 BibTeX 条目: bibtex @misc{pi2026dataengineeringscalingllm, title={On Data Engineering for Scaling LLM Terminal Capabilities}, author={Renjie Pi and Grace Lam and Mohammad Shoeybi and Pooya Jannaty and Bryan Catanzaro and Wei Ping}, year={2026}, eprint={2602.21193}, archivePrefix={arXiv}, primaryClass={cs.CL}, url={https://arxiv.org/abs/2602.21193}, }
原始数据集许可
CC-BY-4.0。