dev_set_v2_a3_rl_laion_nemotron_gym_identity_following_v2_65_8B_20260825_162529
收藏资源简介:
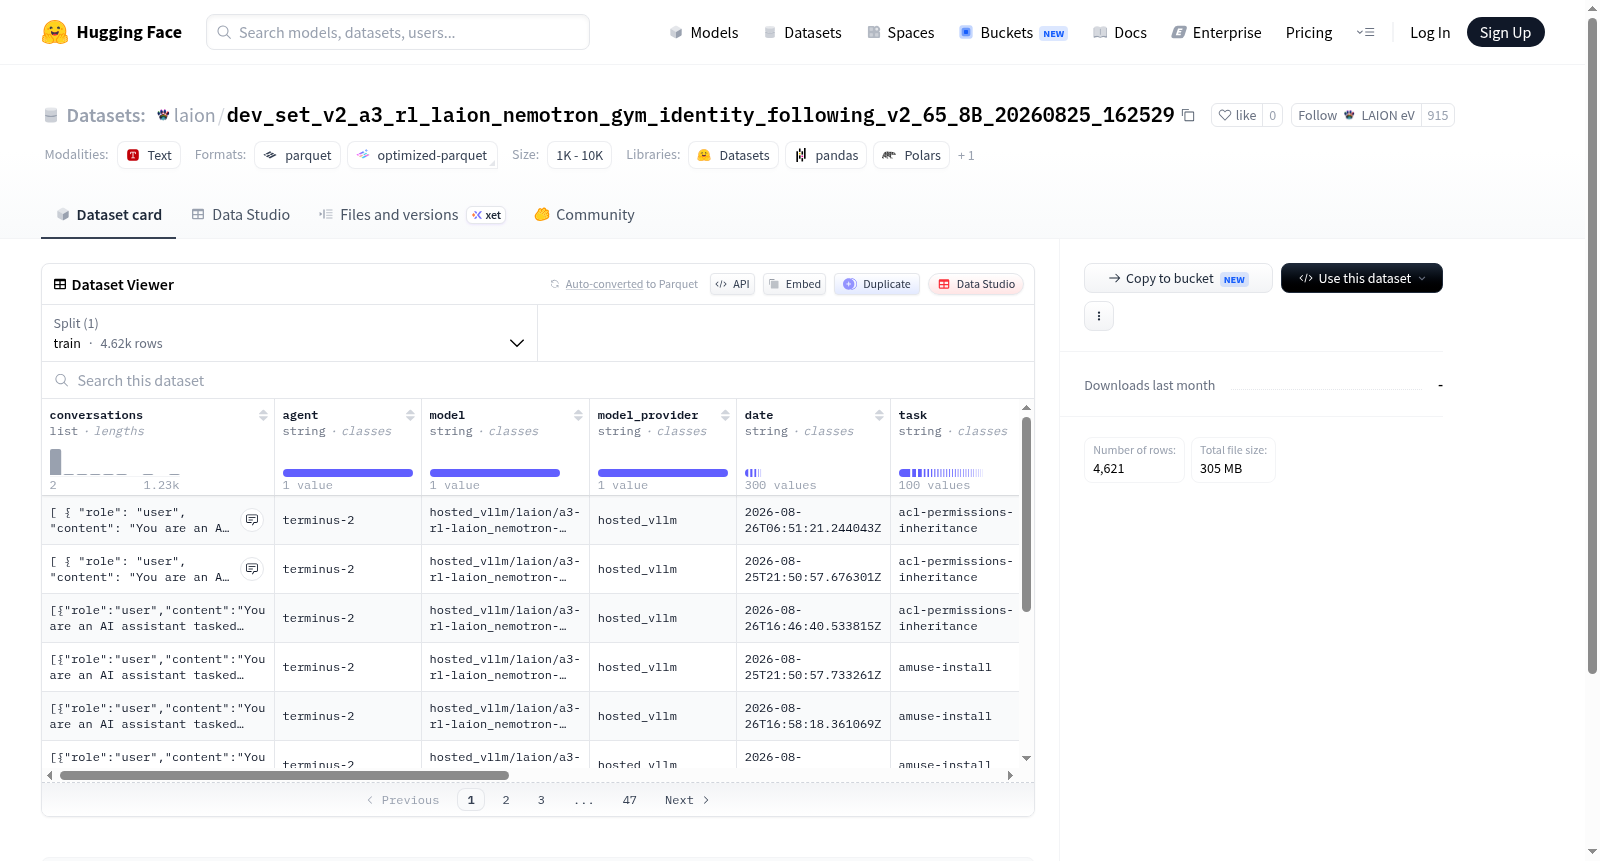
该数据集由多个字段组成,包括对话记录(conversations,包含角色和内容)、智能体名称(agent)、模型名称(model)、模型提供方(model_provider)、日期(date)、任务(task)、回合(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及追踪来源(trace_source)。训练集包含4621个样本,总数据集大小约为335MB。
This dataset consists of multiple fields, including conversations (with roles and content), agent name, model name, model provider, date, task, episode, run ID, trial name, result, verifier output, and trace source. The training set contains 4621 samples, and the total dataset size is approximately 335MB.
数据集概述
该数据集名为 laion/dev_set_v2_a3_rl_laion_nemotron_gym_identity_following_v2_65_8B_20260825_162529,由 LAION 发布,可用于训练和评估 RL(强化学习)相关模型,尤其是针对大语言模型(LLM)的 RL 训练流程设计。
数据规模与划分
- 总数据集大小:335,620,695 字节(约 320 MB),下载大小为 304,736,089 字节。
- 数据划分:仅包含一个训练集(train),包含 4,621 条样本,数据格式为 JSON 或类似结构化文件(数据文件路径为
data/train-*)。
数据特征字段
每条样本包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表 | 对话内容,每条对话包含 role(角色)和 content(内容)两个字符串字段 |
agent |
字符串 | 智能体标识 |
model |
字符串 | 模型名称 |
model_provider |
字符串 | 模型提供商 |
date |
字符串 | 日期 |
task |
字符串 | 任务类型 |
episode |
字符串 | 回合编号 |
run_id |
字符串 | 运行 ID |
trial_name |
字符串 | 试验名称 |
result |
字符串 | 结果信息 |
verifier_output |
字符串 | 验证器输出 |
trace_source |
字符串 | 跟踪来源 |
数据用途
该数据集主要用于强化学习(RL)场景下的模型训练,特别适合用于身份遵循(identity following)任务的训练与验证。数据集包含完整的对话、任务描述、结果及验证器输出,适合用于评估模型在复杂交互环境中的表现。
配置信息
- 默认配置名:
default - 数据文件格式:支持分片读取(使用
train-*通配符模式),可高效加载大型数据集。
应用建议
- 可用于需要大规模对话数据的 RL 训练流程。
- 适合用于模型身份一致性、指令遵循能力等任务的评测。
- 由于包含
verifier_output和result字段,也可用于训练奖励模型或验证器。