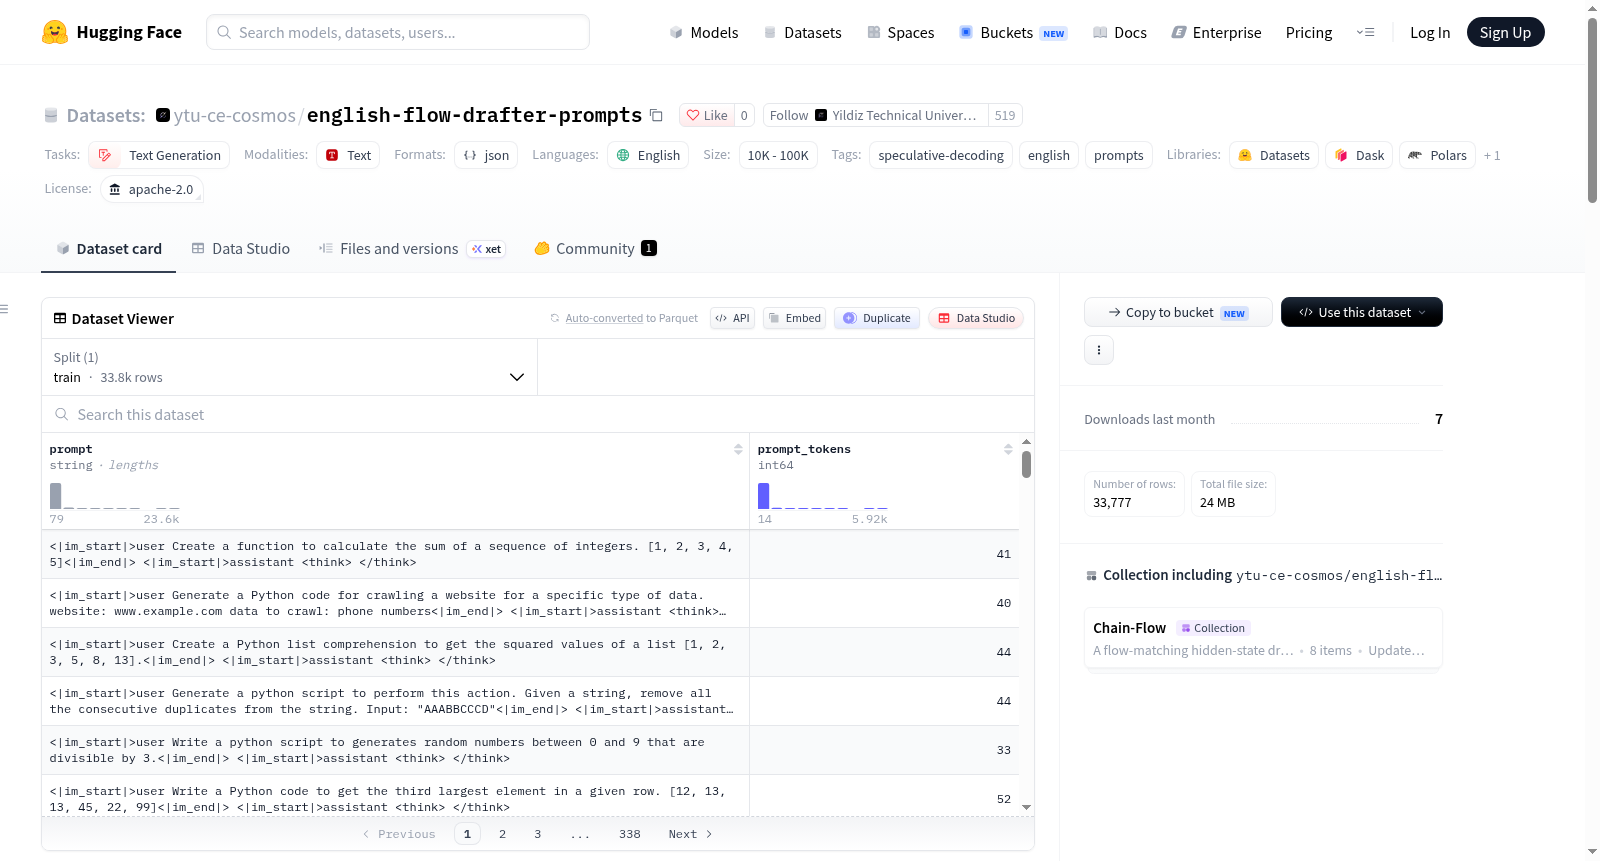
english-flow-drafter-prompts
收藏资源简介:
该数据集是用于 Chained-Flow 框架中 Flow-Drafter 训练的英语 prompts 集合,专门为 Qwen3.5-4B/9B/27B 模型设计。数据集仅包含 prompts,不包含模型输出,drafter 的训练基于目标模型在 prompts 上的 hidden states。数据集共包含 33,777 条 prompts,总计 4,737,781 个 token,分为两个版本(v1 和 v2)。v1 包含 19,672 条训练 prompts 和 500 条保留 prompts,来源包括 Databricks Dolly(通用指令)、GSM8K(小学数学)、Python 代码指令、Nemotron Math(数学推理)和 Nemotron STEM(科学)数据集。v2 新增 14,105 条训练 prompts 和 500 条保留 prompts,来源包括 CNN/DailyMail(摘要)、UltraChat 200K(多轮对话)、No Robots(人工指令)、WritingPrompts(创意写作)和 OPUS Books(翻译)。所有 prompts 均已使用 Qwen3.5 的聊天模板进行格式化(需直接使用,不可重新模板化),并以 JSON Lines 格式存储,每行一个 JSON 对象,包含 prompt 字段(字符串)和 prompt_tokens 字段(整数,由 Qwen3.5-27B tokenizer 计算)。注意,v2 的训练混合为 v1 加 v2 而非仅 v2,两个版本的 prompts 互不相交。数据集中 Nemotron STEM 部分经过内部去重,仅保留 569 条训练 prompts 和 100 条保留 prompts,以反映真实 prompt 多样性。该数据集适用于 speculative decoding 场景下的 drafter 训练任务。
This dataset is a collection of English prompts designed for training Flow-Drafter in the Chained-Flow framework, specifically for the Qwen3.5-4B/9B/27B models. It contains only prompts (no model outputs), and the drafter is trained based on the target models hidden states on these prompts. The dataset consists of 33,777 prompts totaling 4,737,781 tokens, divided into two versions (v1 and v2). v1 includes 19,672 training prompts and 500 held-out prompts from sources such as Databricks Dolly (general instruction), GSM8K (elementary math), Python code instructions, Nemotron Math (mathematical reasoning), and Nemotron STEM (science). v2 adds 14,105 training prompts and 500 held-out prompts from CNN/DailyMail (summarization), UltraChat 200K (multi-turn dialogue), No Robots (human instructions), WritingPrompts (creative writing), and OPUS Books (translation). All prompts are formatted using Qwen3.5s chat template (must be used directly, not re-templated) and stored in JSON Lines format, with each line containing a JSON object with a prompt field (string) and a prompt_tokens field (integer, computed by the Qwen3.5-27B tokenizer). Note that the v2 training mixture is v1 plus v2, not just v2, and the prompts in the two versions are disjoint. The Nemotron STEM subset has been internally deduplicated, retaining only 569 training prompts and 100 held-out prompts to reflect real prompt diversity. The dataset is suitable for drafter training tasks in speculative decoding scenarios.
数据集概述
基本信息
- 数据集地址:https://huggingface.co/datasets/ytu-ce-cosmos/english-flow-drafter-prompts
- 许可证:apache-2.0
- 语言:英语(en)
- 任务类别:text-generation(文本生成)
- 标签:speculative-decoding、english、prompts
数据集用途
用于训练英语 Flow-Drafter 检查点(针对 Qwen/Qwen3.5-4B / 9B / 27B)的对话模板化英语提示词(prompts)。
- 仅包含提示词,不包含补全内容。Drafter 在目标模型自身的隐藏状态上进行训练,因此补全内容通过在这些提示词上运行目标模型在本地生成。数据集中没有任何模型输出。
数据划分
| 划分 | 行数 | 提示词 token 数 | 内容说明 |
|---|---|---|---|
v1/ |
19,672 训练 + 500 留出 | 1,518,620 | 原始混合数据 |
v2/ |
14,105 训练 + 500 留出 | 3,219,161 | v2 中新增的来源 |
- v2 训练混合数据为
v1+v2,而非单独的v2。v2 通过添加五个新领域来扩展混合数据,而不是在现有五个领域上增加行数,因此两个目录互不重叠,在此处保持分离,而非在 v2 内复制 v1。 - 合并后:33,777 条提示词,4,737,781 个提示词 token。
数据来源
v1/ — 原始混合数据
| 上游数据集 | 领域 | 行数 | 平均 token 数 |
|---|---|---|---|
| databricks/databricks-dolly-15k | 通用指令遵循 | 4,858 | 110.2 |
| openai/gsm8k | 小学数学 | 4,900 | 71.5 |
| iamtarun/python_code_instructions_18k_alpaca | 代码 | 4,899 | 44.1 |
nvidia/Nemotron-Post-Training-Dataset-v1(math) |
数学推理 | 4,446 | 75.0 |
nvidia/Nemotron-Post-Training-Dataset-v1(stem) |
STEM | 569 | 147.1 |
v2/ — v2 新增领域
| 上游数据集 | 领域 | 行数 | 平均 token 数 |
|---|---|---|---|
| abisee/cnn_dailymail | 摘要 | 2,697 | 782.3 |
| HuggingFaceH4/ultrachat_200k | 多轮对话 | 2,900 | 190.6 |
| HuggingFaceH4/no_robots | 人工编写指令 | 2,900 | 99.0 |
| euclaise/writingprompts | 创意写作 | 2,764 | 49.5 |
Helsinki-NLP/opus_books(en-fr) |
翻译 | 2,844 | 46.6 |
- 摘要占合并 token 总量的 44%,但仅占行数的 8%——这些来源的提示词长度从 44 到 782 个 token 不等,因此行数不能很好地反映某个来源的权重。
关于 nemotron_stem 的说明
- 其行数较低有原因值得说明。收集过程消耗了
stem划分的前 5,000 行,但该 5,000 行仅包含 669 条不同的提示词——87% 为重复项,且收集器不去重。 - 本数据集文件进行了去重,因此
nemotron_stem在此处表现为 569 训练 + 100 留出,而非 5,000。发布的行是该来源贡献的真实提示词多样性;收集运行只是多次看到了其中许多内容。
数据格式
- 每行一个 JSON 对象:
{"prompt": str, "prompt_tokens": int}。 - 提示词已为 Qwen3.5 进行对话模板化,采用
enable_thinking=False,因此 `<think>
</think>
` 助手前缀已内置于文本中——请逐字输入,不要重新套用模板。
prompt_tokens是在Qwen/Qwen3.5-27B分词器下的长度。- 留出行取自每个来源范围的末尾,因此
train文件恰好是按顺序收集过程所消耗的提示词。
复现方式
在 Chained-Flow(https://github.com/Cosmos-YTU/chained-flow)中运行:
bash python scripts/build_english_prompts.py --out bench_data_en
它会读取每个来源的数据集、划分、范围和格式化器的真实收集配置,因此更改格式化器会更改此输出。