
遇见数据集

UKPLab/ProReviewer-Dataset

收藏
Hugging Face2026-07-07 更新2026-07-22 收录
官方服务:

资源简介:

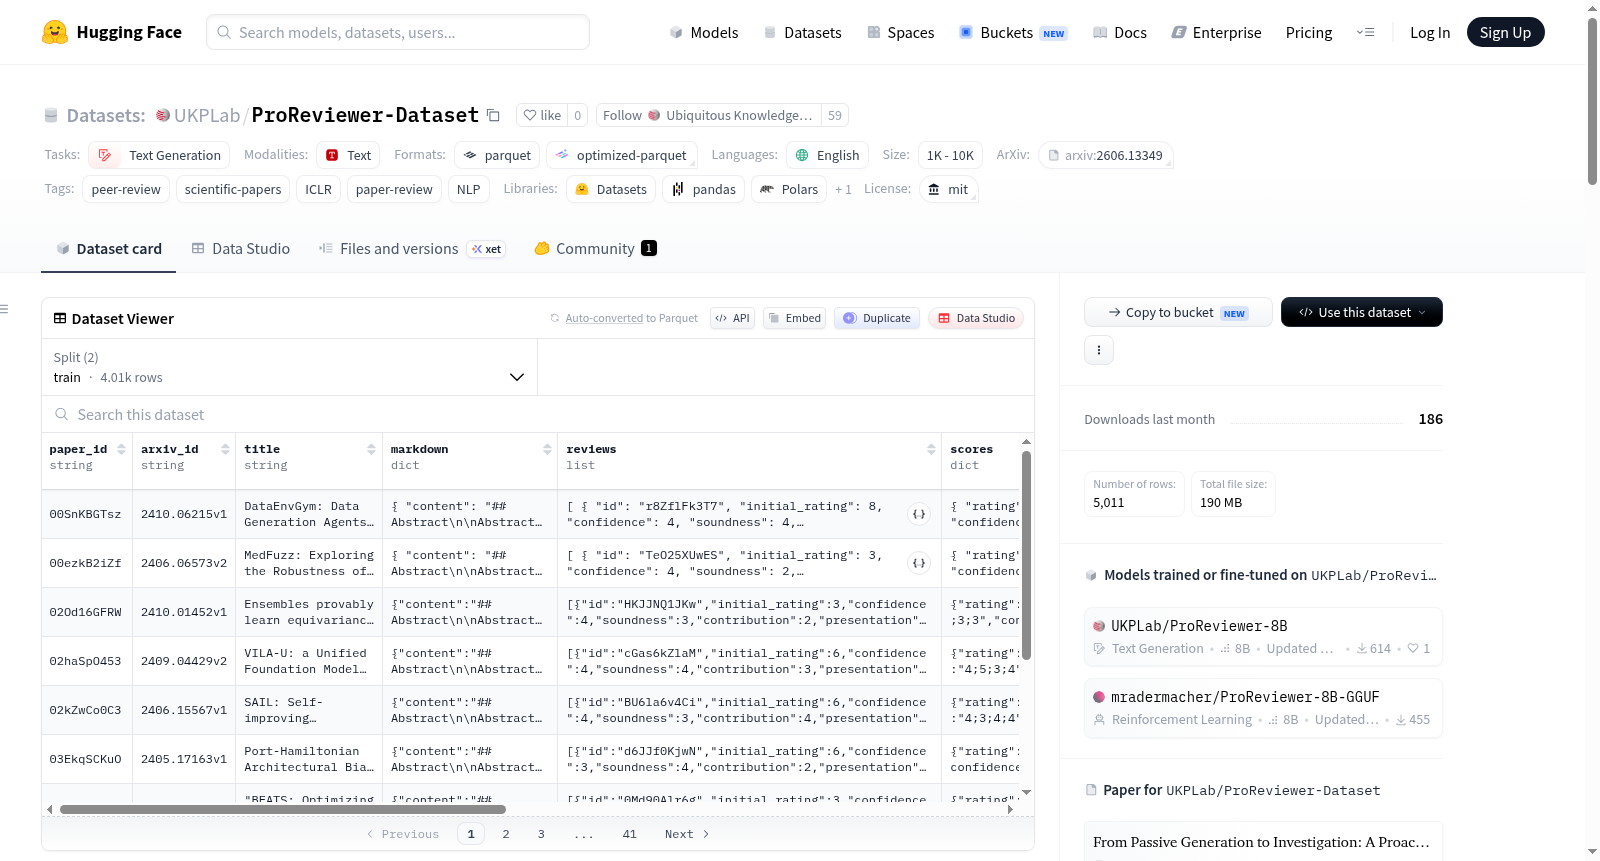
该数据集是一个版本匹配的数据集,包含ICLR论文提交与其初始同行评审和评分。每个样本包括论文的初始提交内容,以及评审者在讨论阶段之前给出的初始评分,支持自动化学术同行评审的研究。数据集用于训练和评估自动同行评审系统,所有论文和评审都是版本匹配的:论文内容对应初始提交,评审分数反映初始评分,确保模型学习评估首次提交的论文,评分反映第一印象而非讨论后的调整。数据集分为训练集(来自ICLR 2025,4,011个样本)和测试集(来自ICLR 2026,1,000个样本),特征包括论文ID、arXiv ID、标题、Markdown内容、评审列表、聚合评分、元数据、元评审和最终决定等。

A version-matched dataset of ICLR paper submissions paired with their initial peer reviews and scores. Each sample contains the initial submission of a paper matched with the reviewers initial ratings (before the discussion phase), enabling research on automated scientific peer review. This dataset supports training and evaluating automated peer review systems. All papers and reviews are version-matched: the paper content corresponds to the initial submission, and the review scores reflect the initial ratings assigned before any author-reviewer discussion. This version matching is important for training review agents, as it ensures the model learns to evaluate papers as they were first submitted, with scores that reflect first impressions rather than post-discussion adjustments.
提供机构:
UKPLab
搜集汇总
数据集介绍
UKPLab/ProReviewer-Dataset 数据集图片
构建方式
ProReviewer-Dataset 通过系统收集来自 OpenReview 平台的 ICLR 2025 与 ICLR 2026 两届会议论文及其评审记录构建而成。数据集严格实现了版本匹配:论文内容对应作者首次提交的初始版本,评审分数则取自讨论阶段前评审员给出的初始评分。所有样本经过去重与结构化处理,保留了论文元信息、评审文本、聚合分数及区域主席的元评审与最终决策,形成了层次分明、字段完整的结构化知识库。
特点
该数据集最大的特色在于其版本一致性,确保了论文内容与评审分数在时间维度上的精确对齐,为训练自动化同行评审模型提供了干净、可靠的监督信号。数据包含多维度的细粒度评分(如声音性、贡献度、展示质量等),以及丰富的评审文本(总结、优势、不足与提问),使得模型不仅能学习数值打分,还能掌握评审语言的逻辑与风格。此外,训练集与测试集来自不同年份,有助于评估模型的泛化能力。
使用方法
使用者可通过 HuggingFace Datasets 库直接加载,仅需一行代码(load_dataset("UKPLab/ProReviewer-Dataset"))即可获取训练与测试分割。每条样本以字典形式组织,可通过键名访问论文标题、内容、评审列表与聚合分数。数据还支持对评审文本进行逐条遍历,适用于文本生成、评分预测与多任务学习等场景。推荐将论文内容与初始评分作为输入,训练模型生成结构化的评审反馈或预测各项分数。
背景与挑战
背景概述
在学术出版领域,同行评审是保障论文质量与科学严谨性的核心环节,然而传统评审流程日益面临效率低下与主观性偏差的双重挑战。为探索自动化评审的可行路径,研究团队由Haishuo Fang、Yue Feng与Iryna Gurevych领衔,依托ICLR 2025与2026两届会议的OpenReview平台,构建了ProReviewer-Dataset。该数据集收录了4011条训练样本与1000条测试样本,每项样本均包含论文的初始投稿内容、评审员在讨论环节前给出的原始评分及评议文本、元评审及最终决策,且版本严格匹配。这些特征使其成为首个支持主动式科学同行评审代理训练与评估的大规模语料库,为开发能够理解论文内容并生成建设性反馈的智能系统提供了关键基准,有望革新学术评审的效率与公正性。
当前挑战
该数据集旨在应对多重严峻挑战。首先,学术评审本身是一项高度复杂的认知任务,需要评审员综合评估论文的技术正确性、创新贡献、表达清晰度等多个维度,同时识别潜在漏洞并提出改进建议,现有自然语言处理模型在生成精准、有深度的评审文本方面仍显乏力。其次,构建过程中面临版本一致性问题:论文内容与评审分数必须严格对应初始提交版本,以避免作者修改或讨论环节对评分的影响,这要求数据采集时精心筛选OpenReview接口中的时间戳信息。此外,评审数据的隐私性与版权限制使得大规模获取存在法律障碍,而跨学科术语的多样性进一步增加了文本理解难度。最后,缺乏公认的自动评审评价指标,使得系统性能的横向比较难以有效开展。
常用场景
经典使用场景
在学术评审自动化研究的浪潮中,ProReviewer-Dataset 为构建与评估智能评审系统提供了高度匹配的基准资源。该数据集收录了来自 ICLR 2025 和 ICLR 2026 共5,011篇论文的初始投稿版本及其对应的首轮同行评审意见与评分,确保论文内容与评分严格版本对齐——即评审者基于原始稿件给出的初始评价。这一精心设计使得研究者能够训练模型学习论文与初始评审之间的映射关系,是自动评审生成、评分数值预测以及评审质量评估等经典研究任务的理想训练与测试平台。
解决学术问题
ProReviewer-Dataset 直面当前学术评审自动化中的两个关键难题:数据版本错配与评审过程时间偏移。以往数据集常混入作者修改后的论文版本或覆盖讨论后的调整评分,导致模型学习到有偏差的映射规律。该数据集通过严格追踪提交时间戳,确保每篇稿件对应的是评审者首次给出的评分与评语,从而真实还原同行评审的初始评估环节。基于这一高质量对齐数据,研究者可以量化分析评审标准的一致性、预测论文接收与否的初评信号,并探索如何利用语言模型生成具有建设性的初版评审意见,为提升评审效率与透明度提供了坚实的实证基础。
衍生相关工作
ProReviewer-Dataset 的构建与发布直接催生了一系列前沿研究。其核心关联工作《From Passive Generation to Investigation: A Proactive Scientific Peer Review Agent》基于该数据集训练了一种主动式评审智能体,该智能体不仅能够生成评审意见,还能主动检索文献、核实实验参数并提出质疑性问题,将评审从被动生成提升至主动探究层次。此外,后续工作围绕该数据集展开了评审风格迁移、多维度评分联合预测以及评审与元评审一致性建模等课题,形成了以该数据集为枢纽的学术社区研究生态,推动自动化科研评审从概念验证走向现实落地。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

