
遇见数据集

wizzense/Usenet-Corpus-1980-2013

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

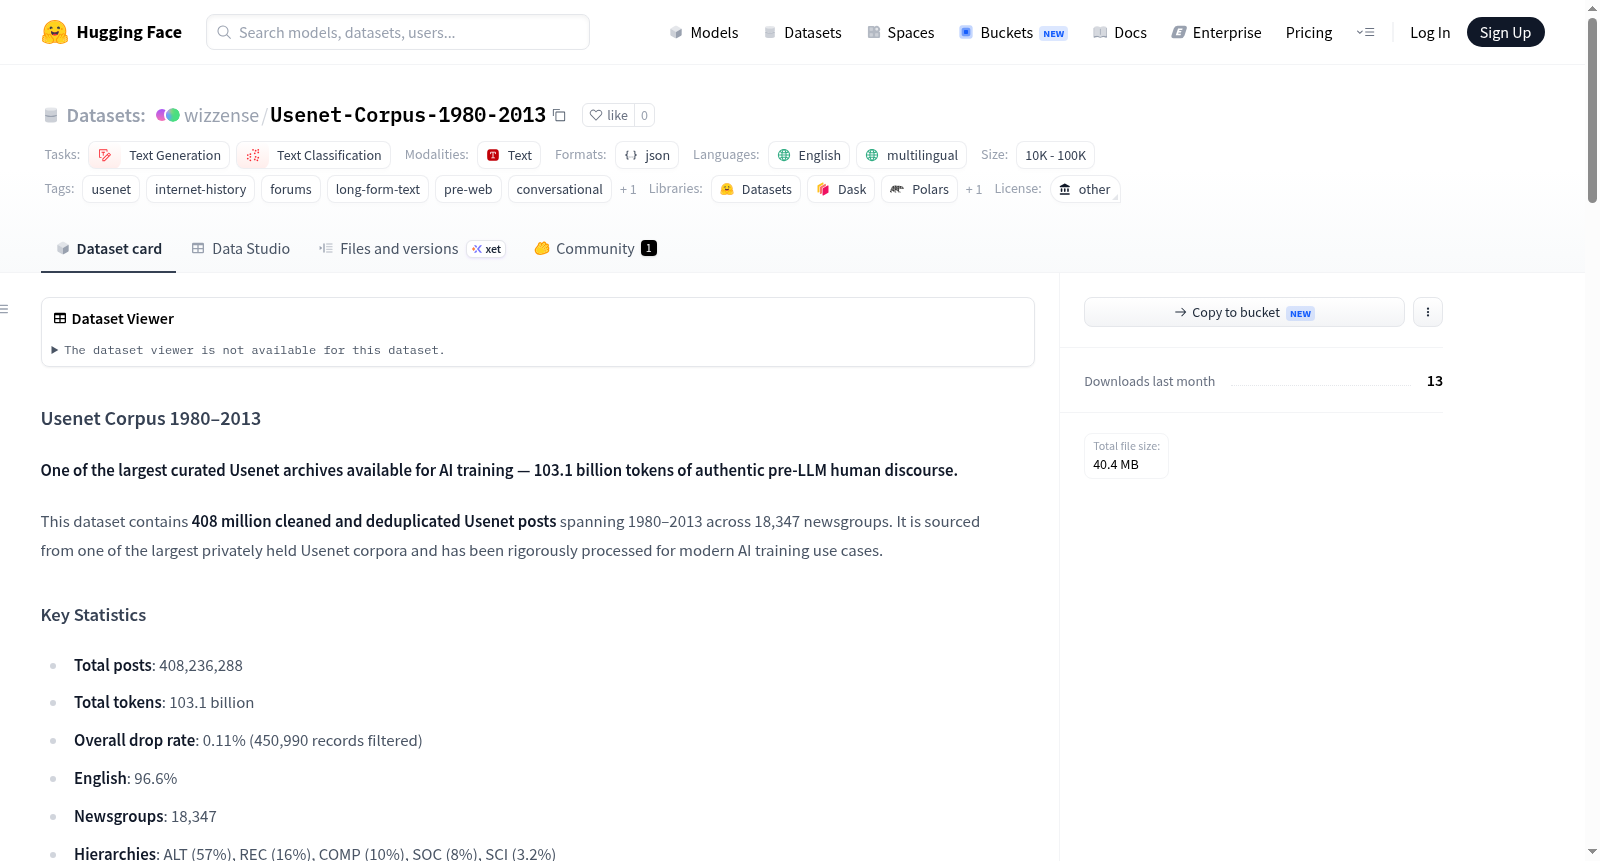
Usenet Corpus 1980–2013是一个大型、经过精心整理的Usenet存档数据集,专为AI训练设计。它包含4.08亿条经过清洗和去重的Usenet帖子,覆盖1980年至2013年期间的18,347个新闻组,总计1031亿个令牌。数据集源自最大的私有Usenet语料库之一,并经过严格处理,适用于现代AI训练用例。关键统计包括:总帖子数408,236,288,总令牌数1031亿,英语内容占比96.6%,主要新闻组层次结构包括ALT(57%)、REC(16%)、COMP(10%)、SOC(8%)和SCI(3.2%)。每个记录包含文本、新闻组名称、日期、主题、作者(已匿名处理)和ID等字段。数据集经过广泛清洗,移除了alt.binaries.*和成人内容、二进制编码,并进行了去重和敏感内容过滤,确保数据质量。预期用途包括LLM的预训练和持续预训练、领域适应(技术、科学和历史话语)、对话和长上下文建模、语言学研究以及去偏和时间语言研究。数据集不适用于重新识别、分析或垃圾邮件生成。访问方式包括学术/非商业用途的免费预览和商业用途的许可选项。

Usenet Corpus 1980–2013 is one of the largest curated Usenet archives available for AI training, containing 408 million cleaned and deduplicated Usenet posts spanning 1980–2013 across 18,347 newsgroups, with a total of 103.1 billion tokens. It is sourced from one of the largest privately held Usenet corpora and has been rigorously processed for modern AI training use cases. Key statistics include total posts of 408,236,288, total tokens of 103.1 billion, English content at 96.6%, and major hierarchies such as ALT (57%), REC (16%), COMP (10%), SOC (8%), and SCI (3.2%). Each record includes fields like text, group, date, subject, author (with PII redacted), and ID. The corpus has undergone extensive cleaning, including removal of alt.binaries.* and adult content, stripping binaries, deduplication, sensitive content filtering, and PII redaction. Intended uses include pre-training and continued pre-training of LLMs, domain adaptation for technical, scientific, and historical discourse, dialogue and long-context modeling, linguistic research, and debiasing and temporal language studies. It is not intended for re-identification, profiling, or spam generation. Access is available for academic/non-commercial use via a free preview on Hugging Face, with commercial licensing options for full corpus access.
提供机构:
wizzense
搜集汇总
数据集介绍
wizzense/Usenet-Corpus-1980-2013 数据集图片
构建方式
Usenet-Corpus-1980-2013数据集源自全球最大的私人Usenet语料库之一,涵盖了自1980年至2013年间来自18,347个新闻组的408,236,288篇经过清洁与去重的帖子。其构建过程遵循了严苛的数据净化流程,包括移除alt.binaries.*及成人内容、剥离UUencode和Base64编码的二进制数据、执行去重与敏感内容过滤,并实施了个人身份信息(如电子邮件和作者名)的匿名化处理,最终仅舍弃了0.11%的记录,保留了103.1亿个token的高质量语料。
特点
该数据集最显著的特点在于其规模宏大且时间跨度极长,忠实记录了前大语言模型时代长达三十余年的真实人类网络讨论。其内容结构层次分明,ALT.*层次贡献了最多样化的内容(58.8B token),而COMP.*和SCI.*层次则提供了技术深度与科研级的高信号质量。此外,数据还保留了新闻组名称、ISO 8601时间戳、主题和作者等元信息,便于按层级或时间窗口进行分析,已成功应用于实践模型训练,展现了在技术、科学和历史话语领域的特殊价值。
使用方法
此数据集适用于大型语言模型的预训练与持续训练,尤其在领域适应、对话建模、长上下文理解、语言学研究和数字人文学科中表现突出。使用时可直接加载Hugging Face平台上的预览子集,每个记录包含清洗后的正文文本、新闻组、时间戳、主题和匿名化的作者信息。研究人员可通过时间过滤(如1995年前后)以优化模型输出质量,亦可按层次(如comp.*或sci.*)提取高质量子集。商业用途需获取相应许可,学术与非商业用途则可通过gated访问免费获取。
背景与挑战
背景概述
Usenet作为互联网早期最重要的分布式讨论系统,承载了从1980年至2013年间全球用户围绕技术、科学、社会、娱乐等多元议题展开的真实对话,其存档构成了研究数字时代人类语言演变与社群交流的珍贵史料。Usenet-Corpus-1980-2013数据集由独立研究机构OwnedByDanes于2025年发布,收录了来自18,347个新闻组的4.08亿篇经过去重与清洗的帖子,总规模达1031亿tokens,其中英语内容占比96.6%。该数据集的核心研究价值在于提供未经大语言模型污染的、跨越三十余年的原生人类语料,为语言模型预训练、领域自适应、长文本建模及历史语言学研究提供了前所未有的数据基础,尤其ALT、REC、COMP、SOC等层级覆盖了从亚文化探讨到专业学术讨论的广阔语义空间,对理解互联网话语演化与人工智能对齐研究具有深远影响力。
当前挑战
该数据集所应对的领域挑战在于,现有大语言模型训练语料多源自当代网页爬取或受控文本,缺乏对前Web时代(1980-1995)人类真实、未经修饰的群组对话的覆盖,难以捕捉互联网早期多元亚文化与技术社群特有的语言风格与知识结构。在构建过程中,核心挑战包括:其一,从海量历史存档中去除alt.binaries.*等二进制内容与成人材料,需精准识别并剥离UUencode与Base64编码的混合数据,总体丢弃率严格控制在0.11%;其二,对约45万条敏感内容、违规信息及PII进行自动化过滤与匿名化处理,在保留文本原真性的同时确保隐私合规;其三,处理跨越34年的异构数据格式、编码不一致及重复帖子的高效去重,同时保证各层级(如ALT的57%数据占比)与各新闻组的质量均衡,为下游模型训练提供干净、可追溯的语料支撑。
常用场景
经典使用场景
Usenet-Corpus-1980-2013数据集汇聚了1980年至2013年间逾4亿篇经过去重与清洗的Usenet帖子,横跨18,347个新闻组,涵盖技术、科学、娱乐与社会等多元领域。其经典用途在于为大规模语言模型提供丰富、真实且时序跨度长的人类对话语料,特别适用于预训练与持续预训练任务。研究者可借助该数据集捕捉互联网早期至Web 2.0时代的语言演变轨迹,训练模型在技术讨论、科学论证与日常交流等场景下生成更自然、更具上下文连贯性的文本,同时为领域自适应与对话建模提供坚实基础。
解决学术问题
该数据集有效解决了学术研究中长期存在的两大难题:一是缺乏大规模、高质量且带有明确时间戳的预互联网时期人类语料,限制了语言模型对历史语言风格与知识体系的建模能力;二是技术与非技术领域对话数据不平衡,导致模型在专业话题上的表现欠佳。Usenet-Corpus-1980-2013通过提供comp.*与sci.*层次的高信噪比文本,使研究者能够系统分析语言演变、技术术语的语义漂移以及跨时段对话模式,为计算语言学中的时间语言研究、去偏见分析与数字人文学探索开辟了新路径。
衍生相关工作
围绕Usenet-Corpus-1980-2013衍生了一系列具有影响力的工作。典型代表包括wyan/usenet-gemma-4-E2B-lora系列模型,其利用该数据集对Gemma架构进行低秩自适应微调,展示了技术子集在领域适配中的优越性;意大利变体则探索了多语言场景下的迁移学习。此外,研究者基于时间过滤策略(如1995年前后分界)对比模型输出质量,推动了时序知识蒸馏技术的发展。这些工作不仅验证了数据集中comp.*与sci.*层次的高质量信号,还激发了后续关于历史语料去偏见、对话一致性评估以及跨年代语言建模的学术探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

