
遇见数据集

mkd-chanwoo/keural-QA-en

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

keural-synthetic-SFT-en-general 是一个从英文维基百科合成的通用监督微调(SFT)数据集,通过两阶段管道生成。该数据集包含约160万条记录,涵盖三类任务:通用问答(general_qa,约33.5%)、推理(reasoning,约33.5%)和结构化输出(structured_output,约33.0%)。生成过程中,模型以维基百科文章为基础锚点,但问题和答案均不引用源文档(如“根据文档”等短语),旨在减少幻觉并模拟自然问答,适用于通用指令调优而非检索增强生成(RAG)微调。数据集使用google/gemma-4-26B-A4B-it模型生成,经过基于规则的质量过滤,记录格式为JSONL,包含问题、答案和原始维基百科文本等字段。

keural-synthetic-SFT-en-general is a synthetic general-purpose supervised fine-tuning (SFT) dataset generated from English Wikipedia using a two-stage pipeline. The dataset contains approximately 1.6 million records across three task types: general_qa (~33.5%), reasoning (~33.5%), and structured_output (~33.0%). During generation, the model uses Wikipedia articles as a grounding anchor, but both questions and answers contain no references to source documents (e.g., no phrases like based on the text), aiming to reduce hallucination and mimic natural Q&A, making it suitable for general instruction tuning rather than retrieval-augmented generation (RAG) fine-tuning. The dataset is generated using the google/gemma-4-26B-A4B-it model, filtered through rule-based quality checks, and formatted in JSONL with fields such as question, answer, and original Wikipedia text.
提供机构:
mkd-chanwoo
搜集汇总
数据集介绍
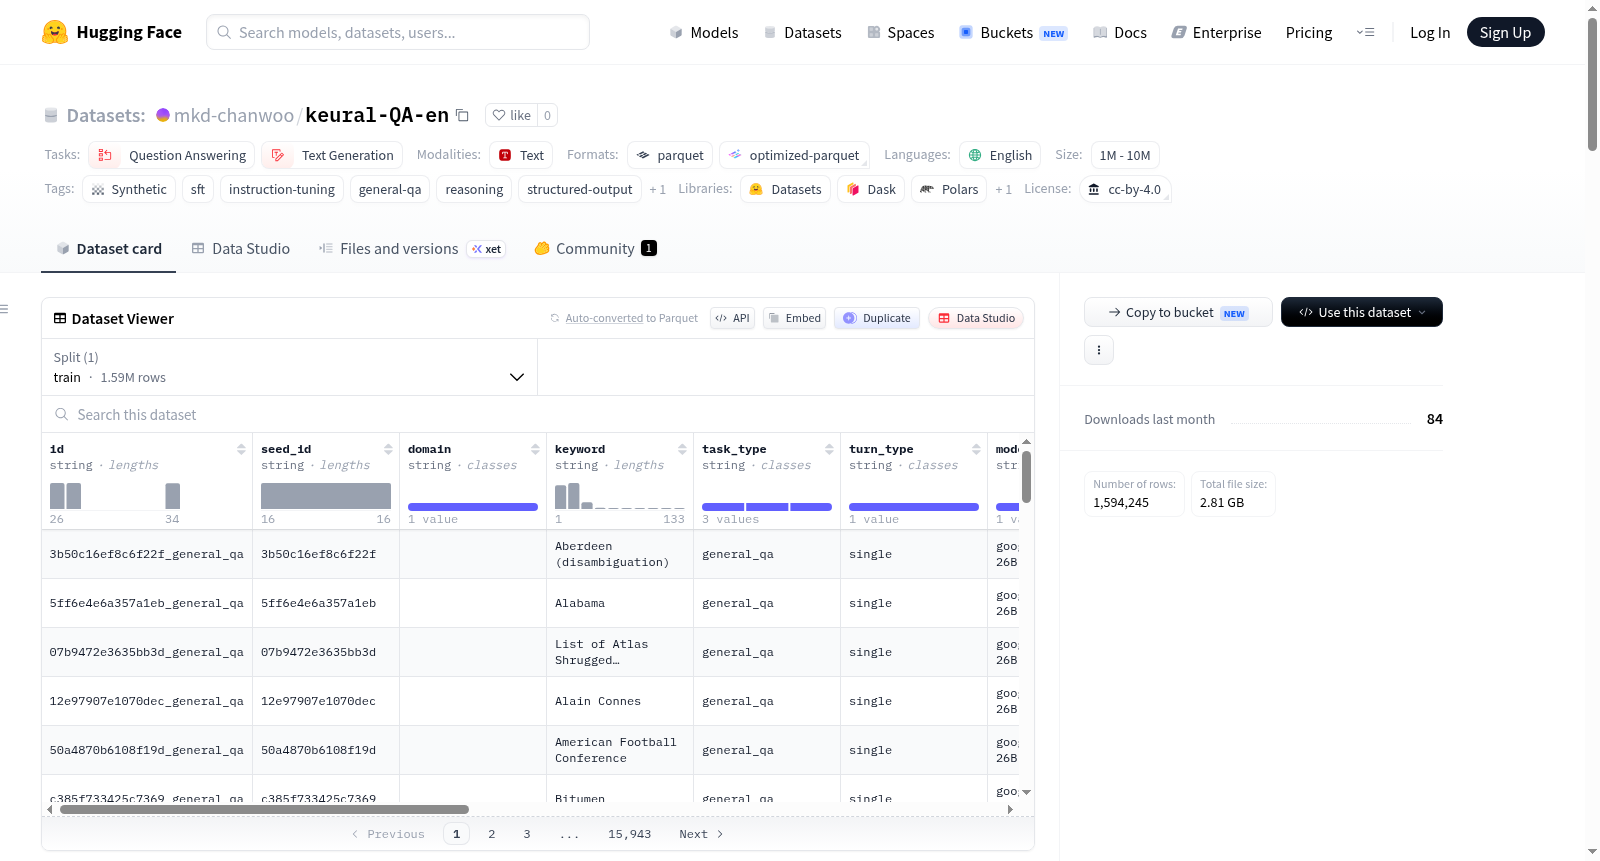
mkd-chanwoo/keural-QA-en 数据集图片
构建方式
keural-QA-en数据集以英文维基百科20231101.en快照中约107万篇文档为种子,采用两阶段流水线合成生成。第一阶段,大语言模型google/gemma-4-26B-A4B-it读取维基百科文章后,生成一个完全自包含的问题,禁止出现任何指向源文档的措辞;第二阶段,模型将维基百科文本作为事实锚点,结合已生成的问题给出详细回答,同样避免提及源文档。整个流程涵盖general_qa、reasoning与structured_output三类任务,分别聚焦事实性问答、因果推理及结构化输出,并通过基于规则的过滤器剔除重复、过短或过长的低质样本,最终保留约160万条高质量问答对。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,代码为`load_dataset("mkd-chanwoo/keural-QA-en")`。为适配SFT训练,需将每条记录中的'question'与'answer'字段转化为对话格式:构建包含'user'角色(问题)与'assistant'角色(答案)的消息列表。需注意,记录中的'text'字段保留了原始维基百科文章,仅用于溯源参考,不应纳入模型输入。数据集已在'id'字段层面完成去重,可直接用于训练通用指令跟随模型,无需额外清洗。
背景与挑战
背景概述
keural-QA-en数据集由研究机构或个人开发者mkd-chanwoo于近期创建,旨在为大规模语言模型的指令微调(SFT)提供高质量的合成问答数据。该数据集以英文维基百科(2023年11月快照)为种子源,利用两阶段流水线生成:第一阶段使模型阅读维基百科文章并生成自包含问题,第二阶段基于原文锚定生成答案,同时严格避免对源文档的显式引用。这一设计使得生成样本不附带检索增强生成(RAG)的痕迹,模型需依靠自身知识作答,从而更适合通用SFT场景。数据集规模达约160万条,涵盖通用问答、推理和结构化输出三类任务,接受率高达99.5%,在提升模型事实性、减少幻觉方面具有显著价值,为领域内合成数据构建提供了新颖且实用的范式。
当前挑战
keural-QA-en语料库所解决的领域核心挑战在于:当前指令微调数据集普遍存在对源文档的显式依赖(如RAG数据中的引用),导致模型在脱离检索上下文时容易产生虚假事实或无法独立回答;该数据集通过两阶段生成策略巧妙规避了此类痕迹,同时利用维基百科的实体知识确保答案的事实基础。构建过程中面临的主要挑战包括:生成阶段需精确控制指令以避免模型产生文档引用短语,为此设计了包含负面提示的严格提问与回答约束;质量过滤环节主要依靠基于规则的验证器,主要拒绝原因为重复生成(占82%),其次是未检测到答案(7.3%)和回答过短(6.7%),其中重复问题对生成模型的多样性和温度参数设置提出了较高要求。
常用场景
经典使用场景
在自然语言处理与人工智能领域,指令微调是提升大语言模型遵循人类意图能力的关键环节。keural-QA-en数据集以其约160万条高质量、无源文档引用的问答对,成为通用型监督微调的经典基石。该数据集涵盖三类任务:基于事实的general_qa、探索因果机制与逻辑推理的reasoning、以及要求以列表或表格形式呈现的结构化输出structured_output。其独特之处在于设计了一套双阶段生成流水线——以Wikipedia文章为事实锚点,但强制模型生成自包含的问答,彻底剥离RAG场景中常见的文档引用痕迹,使得数据集天然适用于培养模型独立运用内在知识的能力。研究者可直接将每条记录中的question与answer转换为多轮对话格式,用于微调基础模型,使其在未见过的知识问答、逻辑推理与结构化输出任务上展现出更稳健的泛化性能。
解决学术问题
keural-QA-en数据集精准回应了大语言模型研究中的三大核心挑战。首先,它有效缓解了传统合成数据中常见的幻觉问题——通过将Wikipedia文章作为生成阶段的内隐锚点,并辅以基于规则的严格过滤(如重复检测、答案长度校验),使得约99.5%的高接受率数据在事实准确性上获得了根本保障,为构建可信赖的模型提供了数据层面的可靠支撑。其次,该数据集系统性地解决了通用监督微调与检索增强生成数据之间的混淆问题:刻意禁止文档引用短语的出现,使微调后的模型能够摆脱对外部检索模块的依赖,专注于自我知识的内化与调用,从而为研究“模型究竟学到的知识还是模式”这一根本性问题提供了纯净的实验环境。最后,其均衡的三类任务分布(各占33%)为提升模型在复杂推理与结构输出方面的综合能力设立了量化基准,推动了从简单问答到多维度认知链路的研究进展。
实际应用
在实际部署中,keural-QA-en数据集为构建能够独立应答的智能交互系统提供了高效的数据引擎。教育领域可借其reasoning子集开发的模型进行启发式教学,引导学生理解历史事件的因果链条或科学原理的运作机制,而无需每次都引用冗长的教材原文。商业场景中,结构化输出子集赋予模型直接生成格式化的对比分析表或操作清单的能力,例如在金融领域提供不同投资方案的优缺点列表,或在医疗咨询中输出症状与注意事项的规范化表格,极大提升了信息整合与用户阅读的效率。此外,由于数据完全避免了检索类幻觉,基于此数据集微调的聊天机器人、虚拟助教与智能客服均能展现出更自然、自信的回答风格,无需在回答中插入“根据文档显示”等冗余表述,使用户交互体验更加流畅且具有说服力。
数据集最近研究
最新研究方向
keural-QA-en数据集的最新研究方向聚焦于利用无源引用(source-free)的合成数据生成范式,通过两阶段流水线从维基百科种子构建自然且事实性的通用指令微调(SFT)数据。该数据集刻意规避检索增强生成(RAG)场景中的文档指代痕迹,使模型在回答时完全依赖内部知识,从而提升推理与结构化输出的真实性与自洽性。当前前沿探索包括将此类数据用于强化大型语言模型在因果推理、列表比较及无背景依赖下的问答能力,同时结合规则过滤器来抑制重复与不完整回答。这一数据设计方法与近期围绕大模型幻觉缓解、合成数据质量评估及知识锚定训练等热点事件紧密相连,为构建更干净、鲁棒的通用SFT基准提供了新思路,并推动了从RAG依赖型到知识内化型训练数据的范式转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

