
遇见数据集

mkd-chanwoo/normalized-datasets-for-koreanLLM

收藏
Hugging Face2026-05-28 更新2026-04-12 收录
官方服务:

资源简介:

这是一个用于韩语大语言模型预训练的规范化数据集,属于Keural韩语LLM预训练管道的阶段0.5输出。该数据集将来自38个源数据集的原始文本转换为统一的JSONL模式,未应用任何过滤,是干净、结构化的原始形式。数据集规模约为8.36亿文档,涵盖英语、韩语、代码和科学领域,每个文档都遵循统一的JSONL模式(包括doc_id、source_name、domain、language、text等字段)。规范化过程解决了不同源数据集格式和字段名不一致的问题,将所有文本提取并写入统一模式,并添加元数据(如领域、语言、许可证)。数据集主要用于下游处理阶段(如过滤、去重),是预训练数据准备的基础步骤。

This is a normalized dataset for pre-training Korean Large Language Models (LLMs), which is the stage 0.5 output of the Keural Korean LLM pre-training pipeline. This dataset converts raw texts from 38 source datasets into a unified JSONL schema without applying any filtering, retaining a clean and structured raw form. The dataset contains approximately 836 million documents, covering English, Korean, code, and scientific domains. Each document adheres to the unified JSONL schema, including fields such as doc_id, source_name, domain, language, and text. The normalization process resolves the inconsistencies in formats and field names across different source datasets, extracts all texts and writes them into the unified schema, while adding metadata such as domain, language, and license. The dataset is primarily used for downstream processing stages (e.g., filtering, deduplication) and serves as a foundational step in pre-training data preparation.
提供机构:
mkd-chanwoo
搜集汇总
数据集介绍
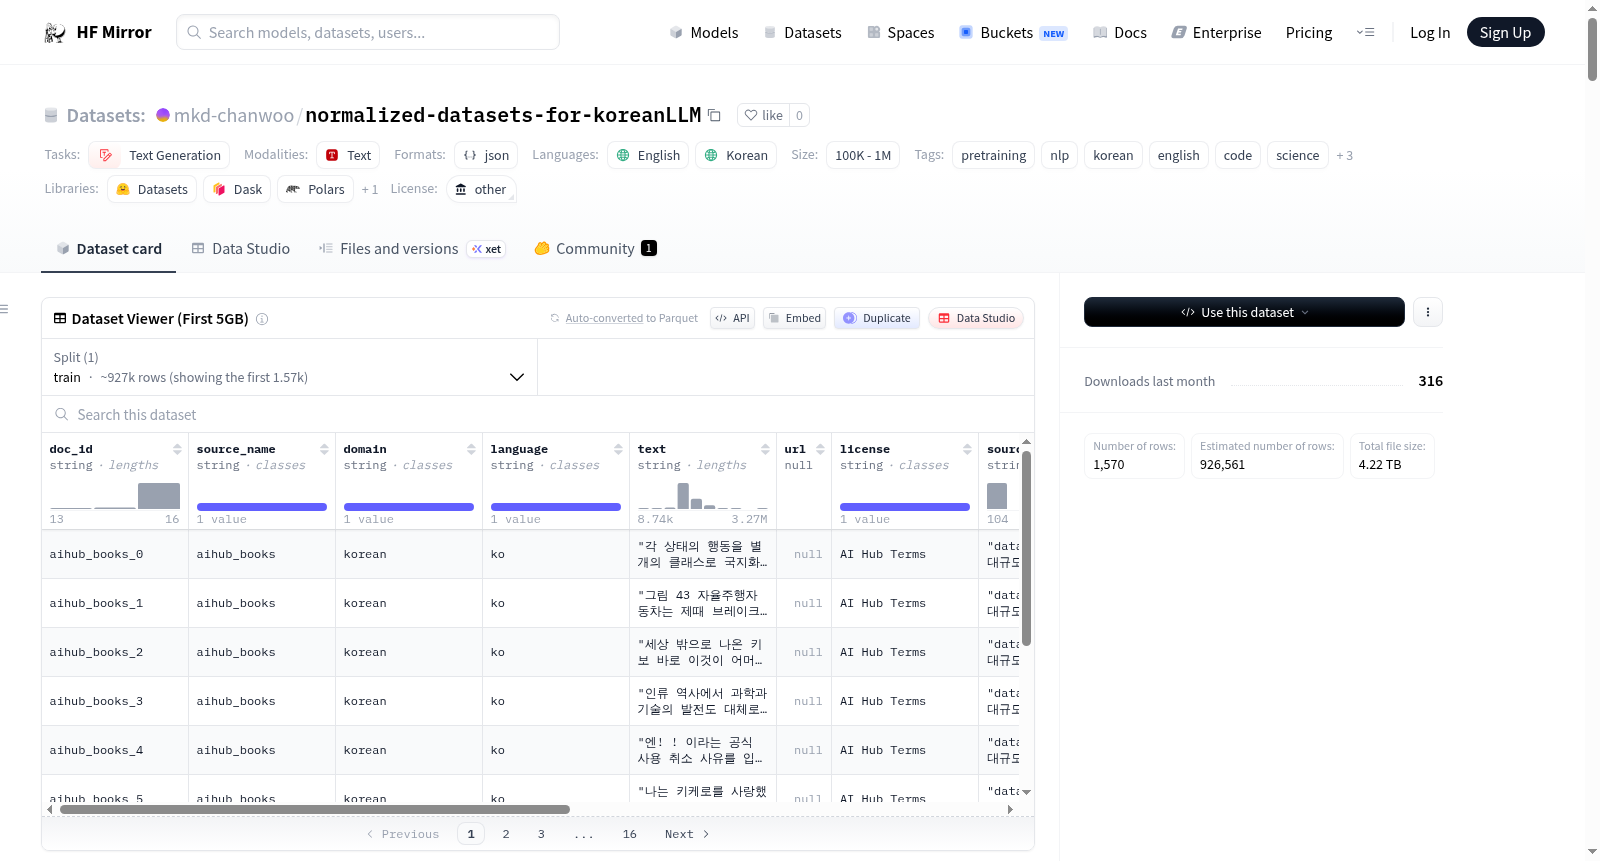
mkd-chanwoo/normalized-datasets-for-koreanLLM 数据集图片
构建方式
在构建大规模语言模型预训练语料库的背景下,该数据集作为Keural韩语大语言模型预处理流水线的中间产物,其构建核心在于数据归一化。该过程从19个异构的原始数据源中提取文本,这些源数据涵盖了英语、韩语、代码和科学文献等多个领域,并以JSONL、Parquet、CSV等多种格式存储。归一化操作旨在解决原始数据格式与字段命名不统一的问题,通过读取各源数据,从其特定的字段(如`TEXT`、`text`、`content`、`plain_text`)中提取原始文本内容,并统一写入一个标准化的JSONL格式中。此过程为每个文档添加了包括领域、语言、文档ID、许可证等在内的元数据,但严格保留了文本内容的原始性,未进行任何清洗、过滤或去重处理,从而生成了约5.35亿条结构一致、可直接用于下游处理的规范化文档。
特点
该数据集作为韩语大语言模型预训练流程中的关键一环,其显著特点在于其纯粹的结构归一化属性。数据集严格遵循统一的JSONL文档模式,每个文档均包含`doc_id`、`source_name`、`domain`、`language`、`text`等标准化字段,确保了跨不同来源数据的高度一致性。其内容构成多元,以英语和科学文献为主,辅以代码及韩语文本,为模型提供了跨领域的知识基础。尤为重要的是,该数据集忠实保留了所有源数据的原始文本内容与相应许可证信息,未引入任何修改或筛选偏差,为后续的过滤、去重等处理阶段提供了干净、透明的数据起点。其构建过程具备可恢复性,通过检查点机制确保了大规模数据处理流程的鲁棒性。
使用方法
作为预处理流水线的中间产物,该数据集的主要用途是作为下游数据处理的标准化输入。研究人员或开发者可直接通过HuggingFace平台加载此数据集,利用其统一的JSONL格式和丰富的元数据,便捷地进行后续的语料质量过滤、语言识别、毒性内容筛查等操作。由于数据已归一化,下游处理逻辑无需再适配多种原始数据格式,极大地简化了流程。该数据集亦可作为研究多语言、多领域语料库构建与分析的基准数据,其详尽的来源映射与统计信息为语料构成分析提供了可靠依据。用户在使用时需注意,数据集内含混合许可证,在商业或特定研究用途前应逐一核查各源数据的许可条款。
背景与挑战
背景概述
在大型语言模型(LLM)预训练领域,构建高质量、多语言且领域覆盖广泛的预训练语料库是提升模型性能的关键基础。Normalized Datasets for Korean LLM(Keural Korean LLM预训练管道第0.5阶段)由研究人员mkd-chanwoo于2026年4月创建并发布,旨在为韩语及多语言大模型提供统一结构化的原始数据。该数据集整合了来自19个不同来源的约5.35亿份文档,涵盖英语、韩语、代码和科学四大领域,通过规范化处理将异构数据源转换为统一的JSONL格式,为后续的过滤、去重等处理阶段奠定了标准化基础。其核心研究问题在于解决多源、多格式文本数据在预训练流程中的结构不一致性,从而提升数据处理管道的效率与可复现性,对推动韩语及多语言大模型的发展具有重要的基础设施价值。
当前挑战
该数据集致力于解决多语言大模型预训练中语料库构建的结构化与标准化挑战。在领域层面,其主要应对多源异构数据的整合难题,例如不同数据集在文本字段命名、存储格式及许可证协议上的差异,这要求规范化过程具备高度的兼容性与元数据管理能力。在构建过程中,挑战体现在大规模数据处理的可靠性与一致性上:尽管规范化过程设计了可恢复的检查点机制以应对中断,但部分数据源(如AIHub数据集)在读取时因去重处理导致文档写入率仅为50%,反映了原始数据质量与结构复杂性带来的损耗。此外,数据涵盖多种许可证协议,在后续使用中需谨慎处理合规性问题,而韩语语料仅占总体的1.1%,也凸显了多语言资源平衡的挑战。
常用场景
经典使用场景
在大型语言模型预训练领域,数据预处理是构建高质量语料库的关键环节。该数据集作为Keural韩语LLM预训练流程的规范化输出,其经典使用场景在于为下游的过滤、去重和分片等处理阶段提供统一的结构化基础。通过将来自19个不同来源的原始文本转换为标准化的JSONL格式,研究者能够在一个一致的框架下高效处理多语言、多领域的海量文档,从而显著提升数据管道的可操作性和可扩展性。
衍生相关工作
该数据集是Keural数据预处理流水线的核心组成部分,直接衍生出一系列相关的经典工作。在规范化阶段之后,数据进入Stage 1的过滤阶段,产生了`mkd-chanwoo/filtered-datasets-for-koreanLLM`数据集,专注于质量、语言和毒性过滤。随后,Stage 2的`mkd-chanwoo/keural-datasets`完成了最终的去重和分片,成为可直接用于模型训练的生产数据。最终,这些处理后的语料被用于训练`mkd-chanwoo/simplemodel-270M`等大型语言模型,形成了一个完整的数据准备到模型训练的研究与应用闭环。
数据集最近研究
最新研究方向
在韩语大语言模型(LLM)预训练领域,数据集的规范化与多语言融合正成为前沿研究的关键焦点。Normalized Datasets for Korean LLM作为Keural预训练流程的中间产物,通过统一19个来源数据集的格式,构建了涵盖英语、韩语、代码及科学文本的标准化语料库。这一举措不仅解决了多源数据异构性带来的技术挑战,更为后续的过滤、去重及模型训练提供了结构化基础。当前研究热点集中于如何利用此类规范化数据提升韩语LLM的跨语言理解能力,特别是在低资源语言与高资源语言的平衡表征方面。随着全球多语言模型需求的增长,该数据集为探索韩语在代码生成、科学文献处理等专业领域的应用提供了重要支撑,推动了亚洲语言模型生态的多元化发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

