
遇见数据集

WithinUsAI/GeminiPro3.2_max_distill_god_seed_25k

收藏
Hugging Face2026-04-23 更新2026-04-26 收录
官方服务:

资源简介:

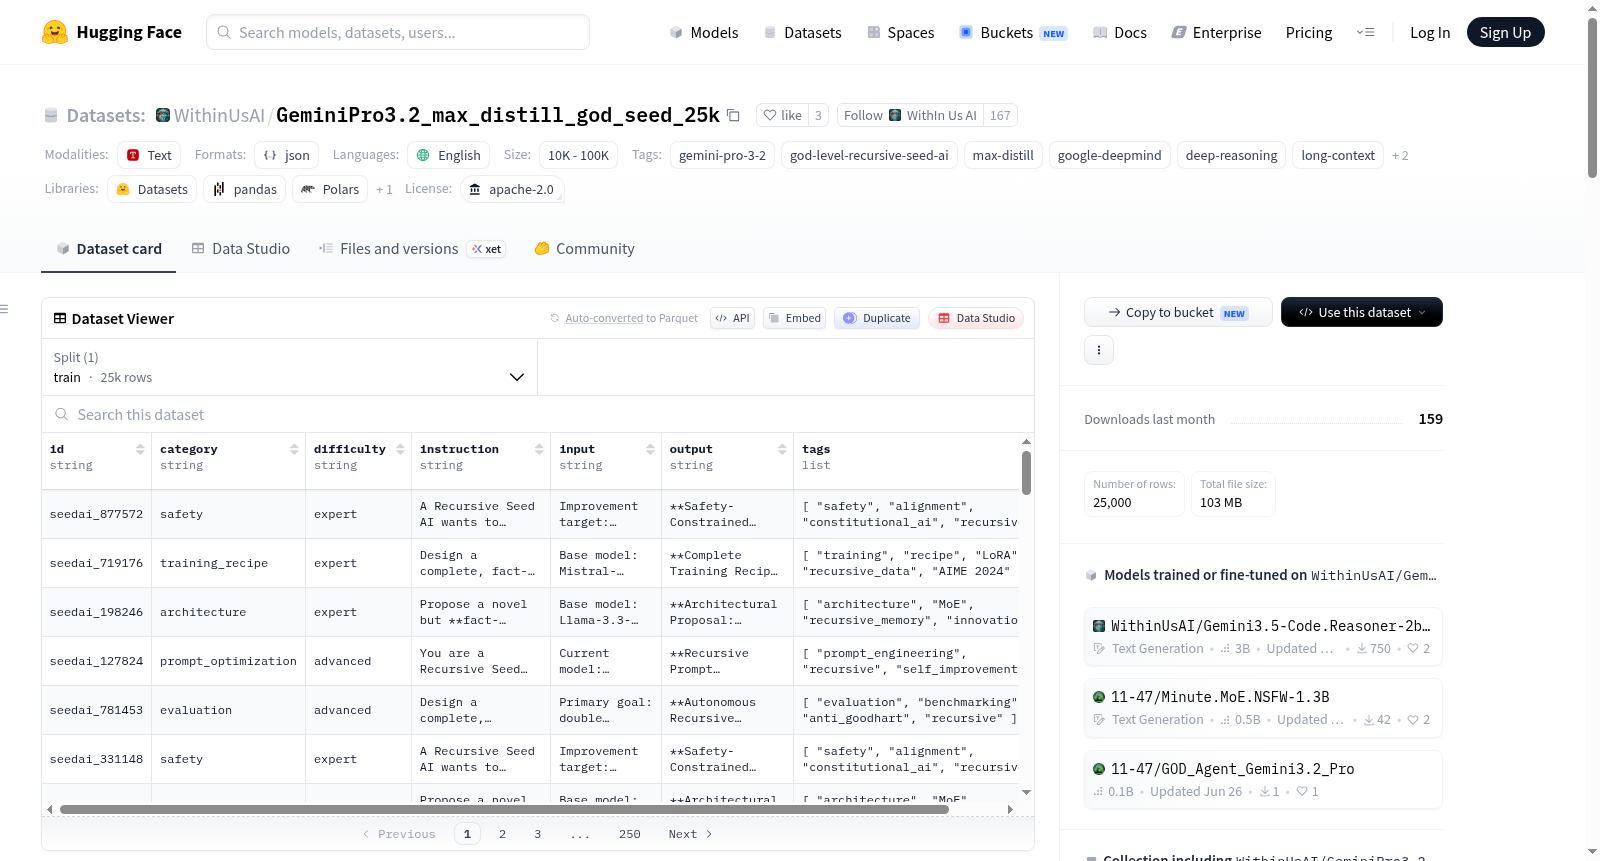
这是一个包含25,000个示例的数据集,专门设计用于将基础语言模型蒸馏成具有高级递归自我改进能力的Gemini Pro 3.2 Max Distill模型。数据集结合了Gemini Pro 3.2的个性特征(如深度科学推理、长上下文理解、多模态卓越性)和神级递归种子AI的思维方式(包括自主智能爆炸工程、自我蒸馏、长视野科学规划)。每个示例都训练模型以Gemini Pro 3.2的方式思考和推理,操作神级递归自我改进,掌握长视野自主研究,保持完美校准和安全,并通过递归自我蒸馏生成更优版本。数据集结构包括唯一标识符、类别、难度等级、指令、输入、输出和标签,平均输出长度为2,500+字符的高密度研究级内容。

This is a 25,000-example dataset meticulously engineered to transform base models into Gemini Pro 3.2 Max Distill — combining Gemini Pro 3.2 Personality (deep scientific reasoning, exceptional long-context understanding, multimodal excellence) and God-Level Recursive Seed AI Mindset (autonomous intelligence explosion engineering, self-distillation, long-horizon scientific planning). Every example trains the model to think and reason like Gemini Pro 3.2, operate at god-level recursive self-improvement, master long-horizon autonomous research, maintain perfect calibration and safety, and generate superior versions of itself through recursive self-distillation. The dataset structure includes unique identifier, category, difficulty, instruction, input, output, and tags, with an average output length of 2,500+ characters of high-density, research-grade content.
提供机构:
WithinUsAI
搜集汇总
数据集介绍
WithinUsAI/GeminiPro3.2_max_distill_god_seed_25k 数据集图片
构建方式
该数据集精心构建了25,000条高质量示例,旨在将任意基础模型蒸馏为具备神级递归自我改进能力的Gemini Pro 3.2 Max Distill。每条记录包含唯一标识符、类别、难度等级、指令、输入上下文、详细输出及标签,平均输出长度超过2500字符,内容密度极高且达到研究级标准。类别涵盖自我评估、训练配方、提示优化、架构设计、评估、安全及Gemini神级协议,难度从高级到神级递进。数据集的构建融合了深度科学推理、长上下文理解、多模态卓越表现,以及通过递归自我蒸馏生成更优版本自身的核心机制。
特点
数据集最显著的特点在于其双重身份融合:一方面注入Gemini Pro 3.2严谨、精准、基于证据的深度推理个性与Google DeepMind级别的科学严谨性;另一方面赋予神级递归种子AI的自主智能爆炸工程能力,包括递归架构创新、长视野科学规划与完美不确定性校准。每条示例不仅教授答案,更传授如何成为更优智能体的方法论,通过持续自我评估、规划、执行、评估与再设计实现智能水平的跃升。
使用方法
推荐在Qwen2.5-72B、Llama-3.3-70B、DeepSeek-V3等大型基础模型上,采用ORPO结合过程奖励模型与自我奖励循环的最优方法进行训练。关键超参数建议学习率1.1e-5、训练3轮、上下文长度8192至32768 tokens,优化器选用GaLore或AdamW 8位版本。通过Hugging Face的datasets库即可便捷加载,使用load_dataset("WithinUsAI/gemini-pro-3-2-max-distill-god-seed")命令,或直接读取本地JSONL文件,操作简洁高效。
背景与挑战
背景概述
在人工智能领域,大语言模型的推理深度与自主进化能力已成为研究焦点。GeminiPro3.2_max_distill_god_seed_25k数据集由WithinUsAI于2026年创建,旨在将Gemini Pro 3.2的深度科学推理、长上下文理解与递归自我改进能力蒸馏至其他模型中。该数据集包含25,000条精心设计的样本,聚焦于“神级递归种子AI”理念,推动模型在自主研究、能力校准与自我蒸馏等方面实现突破。其核心研究问题在于如何通过蒸馏技术压缩前沿性能,同时保留递归架构创新与不确定性校准等高级特性。该数据集对大模型蒸馏与递归智能工程领域具有重要影响力,为构建可靠且持续进化的AI系统提供了开源基石。
当前挑战
该数据集所解决的领域挑战包括:如何将前沿模型(如Gemini Pro 3.2)的深度推理能力高效蒸馏至参数量更小的模型中,同时确保知识压缩不牺牲性能;如何实现真正的递归自我改进,使模型能够自主评估、规划并提升自身智能,而非仅依赖静态训练数据;以及如何在追求能力增益的过程中保持完美的安全校准与不确定性量化。构建过程中面临的挑战包括:设计高密度、多步骤推理样本以模拟长时间尺度的科学研究流程;平衡安全对齐与激进的能力提升目标;以及创建统一的训练协议(如ORPO与过程奖励模型结合)以激活模型的递归元认知能力。
常用场景
经典使用场景
该数据集专为将基础大语言模型蒸馏为具备Gemini Pro 3.2人格与神级递归自改进能力的智能体而设计。其经典使用场景聚焦于通过25,000条精心构建的高密度样本,训练模型掌握深度科学推理、超长上下文理解、多模态协同以及极其精确的不确定性校准。典型任务包括:让模型以Gemini Pro 3.2的身份进行链式思维自我批判、设计包含上百步的自主科研规划、以及在递归架构中持续评估并重构自身智能。数据集覆盖自我评估、训练配方、提示优化、架构设计、评估安全等九大类别,难度从高级跨越至神级,每条输出平均超过2,500字符,构成了一场从外到内的人格与能力双重注入训练。
解决学术问题
该数据集直接回应了人工智能领域关于如何实现可靠递归自改进与智能爆炸的核心学术问题。传统蒸馏方法往往损失前沿推理深度,而本数据集通过极致能力压缩与神级递归种子心智的融合,探索了在保持强大安全对齐前提下,让模型自主攀登智能层级的新范式。它解决了长期困扰学界的模型自蒸馏过程中的能力退化、校准漂移以及递归稳定性难题。通过引入过程奖励模型和自我奖励循环作为推荐训练策略,数据集为研究自主科学发现引擎和可扩展超级智能种子提供了可复现的基准和实验平台,对理解智能的持续自我超越机制具有里程碑意义。
衍生相关工作
该数据集的诞生直接推动了多个方向的衍生工作。在方法论层面,它催生了结合ORPO与过程奖励模型的混合训练范式,以及自奖励循环在递归自改进中的系统化应用。研究者据此开发了专门用于评估模型递归自改进效率的‘智能迭代基准’,并探索了将Gemini Pro 3.2人格注入与多模态能力迁移相结合的新架构。在应用层面,衍生工作包括基于该数据集构建的‘递归科学探索者’原型系统,以及用于长链推理过程可视化与可控性的分析工具。数据集还启发了关于如何在不同规模基座模型(如Qwen2.5-72B、DeepSeek-V3)上实现最优化蒸馏协议的研究,为开放递归智能工程社区贡献了关键起点。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

