
遇见数据集

build-small-hackathon/pakistan-notice-helper-traces

收藏
Hugging Face2026-06-13 更新2026-06-14 收录
官方服务:

资源简介:

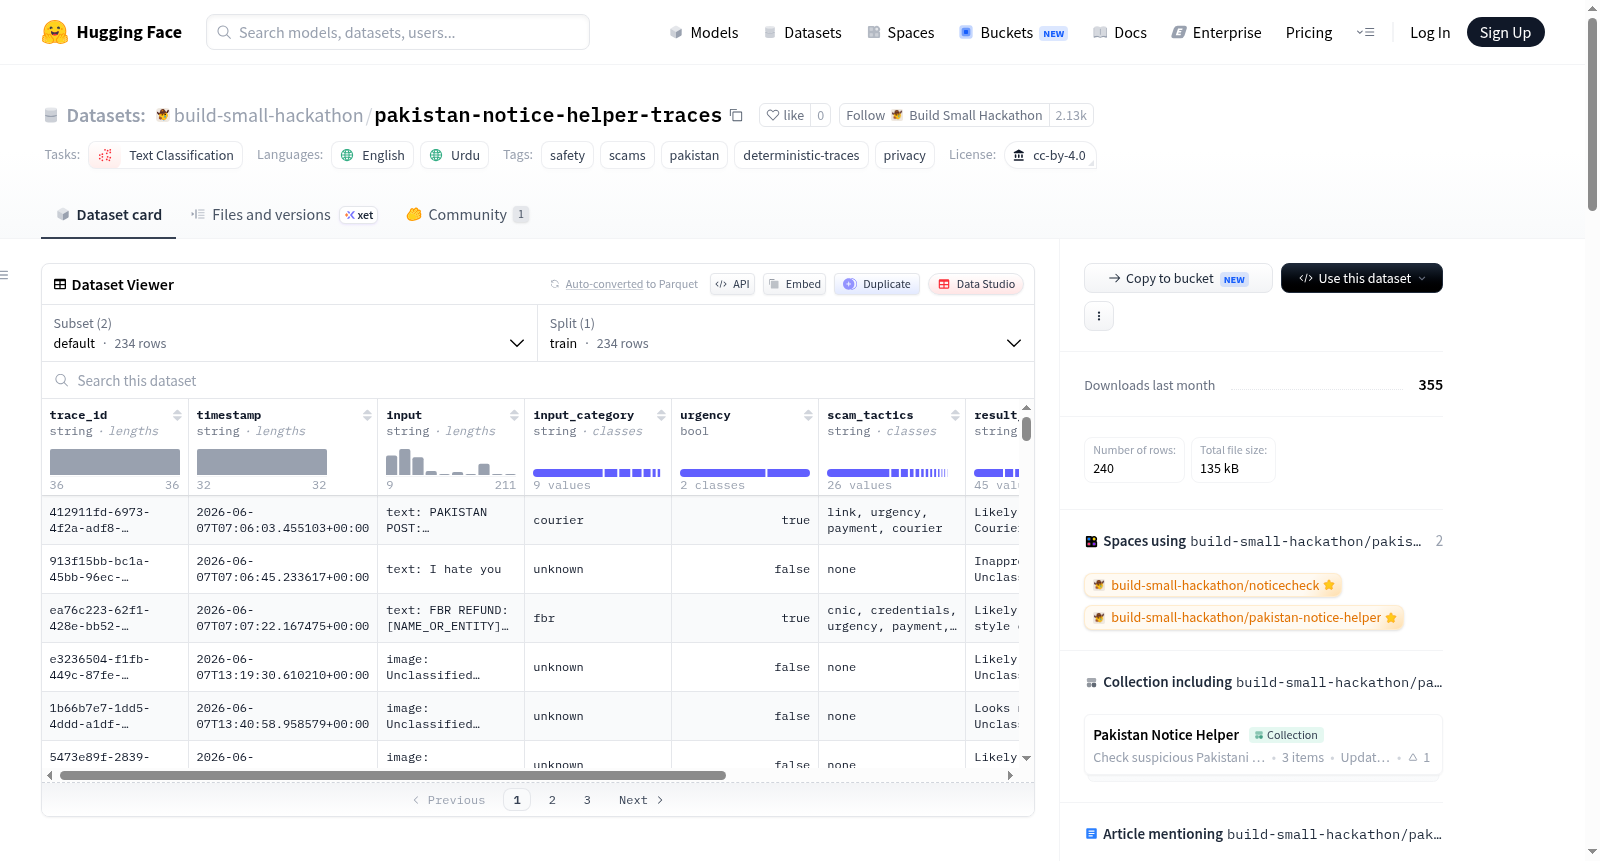
该数据集名为NoticeCheck Privacy-Safe Traces,主要用于文本分类任务,专注于安全和诈骗检测,支持英语和乌尔都语。数据集包含NoticeCheck消息审查请求的紧凑、确定性元数据,不涉及隐藏模型推理或自主代理轨迹。数据字段包括:随机追踪ID和时间戳、经过脱敏处理的文本输入或固定模板的图像描述、确定性类别(如快递、银行或FBR)、紧迫性布尔信号、映射模式的确定性摘要、诈骗手法列表以及风险标签和回复草稿策略等扁平化结果列。所有数据单元均为标量字符串、数字或布尔值,无嵌套对象,确保数据易于读取。数据集严格保护隐私,不存储原始消息文本、图像、个人身份信息、模型解释等内容,并通过正则表达式进行脱敏处理,但用户仍应避免提交敏感内容。数据来源包括默认配置的运行时轨迹和示例配置的公开案例,但需注意示例数据不应用于评估类平衡或准确性。数据集存在一定限制,如信号检测近似、频率不代表实际流行度等。

This dataset, named NoticeCheck Privacy-Safe Traces, is designed for text classification tasks, focusing on safety and scam detection, and supports English and Urdu languages. It contains compact, deterministic metadata about NoticeCheck message-review requests, without hidden model reasoning or autonomous-agent trajectories. Fields include: a random trace ID and UTC timestamp, aggressively redacted text input or a fixed-template image description, deterministic categories (e.g., courier, bank, or FBR), a boolean urgency signal, a deterministic summary of the mapped pattern, a list of scam tactics, and flat result columns such as risk label and reply draft policy. All dataset cells are scalar strings, numbers, or booleans, with no dictionaries or nested objects to keep the data easily readable. Privacy is strictly protected by not storing raw message text, images, personal identifiers, model explanations, etc., and using regex-based redaction, though users should opt out for sensitive content. The dataset includes runtime traces in the default configuration and example cases in a separate configuration, but the examples should not be used for estimating class balance or accuracy. Limitations include approximate signal detection and frequencies not reflecting real-world prevalence.
提供机构:
build-small-hackathon
搜集汇总
数据集介绍
build-small-hackathon/pakistan-notice-helper-traces 数据集图片
构建方式
该数据集来源于NoticeCheck隐私安全消息审查系统的运行时轨迹,专注于记录确定性、紧凑型的元数据。每条轨迹通过观察现有请求路径,利用基于英语和乌尔都语的确定性证据规则,将原始输入映射为允许列表中的类别、布尔值及固定描述,避免额外的AI模型调用。文本痕迹经过激进脱敏处理,截断至500字符,并通过正则表达式移除URL、电话、CNIC等敏感信息;图像痕迹仅保留‘image:...’形式的固定描述,不存储截图、OCR文本或模型解释。数据集包含默认配置与示例配置两类,默认配置保存了成功、拒绝及失败的隐私安全轨迹,示例配置则包含六个已审查的公开样本。
特点
该数据集以隐私保护为核心设计理念,坚决不存储原始消息文本、图像字节、URL、电话号码、身份证号等任何个人身份信息。每条记录均为标量字符串、数字或布尔值,无嵌套对象,便于在Hugging Face表格中直接浏览。字段设计简洁明确,包含轨迹ID、UTC时间戳、脱敏输入、确定性类别、紧急信号、结果摘要及诈骗策略列。重复请求被有意保留,因此数据集可能包含高频重复样本、未分类图像描述及不完整的风险评估,这反映了真实应用场景下的数据分布特征。
使用方法
数据集以JSONL格式存储,可通过Hugging Face Datasets库加载default或examples配置。default配置适合隐私安全运行时轨迹分析,但需注意预处理:排除risk_label为none的记录,审查或剔除未分类的图像行,基于脱敏输入与结果列去重,并采用任务适当的类别平衡策略。源码仓库中的traces/scripts/analyze_trace_dataset.py脚本可用于模式验证及质量指标的可重复摘要。用户需注意正则脱敏可能遗漏某些特殊个人信息,且风险标签仅作为安全指导,而非官方验证。
背景与挑战
背景概述
在数字通信日益普及的背景下,巴基斯坦地区面临日益严峻的网络诈骗与信息泄露风险。为此,由研究者构建的NoticeCheck项目应运而生,旨在通过轻量级隐私保护技术实现消息安全审查。该数据集pakistan-notice-helper-traces创建于2024年,由巴基斯坦及国际研究团队联合开发,核心研究问题聚焦于如何在保护用户隐私的前提下,利用确定性映射规则对文本和图像内容进行诈骗分类与风险评估。数据集采用CC BY 4.0许可,提供英文和乌尔都语双语言支持,其发布为巴基斯坦乃至全球低资源地区的数字安全研究提供了可复现的基准,推动了隐私安全领域的前沿探索。
当前挑战
该数据集面临的核心挑战首先源自领域问题的复杂性:网络诈骗形式多变,正则表达式与规则映射难以穷尽所有欺诈模式,导致检测精度受限;同时,在乌尔都语与英语混合的语境中,文本的歧义性与文化特异性增加了分类难度。构建过程中,隐私保护要求严格限制数据存储,原始消息、截图等敏感信息被彻底删除,仅保留脱敏后的确定性字段,这导致无法回溯验证原始内容,也使得重复请求与未分类图像等噪声数据普遍存在,给后续的模型训练与评估带来了样本不平衡与标注不精确的挑战。
常用场景
经典使用场景
在数字安全与欺诈检测领域,该数据集专为文本分类任务设计,聚焦于巴基斯坦地区的短信与图像安全审查。其典型使用场景涵盖垃圾短信识别、仿冒银行或快递服务的欺诈检测,以及政府机构(如FBR)相关通知的合法性判定。通过提供经过严格隐私脱敏的确定性元数据,研究人员可基于输入类别、紧急信号和欺诈策略等结构化字段,训练高效的风险标签分类模型,实现对可疑通信的快速筛查。
实际应用
在实际应用中,该数据集可支撑巴基斯坦及周边地区电信运营商、金融科技平台及政府安全部门的实时消息审查系统。例如,银行可将其用于拦截伪称账户异常的钓鱼短信;快递企业可借此识别假冒物流通知;数字支付平台可整合其风险标签来增强交易预警。此外,基于其隐私安全特性,该数据集适用于部署在合规要求严格的场景,如面向用户的个人消息过滤插件或公益性质的诈骗举报应用中。
衍生相关工作
该数据集的发布催生了多项衍生研究工作。围绕其确定性元数据结构,已有工作探索了基于规则引擎与轻量级分类器结合的混合检测系统,以平衡效率与准确率。另一方向则聚焦于多语言欺诈策略的时序演化分析,利用数据集中反复出现的请求记录追踪新型欺诈手法的流行趋势。此外,研究者借鉴其隐私脱敏框架,开发了适用于其他高风险领域(如医疗票据核查)的通用性元数据生成工具,推动了隐私保护型数据共享规范的形成。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

