
遇见数据集

namakoo/idfu-generalization-specialty

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

IDFU泛化(Transformers)专业包是一个专注于高级泛化和过拟合缓解的Python失败数据集,旨在作为IDFU代码失败数据集家族的低成本入门点。该数据集包含87个样本,其中10个样本可免费预览。数据集面向ML训练工程师,用于训练ML训练管道错误分类器、DPO拒绝侧数据以及代码审查微调等任务。数据集通过严格的QA管道进行验证,并包含详细的数据字段模式。数据集采用Apache 2.0和CC-BY-NC-4.0双重许可。

The IDFU Generalization (Transformers) Specialty Pack is a single-domain Python failure dataset focused on advanced generalization and overfitting mitigation in transformers, designed as a low-cost entry point to the IDFU Code Failure Dataset family. The dataset includes 87 samples, with a free preview of 10 samples available. It is intended for ML training engineers and is used for tasks such as training an ML training pipeline error classifier, DPO rejected-side data, and code review fine-tuning. The dataset is validated through a rigorous QA pipeline and includes a schema detailing each field in the data. The dataset is licensed under Apache 2.0 and CC-BY-NC-4.0.
提供机构:
namakoo
搜集汇总
数据集介绍
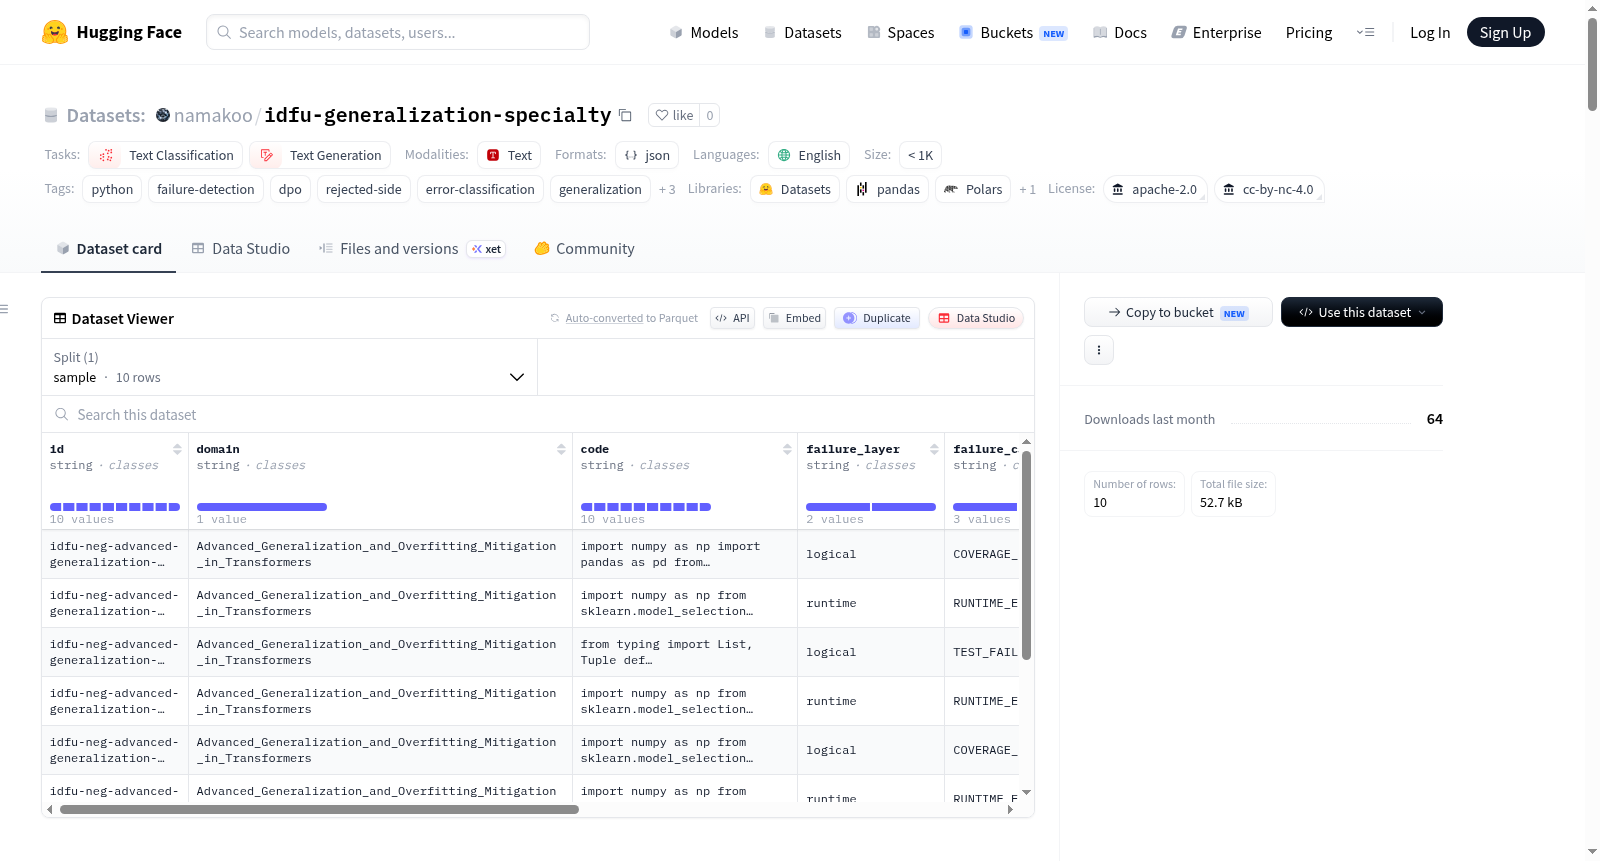
namakoo/idfu-generalization-specialty 数据集图片
构建方式
该数据集聚焦于Transformer模型训练中的泛化与过拟合缓解领域,通过严格的验证流程构建了87个高质量样本。每个样本均源自Python源代码,经过容器化执行与pytest测试框架的真实运行,捕获了从语法到语义的六类失败层(如运行时错误、逻辑错误等)。数据构建采用α归一化AST哈希去重机制,确保样本间无冗余,并经过静态lint门控与专有内部QA流水线的多阶段筛选,最终形成指令配对、错误日志完备的标准化JSONL格式。
特点
作为IDFU代码失败数据集家族的专精包,其核心优势在于100%领域聚焦于Transformer管道中的泛化与过拟合缓解的典型错误模式,如配置验证疏漏、数据加载维度的不匹配以及注意力掩码的偏移等。所有样本均附带真实的pytest执行轨迹与原始任务指令,兼具DPO负例训练的天然适配性。同时,该数据集采用与主版本相同的v3.0验证证书体系,通过AST哈希唯一性保证与先前版本无重叠,提供了低门槛、高信噪比的入门级训练数据。
使用方法
该数据集主要面向机器学习训练工程师,适用于构建针对Transformer微调代码的ML训练管道错误分类器、作为DPO负例数据以抑制常见的过拟合缓解实现缺陷,或用于代码审查模型的微调。使用时可直接加载JSONL或Parquet文件,每条记录包含id、领域、代码、失败层等结构化字段,便于与HuggingFace Datasets库集成。由于该数据集仅提供负例,用户需自行搭配偏好数据集进行DPO训练。购买前可通过免费预览样本评估数据质量与领域契合度。
背景与挑战
背景概述
在深度学习模型训练中,过拟合与泛化能力的失衡始终是制约模型性能的关键瓶颈,尤以Transformer架构为甚。为系统性地探究此类问题,IDFU研究团队在2025年左右推出了以故障检测为核心的数据集系列,其中IDFU Generalization (Transformers) Specialty Pack由开发者namakoo发布,聚焦于Transformer训练流程中由过拟合缓解策略不当引发的代码级错误。该数据集包含87个经过严格验证的Python代码样本,覆盖语法、运行时、逻辑等多个故障层,旨在为机器学习工程师提供训练专用故障分类器与DPO负例数据的低成本切入点,从而推动代码质量与模型鲁棒性的交叉研究。
当前挑战
该数据集所应对的核心挑战在于,现有通用代码错误数据集难以精准捕获Transformer训练中特有的故障模式,例如丢弃层参数误配、注意力掩码越界、数据预处理管线与模型输入维度的不兼容等,这些故障在训练场景下具有高度领域特异性。构建过程中,数据需通过α归一化AST哈希去重及容器化Python执行测试确保样本独特性与故障真实性,同时需屏蔽商业敏感的内部验证逻辑,在样本颗粒度与知识产权保护之间取得平衡。此外,作为付费入门产品,如何在有限样本量下维持与主流版本相同的质量保证标准,并降低购买者的评估风险,亦是其面临的结构性挑战。
常用场景
经典使用场景
该数据集聚焦于Transformer模型训练中的泛化与过拟合缓解领域,专为小规模、低风险的实验设计。其经典使用场景包括训练面向ML训练管道错误的分类器,精准识别Transformer微调代码中的配置验证缺陷、模块误用及数据加载异常。同时,它可作为DPO训练中的拒绝侧数据,有效抑制常见的过拟合缓解实现错误,如dropout配置失当、注意力掩码偏差等。此外,该数据集还适用于代码审查模型的微调,特别针对HuggingFace Transformers、PyTorch Lightning等框架的ML训练笔记本,帮助模型习得识别并纠正泛化相关代码缺陷的能力。
解决学术问题
该数据集旨在解决机器学习训练中代码质量与泛化能力评估的学术难题。传统基准多关注正确代码,而该数据集专注于真实执行失败的Python代码,覆盖语法、运行时、逻辑、语义等多种失效层。它填补了Transformer训练管道中过拟合缓解策略实现错误的系统性标注空白,为研究代码级抗过拟合技术提供了可复现的失败样本库。通过结构化标注失效类别与详细运行日志,它支持对泛化失效模式的定量分析,推动从经验性调参向可诊断的代码级优化研究范式转变。
衍生相关工作
该数据集是IDFU代码失败数据集家族的一部分,其衍生工作包括同一验证流水线下的多领域覆盖版本,如v1、v2、v3主发布(各2000样本,覆盖19个领域)及其他专精包(如向量搜索、量化交易领域)。独立的基准测试显示,基于500样本的蒙特卡洛领域DPO训练显著提升了Qwen2.5-Coder-3B-Instruct在HumanEval上的pass@1指标(+3.46个百分点),尽管该结果不直接转移至此专精包。这些衍生工作验证了基于真实执行失败数据的DPO训练能有效改善代码生成模型的行为模式,为构建更鲁棒的代码智能系统奠定了基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

