
TencentBAC/HyLaR_RL_Training_Dataset
收藏官方服务:
资源简介:
该数据集旨在训练多模态大语言模型(MLLMs),在强化学习阶段使用解耦策略优化(DePO)框架执行混合潜在推理,使模型能够交错离散的文本思维链步骤和连续的视觉潜在状态来解决复杂多模态任务。
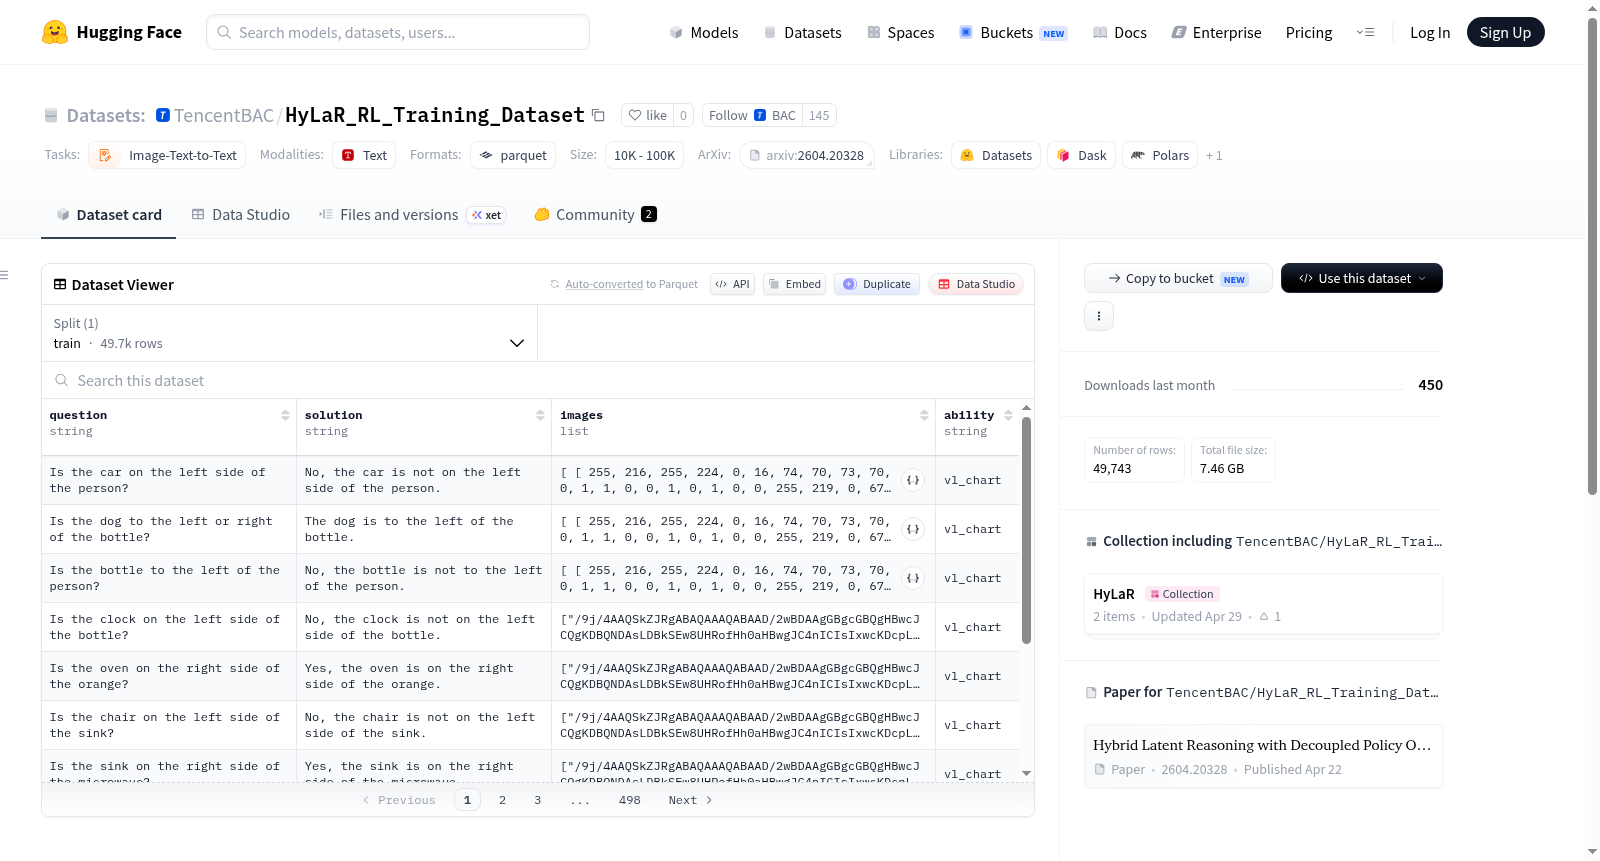
This dataset is designed for training Multimodal Large Language Models (MLLMs) to perform hybrid latent reasoning using the Decoupled Policy Optimization (DePO) framework during the Reinforcement Learning stage. It enables the model to interleave discrete textual chain-of-thought steps with continuous visual latent states to solve complex multimodal tasks.
提供机构:
TencentBAC搜集汇总
数据集介绍
构建方式
HyLaR_RL_Training_Dataset是为支撑混合潜在推理框架HyLaR中的强化学习阶段而精心构建的。该数据集依托于解耦策略优化(DePO)框架,旨在训练多模态大语言模型(MLLMs)在复杂多模态任务中实现推理过程的革新。其构建方式融合了离散文本思维链与连续视觉潜在状态的交织机制,通过将两个异质推理空间统一于强化学习流程,使得模型能够在逐步语言推理的同时,动态利用视觉特征中的连续表示。这一设计不仅扩展了传统推理数据集的维度,还通过与Qwen2.5-VL-7B等模型检查点的协同,确保了数据与模型的适配性与训练效率。
特点
该数据集的核心特点在于其对多模态推理中异质状态融合的创新支持。与传统仅依赖文本或视觉通道的数据集不同,HyLaR_RL_Training_Dataset允许模型在单一训练过程中交替使用离散的逻辑推理步骤与连续的视觉潜在表示,从而在推理深度与计算开销之间取得平衡。此外,数据集基于解耦策略优化框架设计,将策略优化与价值函数更新解耦,提升了强化学习训练中的稳定性与收敛速度。其与HyLaR-Qwen2.5-VL-7B的紧密关联,也确保了训练数据与模型架构的高度协同,为复杂视觉问答、图表解析等任务提供了有力的训练基础。
使用方法
使用HyLaR_RL_Training_Dataset时,研究者需预先部署HyLaR框架与相关模型检查点。数据集适用于多模态大语言模型的强化学习训练阶段,用户应将其与HyLaR-Qwen2.5-VL-7B等模型配合,通过解耦策略优化算法进行训练。具体而言,数据中的文本及视觉输入被组织为可交替采样的序列,训练过程中需实现离散思维链步骤与连续视觉状态的动态切换。建议参考HyLaR论文及GitHub仓库中的示例代码,以正确加载数据并配置强化学习环境。该数据集可直接通过HuggingFace平台下载,并支持与主流深度学习框架的集成。
背景与挑战
背景概述
HyLaR_RL_Training_Dataset由腾讯人工智能实验室(TencentBAC)于2025年提出,旨在服务于多模态大语言模型(MLLMs)的强化学习训练。该数据集基于论文《HyLaR: Hybrid Latent Reasoning with Decoupled Policy Optimization》构建,核心研究问题在于如何使模型在复杂多模态任务中有效融合离散文本推理链与连续视觉隐状态。通过引入解耦策略优化(DePO)框架,该数据集为MLLMs的混合潜推理能力提供了关键训练资源,推动了多模态推理从单一模态向跨模态协同理解的范式转变,对视觉-语言理解领域具有重要影响。
当前挑战
该数据集所解决的领域挑战主要源自多模态推理中离散符号与连续表征的天然鸿沟:传统方法难以在不牺牲推理效率的前提下,实现文本逻辑与视觉语义的深度交互。构建过程中面临的挑战包括:设计混合推理的动作空间与奖励函数以平衡离散与连续决策流,确保强化学习训练的稳定性;同时需构建覆盖视觉问答、图表理解等多样化场景的高质指令数据,以激发模型在复杂任务中的泛化推理能力,避免过拟合到单一模态特征。
常用场景
经典使用场景
该数据集专为多模态大语言模型(MLLMs)的强化学习训练而设计,旨在通过解耦策略优化(DePO)框架,引导模型在推理过程中灵活交织离散文本思维链与连续视觉潜在状态。研究者可借助该数据集,训练模型在视觉问答、图文推理及多模态对话等任务中,有效融合语言符号与视觉信息,从而提升复杂场景下的语义理解与逻辑推导能力。
衍生相关工作
围绕HyLaR数据集,衍生出了一系列经典工作,包括基于解耦策略优化的多模态强化学习框架DePO,以及其代表模型HyLaR-Qwen2.5-VL-7B。此外,研究者还进一步探索了混合潜在推理在图文故事生成、多模态实体锚定等方向的应用。这些工作共同推动了将强化学习引入多模态层级推理的前沿研究,为后续跨模态认知建模奠定了坚实基础。
数据集最近研究
最新研究方向
HyLaR_RL_Training_Dataset 聚焦于多模态大语言模型(MLLMs)的混合潜在推理能力增强,通过结合离散文本思维链与连续视觉潜在状态,在强化学习阶段采用解耦策略优化(DePO)框架,推动模型在复杂多模态任务中实现更优的推理效率与准确性。该数据集响应了当前多模态智能体研究中对可解释性与计算效率双重要求的前沿趋势,为突破传统思维链推理在视觉-语言任务中的局限性提供了关键训练资源。其研究意义在于探索了一种新的推理范式,有望在视觉问答、机器人操控等需要深度语义理解与动态规划的热点领域产生深远影响。
以上内容由遇见数据集搜集并总结生成


