
VerboVision/cem_mil_pares_5k_pt_2
收藏官方服务:
资源简介:
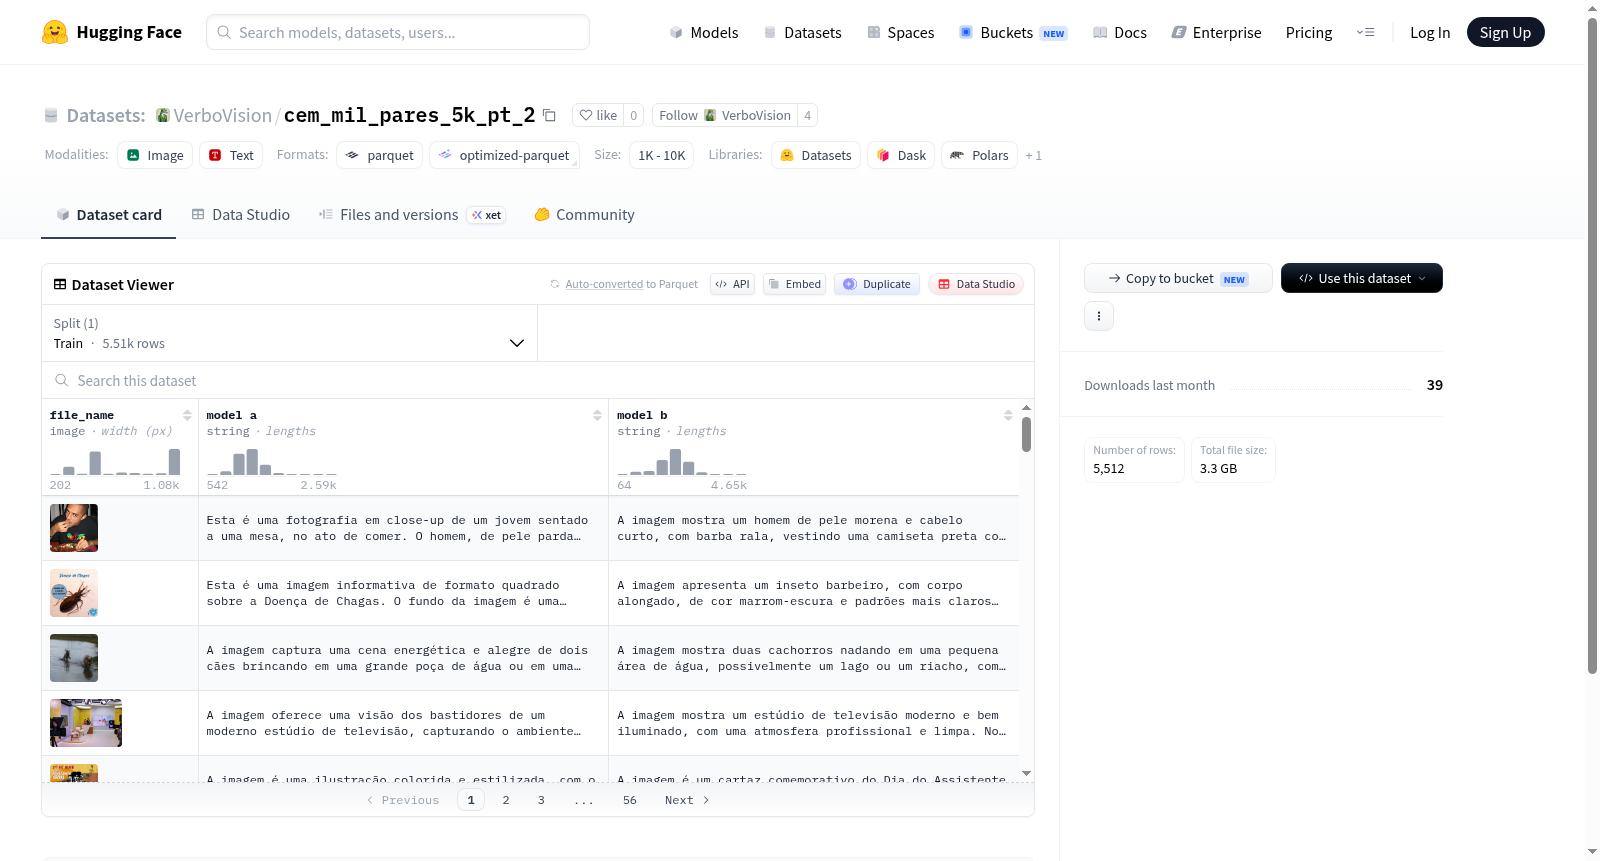
该数据集是一个图像数据集,包含5512个训练样本,每个样本包括一个图像文件(file_name)和两个字符串字段(model a和model b)。数据集总大小约为3.31 GB,下载大小约为3.30 GB,仅提供训练分割。
This dataset is an image dataset containing 5512 training examples, each consisting of an image file (file_name) and two string fields (model a and model b). The total dataset size is approximately 3.31 GB, with a download size of about 3.30 GB, and it includes only a training split.
提供机构:
VerboVision搜集汇总
数据集介绍
构建方式
该数据集名为cem_mil_pares_5k_pt_2,以葡萄牙语语境下的图像-文本对为核心构建而成。每一条样本包含一个图像字段(file_name,类型为image)以及两个文本字段(model a和model b,均为字符串类型),形成三元组结构。数据集的构建旨在为多模态对比学习或图像文本匹配任务提供基础,训练集共收录5512个样本,整体数据规模约为3.3GB,确保了样本多样性。
特点
数据集的一大特点在于其双文本字段设计,即同一图像对应两个不同的文本描述(model a和model b),这种结构天然适用于度量学习、排序学习或评估不同文本生成模型输出质量等场景。所有样本统一划分至训练集,无验证或测试分割,便于研究者灵活组织交叉验证或自定义划分策略。图像与文本的配对均经过筛选,以保障语义关联的一致性。
使用方法
使用者可通过HuggingFace Datasets库加载该数据集,指定config为default并指向data/Train-*路径下的数据文件。加载后,image字段可直接解码为PIL图像对象,而model a和model b字段为字符串,可直接用于文本编码器的输入。数据集支持常见的transformations应用,如调整图像尺寸或进行文本分词,适合用于对比学习模型的训练与评估流程。
背景与挑战
背景概述
在视觉与语言模型日益融合的背景下,对生成图像与真实图像的精确区分成为计算机视觉领域的重要课题。cem_mil_pares_5k_pt_2数据集由巴西的科研团队于近年创建,旨在为葡萄牙语环境下的图像-文本匹配任务提供高质量的标注资源。该数据集包含5512个训练样本,每对样本由一张图像和两个候选文本描述组成,其中一个描述与图像语义一致,另一个则存在细微差异,核心研究问题聚焦于如何提升模型在细粒度语义理解上的鲁棒性。其发布填补了非英语语言场景下多模态细粒度评测数据的空白,对推动多语种人工智能系统的发展具有重要参考价值。
当前挑战
该数据集直面细粒度多模态语义理解的领域难题,即要求模型不仅识别图像中的物体,还需捕捉物体属性、关系及语境中的微妙差异,这对现有视觉语言模型构成了显著挑战。在构建过程中,团队面临双重困难:一是需要确保两个候选文本在语法正确的前提下设计出具有迷惑性的语义差异,这对标注人员的语言敏感度要求极高;二是图像来源的多样性与质量参差不齐,导致部分样本中的语义线索隐藏于光照、角度等视觉噪声中,增加了人工标注的一致性与客观性保障难度。这些挑战使得数据集在评测模型细粒度理解能力时具有独特的难度梯度。
常用场景
经典使用场景
在计算机视觉与多模态学习的交汇领域,cem_mil_pares_5k_pt_2数据集以其精心构造的图像-文本对结构,成为评估和提升视觉语言模型(如CLIP)在细粒度语义理解任务上性能的标杆。该数据集通过提供模型A与模型B的双重文本标注,使得研究者能够深入探究模型对图像内容中细微差异的感知能力,常用于训练和测试模型在图像匹配、跨模态检索及视觉释义等经典场景中的表现。
实际应用
在实际应用中,该数据集训练出的模型可被部署于需要高度语义匹配的场景,例如电商平台的商品图像与描述自动对齐、基于自然语言的图像编辑与生成、以及医疗影像中具有细微差别的病灶检索。其双标注机制尤其适用于跨语言环境下的精准信息检索,帮助构建更智能的内容管理系统,在辅助视觉障碍人士的具身交互系统中也展现出显著潜力。
衍生相关工作
围绕cem_mil_pares_5k_pt_2数据集,衍生出诸多经典工作,包括基于对比学习的细粒度视觉表示蒸馏方法、用于解释模型预测差异的注意力可视化框架,以及利用双文本约束改进图像生成质量的对抗训练策略。这些工作进一步拓展了该数据集在模型可解释性、对抗性鲁棒性以及零样本迁移等前沿研究方向中的应用,推动了多模态领域从单一任务向综合性评估体系的演进。
以上内容由遇见数据集搜集并总结生成


