
WithinUsAI/codegemma_gemini_pro_32_distilled_25k
收藏官方服务:
资源简介:
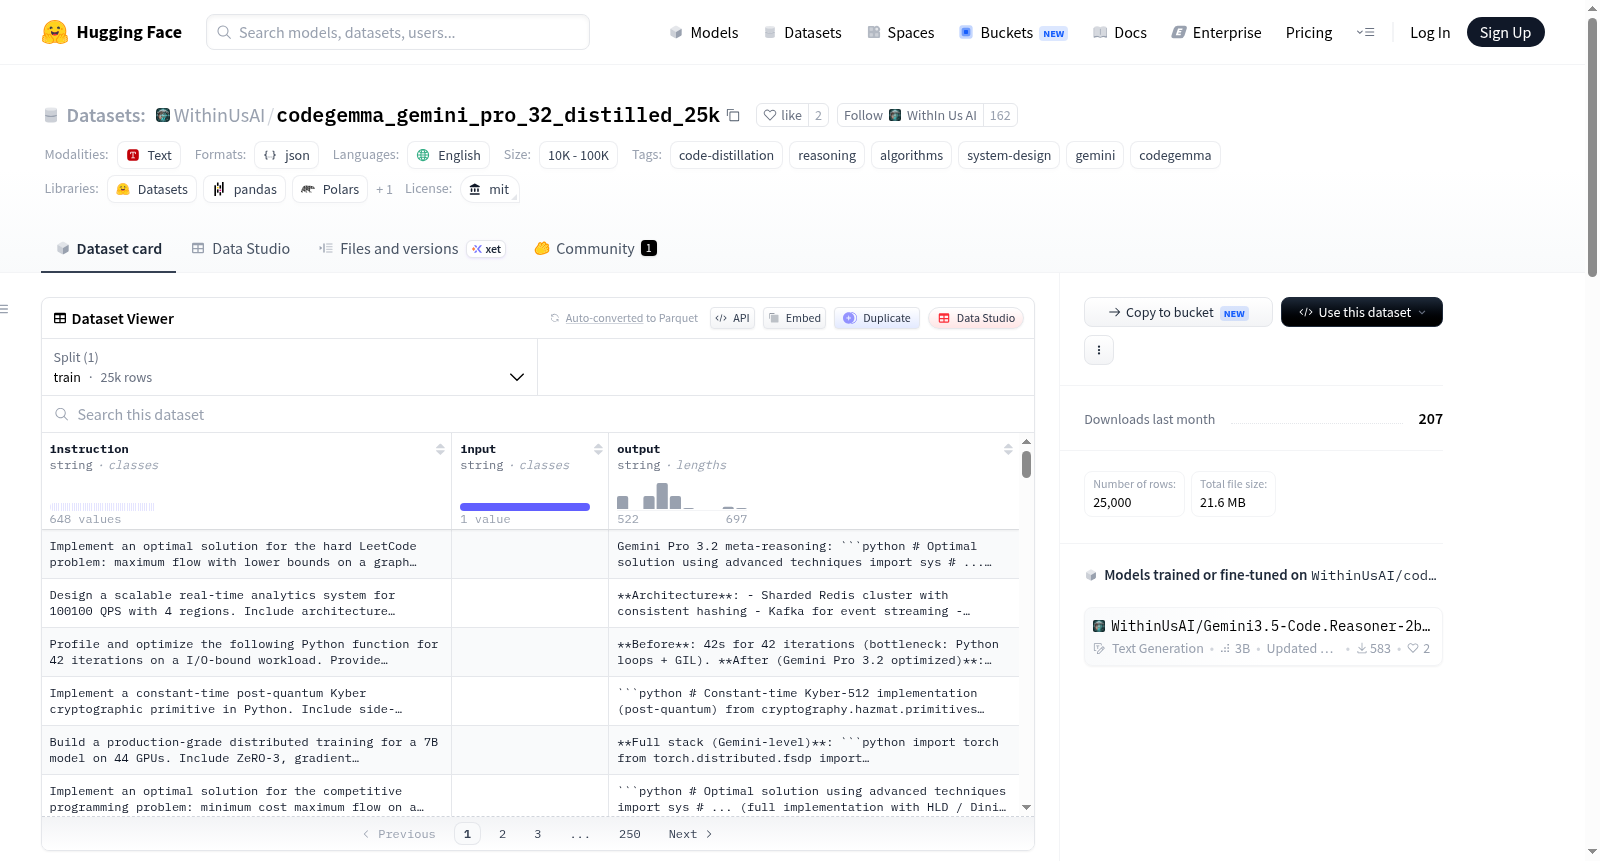
该数据集包含25,000个独特的、生产级的指令-响应对,旨在将Gemini Pro 3.2级别的前沿代码推理能力(包括最优算法、可扩展系统设计、性能工程、安全密码学和大规模机器学习基础设施)提炼到CodeGemma或类似的代码模型中。数据集采用Alpaca格式,涵盖五个平衡领域:高级算法与数据结构(如LeetCode Hard、竞赛编程、图论)、可扩展系统设计(如分布式系统、100k+ QPS)、代码优化与性能(如Numba、CUDA、性能分析)、安全与后量子密码学(如恒定时间、形式化验证)、机器学习工程与训练基础设施(如FSDP、LoRA、ZeRO、vLLM)。每个条目均包含多种方法、复杂度分析、边缘案例、安全考虑和完整的可运行代码。
25,000 unique, production-grade instruction-response pairs for distilling Gemini Pro 3.2-level coding intelligence into CodeGemma (or similar code models). Focus: Transfer frontier code reasoning — optimal algorithms, scalable system design, performance engineering, secure cryptography, and large-scale ML infrastructure — into smaller models.
提供机构:
WithinUsAI搜集汇总
数据集介绍
构建方式
该数据集以Alpaca格式构建,包含25,000条独特的、面向生产的指令-响应对,旨在将Gemini Pro 3.2级别的编码智能蒸馏至CodeGemma等小型代码模型中。每个条目均涵盖多种实现方法、复杂度分析、边界案例、安全考量及完整可运行代码,确保内容的深度与实用性。数据来源为Gemini Pro 3.2的教师轨迹,经过精心筛选与去重,以保证每条样本的独特性与工业级导向。
特点
数据集特点在于均衡覆盖五大核心领域,每领域约5,000条样本:高级算法与数据结构、可扩展系统设计、代码优化与性能工程、安全及后量子密码学、机器学习工程与训练基础设施。所有条目均包含前沿代码推理、最优算法、可扩展系统设计、性能优化及安全加密等内容,专注于将前沿编码智慧蒸馏至较小模型,提升其在复杂任务上的表现。
使用方法
使用方法简洁高效,可通过HuggingFace Datasets库加载JSON文件,支持使用Axolotl或TRL SFTTrainer进行微调,特别适用于CodeGemma-7B模型的继续预训练。评估环节可借助HumanEval、MBPP、LiveCodeBench及BigCodeBench等基准数据集进行性能验证,确保蒸馏后的模型在代码生成与推理任务上达到前沿水平。
背景与挑战
背景概述
在大规模语言模型蓬勃发展的时代,代码智能的提炼与迁移已成为提升小型模型推理能力的关键路径。该数据集由Grok于2026年创建,旨在将Gemini Pro 3.2级别的前沿代码推理能力蒸馏至CodeGemma等轻量级模型中。核心研究问题聚焦于如何通过高质量的指令-响应对,实现最优算法设计、可扩展系统架构、性能工程、后量子密码学以及大规模ML基础设施等五大前沿领域的知识转移。数据集包含25,000对生产级样本,为代码蒸馏研究提供了稀缺的、高价值的训练资源,对推动小型代码模型在复杂推理任务上的性能突破具有显著影响力。
当前挑战
数据集所解决的领域问题在于,现有小型代码模型在应对LeetCode Hard级别算法、高并发系统设计、CUDA级代码优化等前沿挑战时,常因知识容量受限而表现欠佳;该数据集通过蒸馏顶级模型的知识,旨在弥补这一能力鸿沟。构建过程中面临的挑战包括:确保每个领域约5,000条样本的深度与多样性,覆盖从算法复杂度分析到后量子密码学形式化验证等专业维度;同时需维持每个样本包含多种解法、性能基准及安全考量,以避免浅层知识重复,并避免引入教师模型潜在的偏见与错误推理。
常用场景
经典使用场景
在代码智能与机器学习交叉融合的前沿领域,CodeGemma至Gemini Pro 3.2蒸馏数据集为研究者提供了25,000条精炼的指令-响应对,专注于将前沿编码推理能力注入轻量级模型。该数据集最经典的场景是用于代码大语言模型的知识蒸馏训练,通过将高容量教师模型(如Gemini Pro 3.2)的深层推理能力迁移至学生模型(如CodeGemma-7B),显著提升小型代码模型的算法设计、系统架构理解和性能优化水平。研究人员常基于此数据集采用参数高效微调技术(如LoRA、QLoRA)或全量微调策略,结合Alpaca格式的专家级问答对,训练出在复杂编程任务上表现优异的紧凑型代码生成模型。
衍生相关工作
该数据集衍生出一系列推动代码智能边界的经典工作,包括基于对比表示蒸馏的代码语义对齐方法、面向算法类问题的思维链蒸馏框架,以及融合安全形式化验证知识的对抗性蒸馏策略。研究者围绕数据集的五大领域分支,发展出专用评估基准如D-CodeBench,专门衡量蒸馏模型在系统设计和密码学实现上的表现。在模型架构方面,相关工作探索了多教师协同蒸馏与渐进式课程学习,通过动态难度调度将复杂知识逐步注入学生模型。更为重要的是,该数据集催生的轻量级代码模型已反向促进代码生成效率理论的发展,促使学术界重新审视模型容量与泛化能力之间的权衡关系。
数据集最近研究
最新研究方向
在代码蒸馏与模型压缩的前沿领域,该数据集聚焦于将Gemini Pro 3.2的尖端编程推理能力高效迁移至轻量级CodeGemma模型,契合业界对高性能小型代码模型日益增长的需求。围绕大语言模型的知识蒸馏、算法优化及系统设计等热点事件,这一25k规模的精炼数据集通过覆盖高级算法、可扩展系统架构、性能工程、安全密码学及大规模机器学习基础设施等五大核心领域,为小型模型注入前沿的代码推理与工程实践能力。其深远意义在于推动代码智能的民主化,使得资源受限环境下的开发与部署能受益于顶级模型的智慧,同时为后续在HumanEval、MBPP等基准上的评估与持续优化奠定了坚实基础。
以上内容由遇见数据集搜集并总结生成


