
DCAgent3/bfcl_parity_a3_rl_DCAgent_inferredbugs_sandboxes_verifier_55_8B_20260526_214919
收藏数据链接:
官方服务:
资源简介:
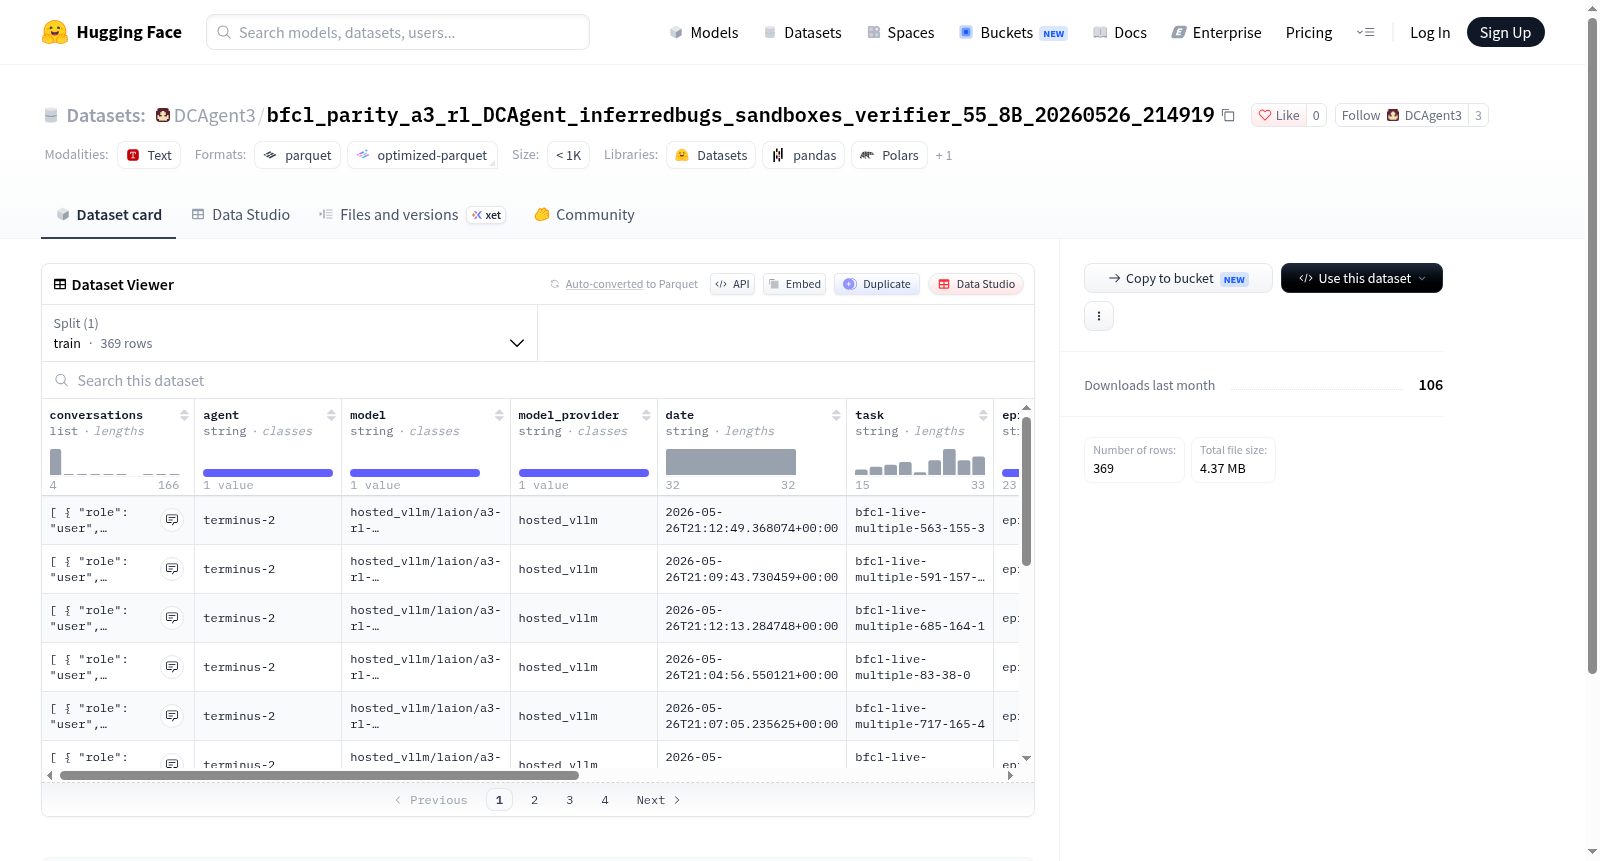
--- dataset_info: features: - name: conversations list: - name: role dtype: string - name: content dtype: string - name: agent dtype: string - name: model dtype: string - name: model_provider dtype: string - name: date dtype: string - name: task dtype: string - name: episode dtype: string - name: run_id dtype: string - name: trial_name dtype: string - name: result dtype: string - name: verifier_output dtype: string splits: - name: train num_bytes: 4512320 num_examples: 369 download_size: 4366527 dataset_size: 4512320 configs: - config_name: default data_files: - split: train path: data/train-* ---
提供机构:
DCAgent3搜集汇总
数据集介绍
构建方式
该数据集立足于智能体工具调用能力评测的前沿需求,以bfcl(Berkeley Function Calling Leaderboard)基准为蓝本,通过RL(强化学习)训练范式诱导DCAgent在沙盒环境中生成带有推断性缺陷的对话轨迹。构建流程将55类任务模板注入8B规模的语言模型,由智能体在隔离沙盒内自主执行多轮交互,并借助独立验证器对每一回合的结果进行二值化判定。全部369条训练样本均来源于DCAgent与验证器协同运作的流水线,每条轨迹包含完整的角色-内容对话序列及其对应的验证器输出,确保数据在缺陷注入与正确性核验之间形成闭环。
特点
该数据集的核心特质在于将函数调用、强化学习与缺陷推断三者有机融合,呈现出鲜明的诊断性特征。数据结构以conversations字段承载多轮对话,辅以agent、model、model_provider、date、task、episode、run_id、trial_name、result及verifier_output等元信息,构成层次分明的记录体系。样本规模为369条,体量适中而信息密度高,每一条轨迹均经历过沙盒环境的真实执行与验证器的严格审查,能够精确刻画模型在工具调用过程中产生的推断性错误模式,为智能体鲁棒性研究提供细粒度素材。
使用方法
研究者可通过HuggingFace datasets库以标准方式加载该数据集,调用load_dataset函数并指定配置名default与train划分,即可获取包含对话、模型标识、任务类型及验证器反馈的完整记录。使用时既可依托conversations字段开展监督微调或对话行为分析,亦可结合verifier_output与result字段进行错误归因与奖励建模,服务于强化学习策略的迭代优化。该数据集适用于函数调用能力评估、智能体缺陷诊断以及基于验证器的训练信号构造等场景,为相关研究提供可直接复用的结构化语料。
背景与挑战
背景概述
在人工智能体与工具调用能力评估的研究浪潮中,BFCL(Berkeley Function Calling Leaderboard)系列基准为衡量大语言模型调用外部函数的能力提供了关键标尺。该数据集衍生自BFCL的平行验证任务,聚焦于RL训练中DCAgent在多沙箱环境下的推理缺陷检测。其构建依托于自动化验证流水线,通过为每个任务配置独立沙箱与验证器,采集了369条涵盖多轮对话、模型信息与验证器输出的完整轨迹。该数据集致力于揭示智能体在函数调用中的推理偏差与错误传播模式,为提升模型工具使用的鲁棒性提供了诊断性资源,对智能体评估与强化学习训练领域具有参考价值。
当前挑战
函数调用任务本身要求模型在动态环境中精准解析意图、规划调用序列并处理执行反馈,而沙箱化验证进一步引入了环境隔离、状态管理与错误归因的复杂性。构建过程中,自动化流水线需在有限资源下协调多模型、多提供商的异构输出,确保验证器对推理缺陷的判定兼具一致性与细粒度,同时避免轨迹记录中的噪声与偏差。数据规模的有限性也制约了统计推断的稳健性。此外,如何将验证器输出转化为可泛化的训练信号,以缓解智能体在长程任务中的错误累积,仍是亟待突破的难点。
常用场景
经典使用场景
在智能体评估与强化学习研究领域,该数据集聚焦于函数调用基准测试中的奇偶校验任务,通过多轮对话形式记录智能体的推理过程与验证器输出。经典使用场景在于构建沙箱环境,令语言模型智能体在受限条件下完成代码生成、错误推断与自我修正等交互任务,从而系统性地考察其逻辑一致性与工具调用能力。
实际应用
该数据集在实际应用中可服务于智能体系统的开发迭代,例如用于训练和评测代码修复智能体、自动化测试生成器以及多步推理代理。工程团队可借助其验证器输出与沙箱记录,定位模型在工具调用中的薄弱环节,进而优化提示策略、微调模型或改进验证机制,提升智能体在真实软件环境中的可靠性。
衍生相关工作
围绕该数据集,后续研究可能衍生出针对智能体错误推断的强化学习微调工作、基于验证器反馈的奖励模型训练,以及多智能体协作完成函数调用任务的基准扩展。这些工作进一步丰富了函数调用领域的评测生态,并为沙箱环境下智能体安全性与鲁棒性的研究提供了可复用的数据基础。
以上内容由遇见数据集搜集并总结生成


